Escalar uma plataforma PropTech moderna exige acesso em tempo real a registros de imóveis, modelos de avaliação e delimitações de lotes. No entanto, implementar uma integração Reapi direta em serviços web voltados ao cliente costuma introduzir latência significativa, atrito com rate limiting e sobrecarga de payload upstream. Quando os usuários solicitam consultas de lotes ou avaliações fiscais, aguardar respostas síncronas de APIs de terceiros degrada a capacidade de resposta e inflaciona os custos de infraestrutura.
Para alcançar tempos de resposta inferiores a um segundo, as equipes de engenharia devem migrar de consultas síncronas a APIs para um pipeline de dados assíncrono e desacoplado. Este guia técnico apresenta o modelo arquitetural para ingerir, normalizar e fazer o caching de dados de imóveis de âmbito nacional com eficiência, protegendo sua aplicação e mantendo a resiliência do sistema.
Por que a ingestão direta da Reapi está causando latência e gargalos no seu aplicativo PropTech?
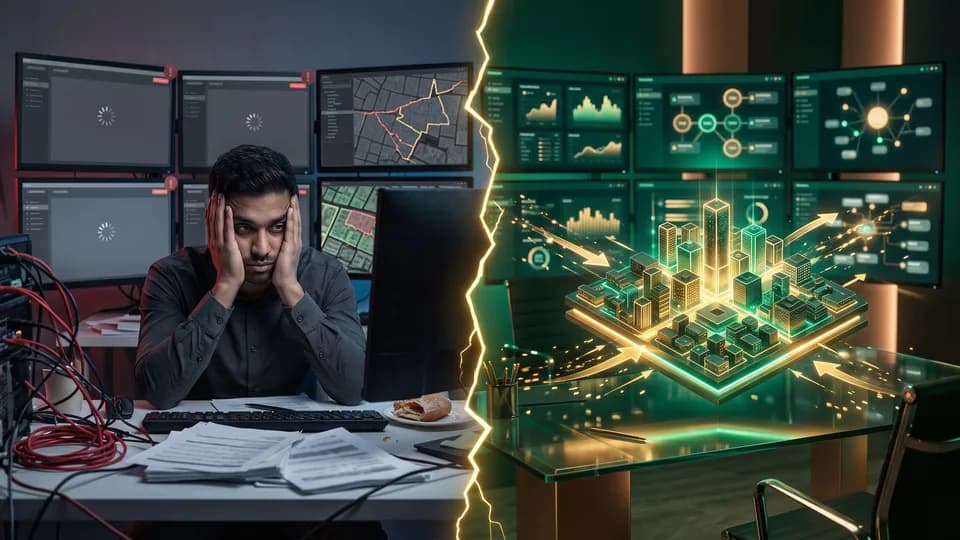
Vincular diretamente as requisições web dos clientes a endpoints upstream de dados de imóveis cria vulnerabilidades imediatas de desempenho. Quando as aplicações cliente consultam de forma síncrona registros de lotes em todo o país, avaliações fiscais ou históricos de escrituras imobiliárias, cada ação do usuário herda o overhead de rede upstream, a latência geográfica e os custos de serialização de payload. Mesmo os payloads padrão de registros de imóveis costumam conter dezenas de objetos aninhados, introduzindo atrasos de resposta de centenas de milissegundos durante períodos de pico de uso.
Conforme o tráfego cresce, os custos ocultos das chamadas síncronas se acumulam rapidamente. O rate limiting do provedor upstream restringe as consultas simultâneas dos clientes, gerando erros HTTP 429 em cascata, esgotamento do pool de threads e conexões perdidas. Quando os bancos de dados upstream enfrentam picos de carga, altas latências de cauda se propagam diretamente para a interface do usuário, frustrando os usuários finais e prejudicando a retenção de clientes.
Entender como implementar integração reapi com eficácia exige solucionar esses gargalos operacionais no nível arquitetural. Uma integração Reapi resiliente nunca expõe as interfaces do cliente diretamente à volatilidade upstream; em vez disso, estabelece uma camada intermediária de ingestão que isola as dependências externas da capacidade de resposta da plataforma principal.
Qual base arquitetural um pipeline de dados de imóveis escalável exige?
Construir um sistema PropTech de alta capacidade exige uma separação clara de responsabilidades entre a camada de aplicação e os provedores de dados upstream. Uma robusta arquitetura de integração de api imobiliária isola as consultas a registros públicos dos ciclos de vida das requisições no frontend, garantindo que as interações dos usuários mantenham um alto desempenho mesmo quando serviços terceirizados upstream apresentarem latência variável.
Desacoplamento de endpoints voltados ao usuário da busca externa de dados
Para proteger as aplicações clientes, as requisições dos usuários devem consultar um datastore interno ou uma camada de caching, em vez de disparar chamadas HTTP diretas para fornecedores externos. Quando um usuário navega até o perfil de um imóvel, sua camada de apresentação lê registros canônicos locais instantaneamente. Se o registro estiver ausente, expirado ou com enriquecimento pendente, a plataforma retorna imediatamente os metadados básicos disponíveis, enquanto enfileira tarefas de sincronização em segundo plano.
Esse desacoplamento evita que o jitter da rede externa degrade as interfaces dos usuários, elimina timeouts em cascata e protege os servidores web contra o rate limiting de terceiros. Na Canvas Developers, nossos engenheiros estruturam essas interfaces por meio de pipelines personalizados de desenvolvimento de APIs, garantindo alta disponibilidade e um desempenho previsível de consultas em portais imobiliários de alto volume.
Selecionando a topologia de ingestão correta: Gateway síncrono vs. filas orientadas a eventos
A escolha de uma topologia de ingestão determina a eficiência com que seu sistema escala sob carga. Gateways de API síncronos atendem a necessidades simples de proxy, mas entram em colapso sob picos de processamento em lote ou lentidões intermitentes upstream. Por outro lado, uma arquitetura assíncrona orientada a eventos, impulsionada por filas de mensagens (como RabbitMQ, Kafka ou AWS SQS), amortece as cargas de trabalho de ingestão e impõe controles rigorosos de concorrência.
Um pipeline de dados reapi de imóveis assíncrono despacha pools de workers para consumir jobs de ingestão a taxas determinísticas, respeitando as cotas do provedor enquanto absorve picos repentinos de tráfego. Rotinas de workers gerenciam retentativas, intervalos de backoff e transformações de payload de forma independente, garantindo que a capacidade de resposta da plataforma permaneça estável, independentemente de oscilações na rede upstream.
Como implementar um pipeline de dados resiliente de ingestão e normalização de schema para a integração Reapi?
Um pipeline de dados de imóveis abrangente deve processar registros fiscais de todo o país, registros de escrituras e geometrias de lotes sem esgotar a memória do sistema ou a largura de banda da rede. Seguir a abordagem de um tutorial de integração Reapi estruturado garante que a ingestão de dados permaneça previsível e resiliente contra a variabilidade de schemas entre diferentes jurisdições.
Ingestão eficiente de dados de lotes em escala nacional e registros fiscais de condados
Os conjuntos de dados de registros fiscais de condados e de delimitações de lotes abrangem milhões de lotes em todo o país, cada um apresentando particularidades jurisdicionais distintas. Consultar esses conjuntos massivos de dados exige minimizar o tamanho do payload por meio de modos de consulta seletivos. De acordo com a documentação da RealEstateAPI, utilizar modos de consulta especializados, como ids_only, permite que os sistemas obtenham primeiro identificadores leves de imóveis antes de recuperar a estrutura completa dos registros.
Ao trabalhar com uma api de dados de imóveis da Reapi em escala nacional, os workers de ingestão devem paginar por meio de cursores determinísticos, armazenando os IDs de lotes em buffer em batches segmentados. Esses batches podem então ser hidratados de forma assíncrona por meio de endpoints de detalhes em massa, evitando que grandes polígonos GeoJSON e históricos extensos de avaliações fiscais bloqueiem a thread de ingestão.
Transformação de atributos heterogêneos de imóveis em um schema canônico interno
Os registros públicos têm origem em milhares de avaliadores de condados que utilizam convenções de nomenclatura, formatos de data e definições de zoneamento divergentes. Por exemplo, a metragem quadrada pode ser indicada como área bruta, área útil ou área aquecida, dependendo dos padrões do condado. Salvar payloads brutos diretamente no banco de dados principal da sua aplicação acopla fortemente a sua lógica de domínio a estruturas de dados de terceiros.
Em vez disso, os workers de ingestão devem executar uma etapa intermediária de transformação que normaliza atributos brutos em um modelo canônico interno. Um registro de imóveis unificado deve estabelecer schemas consistentes para:
- Coordenadas geográficas: Coordenadas padronizadas de latitude e longitude em WGS84 combinadas com delimitações de lotes normalizadas.
- Avaliação e valor venal: Valores separados para valor do terreno, valor de benfeitorias, valor venal total avaliado e respectivos registros fiscais de avaliações.
- Metadados estruturais: Contagens normalizadas para quartos, banheiros, metragem quadrada bruta e ano de construção.
Estratégias defensivas de parsing para proteger sistemas contra variações no schema upstream
As APIs upstream ajustam periodicamente os payloads de resposta, introduzem campos opcionais ou retornam valores nulos inesperados quando os registros de condados não contêm divulgações específicas. Desenvolvedores que aprendem como implementar a integração Reapi em escala devem adotar uma desserialização defensiva utilizando bibliotecas de validação de schema como Pydantic, Zod ou JSON Schema.
A tipagem estrita na fronteira de ingestão garante que tipos inesperados — como avaliações numéricas codificadas como strings ou arrays ausentes — sejam interceptados e convertidos imediatamente. Se um payload violar regras críticas de validação, o worker encaminha o registro anômalo para uma dead-letter queue (DLQ) para alertas, permitindo que a sincronização mais ampla do lote continue sem interrupções.
Como Otimizar o Caching e a Sincronização Assíncrona de Dados para Respostas em Subsegundos?
Alcançar tempos de resposta inferiores a um segundo em portais imobiliários exige desacoplar o armazenamento persistente dos caminhos de recuperação em tempo real. Uma arquitetura de integração de api imobiliária madura combina caches com velocidade de memória, bancos de dados relacionais indexados e filas de sincronização em segundo plano para entregar visões gerais imediatas de imóveis sem sobrecarregar as APIs de fornecedores externos.
Estruturando o Caching em Múltiplas Camadas entre Redis e Armazenamento Relacional
Uma hierarquia de caching em múltiplas camadas separa as demandas de leitura de alta frequência das cargas de consultas relacionais. Nessa topologia, armazenamentos de dados em memória como o Redis atuam como o cache L1 para registros de imóveis acessados com frequência, coordenadas de limites e cards de resumo. O Redis armazena payloads JSON serializados indexados por identificadores padronizados de parcelas ou APNs, fornecendo respostas na faixa de milissegundos de um único dígito.
O PostgreSQL ou MySQL atua como o datastore durável L2, armazenando entidades relacionais normalizadas, índices de endereços para busca textual e eventos históricos de escrituras. Quando uma aplicação consulta um anúncio, o serviço verifica o Redis primeiro. Em caso de cache miss, ele busca o registro canônico no PostgreSQL, preenche o cache do Redis com um tempo de expiração definido e retorna o payload ao cliente. Essa estrutura em camadas protege tanto os bancos de dados primários quanto as APIs upstream contra picos de leitura.
Gerenciando TTLs e Invalidação Seletiva para Registros Públicos em Rápida Mudança
Os dados imobiliários apresentam volatilidade variada entre diferentes atributos. Atributos estáticos como delimitações de lotes, metragem do terreno e avaliações fiscais históricas mudam com pouca frequência, sendo atualizados normalmente uma vez ao ano durante os ciclos fiscais do condado. Por outro lado, status de listagens MLS, preços pedidos e marcadores de venda contingente oscilam rapidamente ao longo do dia.
Para equilibrar atualização e custo dentro do seu pipeline de dados reapi de imóveis, defina limites diferenciados de time-to-live (TTL) entre as camadas de dados:
- Registros Públicos Estáticos: Faça caching de geometrias de lotes, escrituras históricas e registros de avaliação fiscal por 14 a 30 dias.
- Avaliações Fiscais e Gravames: Faça caching de cobranças fiscais anuais e registros de gravames por 7 a 14 dias, considerando seus cronogramas deliberados de registro.
- Status Dinâmicos de MLS: Aplique TTLs reduzidos de 15 a 60 minutos, combinados com hooks de invalidação orientados a eventos sempre que novos registros de alterações forem ingeridos.
Orquestrando Workers de Sincronização em Segundo Plano com Controle de Concorrência e Rate Throttling
Os workers em segundo plano devem ingerir dados sistematicamente, sem ultrapassar as cotas do fornecedor ou esgotar os pools de conexões do banco de dados local. Processadores de tarefas assíncronas (como Celery, BullMQ ou Sidekiq) coordenam os workers utilizando limitadores de rate limiting do tipo token bucket distribuído ou leaky bucket.
Quando atualizações em lote são disparadas, os workers buscam as atualizações de imóveis em envelopes de concorrência controlados. Se um serviço upstream responder com alertas de rate limiting ou códigos de status HTTP 429, o backoff exponencial com jitter pausa as requisições de saída dinamicamente. Essa orquestração garante que a sincronização de dados em segundo plano ocorra de forma contínua, sem causar interrupções de serviço para os usuários ativos da plataforma.
Quais São os Principais Trade-Offs Técnicos Entre Polling, Webhooks e Código Acelerado por IA?
Projetar uma integração corporativa exige equilibrar os mecanismos de ingestão com a velocidade de desenvolvimento. Ao estabelecer uma robusta arquitetura de integração de api imobiliária, as equipes técnicas precisam decidir entre a sincronização push e pull, aproveitando a engenharia moderna assistida por IA com segurança.
Streaming de Eventos via Webhooks vs. Sincronização em Lote Agendada: Confiabilidade e Recuperação de Falhas
Atualizações em tempo real costumam sugerir um modelo de webhooks baseado em eventos, mas os registros públicos de imóveis nem sempre enviam alterações de forma instantânea. Onde disponível, uma resiliente implementação de reapi webhooks ou um listener de eventos externo oferece menor latência para alterações de status de imóveis. No entanto, os webhooks exigem verificação de assinatura, handlers de consumo idempotentes e buffers de replay para evitar a execução fora de ordem.
Por outro lado, o polling em lote agendado oferece um planejamento determinístico de recursos e custos previsíveis com a API. Ao rastrear timestamps de cursor e limites de consultas, workers agendados varrem registros atualizados sem expor endpoints HTTP de entrada ao tráfego público da web. Para a ingestão de dados em larga escala, combinar varreduras em lote horárias para registros volumosos com listeners de webhooks direcionados para alertas urgentes de anúncios oferece o equilíbrio ideal entre confiabilidade e sobrecarga de infraestrutura.
O Que as Ferramentas de Código com IA Aceleram em Pipelines de Integração vs. O Que os Engenheiros Devem Arquitetar
Os fluxos de trabalho modernos de engenharia utilizam cada vez mais agentes de codificação com IA para acelerar tarefas rotineiras de integração. As ferramentas de IA se destacam no scaffolding de camadas boilerplate de acesso a dados, na geração de schemas repetitivos de serialização JSON e na criação de suítes iniciais de mocks para endpoints upstream. Em nosso fluxo de trabalho de engenharia na Canvas Developers, as equipes usam scaffolding assistido por IA e ferramentas iterativas como o Antigravity para construir DTOs e modelos de parsers iniciais com rapidez.
No entanto, o código gerado por IA não pode substituir o rigor arquitetural fundamental. Os modelos de IA frequentemente deixam passar modos de falha sutis, como condições de corrida distribuídas, cache stampedes e casos extremos em registros públicos de lotes. Engenheiros experientes devem direcionar a arquitetura, revisar cada commit e conduzir auditorias rigorosas em segurança, armazenamento criptográfico de credenciais, integridade de dados e escalabilidade do pipeline antes de liberar o código para produção.
Quais são as armadilhas mais críticas a evitar na integração de API imobiliária em produção?
Implantar uma API de dados de imóveis em produção expõe as arquiteturas de integração a diversos riscos operacionais. Interrupções no provedor upstream, desvios inesperados de schema de condados e rotinas de polling não otimizadas podem degradar rapidamente a experiência do usuário e inflacionar a fatura mensal da API.
Um pipeline de dados Reapi resiliente deve lidar com falhas parciais de forma suave. Quando endpoints de lotes de terceiros enfrentam indisponibilidades temporárias ou rate limiting, a implementação de padrões de circuit breaker garante que sua aplicação degrade de forma suave, fornecendo registros de referência em caching em vez de falhar completamente. Registros com falhas de parsing ou anomalias inesperadas de schema devem ser encaminhados diretamente para dead-letter queues, alertando as equipes de engenharia sem interromper os lotes de ingestão ativos.
Outra armadilha frequente é o consumo descontrolado de cotas causado por chamadas em lote redundantes. Ao aprender como implementar integração Reapi com eficácia, as equipes de engenharia devem adotar hashing de consultas e deduplicação de IDs antes de disparar buscas detalhadas. Antes de enviar requisições de enriquecimento em massa, os workers devem verificar os timestamps no caching local para evitar pagar por registros de imóveis inalterados.
Antes de colocar sua integração Reapi em produção, verifique estas salvaguardas operacionais:
- Circuit Breakers: Fallback automático para registros em caching durante interrupções no upstream.
- Payload Deduplication: Coalescência de requisições em trânsito para eliminar consultas externas duplicadas.
- Schema Insulation: Parsing rigoroso de limites com filas isoladas para campos não mapeados.
- Quota Monitoring: Alertas em tempo real sobre o consumo de créditos para evitar cobranças excedentes.
Como definir o escopo e executar seu próximo marco de integração Reapi?
Executar com sucesso uma integração Reapi corporativa exige estruturar a entrega em marcos distintos e gerenciáveis. Em vez de tentar uma implementação monolítica, as equipes de engenharia devem dividir o lançamento em três etapas fundamentais: ingestão inicial de schema e buffer de rate limiting, robustecimento de caching e workers assíncronos, e testes de integração de ponta a ponta com entrega para produção.
Na Canvas Developers, nossos engenheiros combinam scaffolding assistido por IA para geração ágil de schemas e clientes com uma rigorosa supervisão humana em arquitetura, integridade de dados e auditorias de segurança. Quer você esteja criando uma nova iniciativa PropTech por meio dos nossos serviços de desenvolvimento de MVP SaaS ou escalando a arquitetura de integração de api imobiliária de uma plataforma existente, nossa equipe ajuda a estabilizar e robustecer pipelines de dados de alto volume.
Se você planeja fazer a ingestão de registros fiscais e de lotes em escala nacional, inicie uma avaliação de escopo de integração por meio do nosso formulário de contato informando sua stack de tecnologia atual, restrições de ingestão de dados e objetivos de desempenho.