Enterprise document search kampt vaak met gefragmenteerde antwoorden, verloren tabelopmaak en breekbare vectorpipelines bij het bevragen van complexe beleidshandboeken, technische specificaties en juridische dossiers. Een long context window Gemini integratie verandert dit paradigma fundamenteel doordat engineeringteams complete documentcorpora—tot twee miljoen tokens in Gemini 1.5 Pro—rechtstreeks in het actieve attention window van het model kunnen inladen. In plaats van te vertrouwen op verlieslatende tekst-chunking en heuristieken voor semantische similariteit, kunnen organisaties diepgaande redeneringen uitvoeren over omvangrijke referentiebibliotheken met een nagenoeg perfecte feitelijke precisie (factual recall), verifieerbare citaties en volledige structurele context.
Waarom traditionele RAG-pipelines falen bij complexe enterprise-documenten
Een standaard enterprise document search architectuur leunt vaak op retrieval-augmented generation (RAG)-pipelines die bestanden inlezen door tekst op te splitsen in willekeurige token-chunks. Waar dit effectief is voor eenvoudige vraag-antwoordsystemen op ongestructureerde artikelen, introduceert deze aanpak acute faalmechanismen zodra hij wordt toegepast op compacte technische specificaties, toezichtsdocumenten, financiële grootboeken en geneste contracten.
De faalmechanismen van chunking, embedding en metadata-extractie
Traditionele chunking-strategieën — of ze nu gebaseerd zijn op een vaste grootte, recursie of zinnen — doorbreken stelselmatig de syntactische en semantische samenhang van complexe documenten. Tabellen verliezen hun kolomkoppen over chunk-grenzen heen, financiële berekeningen over meerdere pagina's raken losgekoppeld van hun toelichtende voetnoten, en geneste lijsten verliezen hun hiërarchische parent-nodes. Bovendien comprimeren embedding-modellen honderden woorden tot één enkele dense vector, waardoor fijnmazige nuances, numerieke waarden en specifieke clausulevoorwaarden effectief vervagen. Wanneer engineeringteams lagen voor metadata-extractie bouwen om dit verlies op te vangen, resulteert dit in breekbare pipelines: maatwerk-extractors vergen continu onderhoud doordat lay-outs van brondocumenten verschuiven.
Waar vectorsimilariteit cross-document context en structureel redeneren verliest
Vector search berekent de cosinussimilariteit tussen een query-embedding en geïsoleerde chunk-vectoren, en haalt uitsluitend de top-k dichtstbijzijnde fragmenten op. Dit retrievalmechanisme schiet tekort bij vragen die vragen om een globale synthese of structurele deducties over niet-aaneengesloten passages, zoals het identificeren van tegenstrijdige aansprakelijkheidsclausules in verschillende leveranciersovereenkomsten. In het debat rond rag vs gemini long context window-architecturen ontbreekt het geïsoleerde chunks aan cross-document awareness. Wanneer een antwoord afhangt van het reconciliëren van drie afzonderlijke secties in een handleiding van 200 pagina's, laat top-k retrieval vaak tussenliggende premissen vallen, waardoor modellen plausibele verbanden hallucineren om ontbrekende feiten te overbruggen.
Hoe long context window Gemini integratie breekbare RAG vervangt
Moderne generatieve systemen hebben niet langer complexe tekst-chunking-heuristieken nodig om referentiedocumenten van meerdere megabytes te bevragen. Met een long context window Gemini integratie kunnen developmentteams omvangrijke bestanden rechtstreeks in de promptcontext laden, waardoor gelaagde retrieval-stacks worden vervangen door directe neurale aandacht.
Vectordatabases omzeilen met Gemini's 2M-token window
Het beheren van een enterprise vectordatabase vereist het onderhouden van embedding-modellen, ingestion workers, chunk-indexeringswachtrijen, synchronisatietaken en herberekeningen van vectorafstanden. Zoals beschreven in de Google Cloud long context-documentatie ondersteunen Gemini-modellen tot 2 miljoen tokens in Gemini 1.5 Pro, waarbij ze een nagenoeg perfecte retrieval-nauwkeurigheid van meer dan 99% aantonen over omvangrijke tokenreeksen. In deze gemini 2 miljoen token context gids elimineren engineeringteams vector stores door volledige documentatiestructuren, code repositories of beleidsbibliotheken rechtstreeks in het geheugen te laden. Het verwijderen van vectorindices elimineert vector drift, niet-gesynchroniseerde database-replica's en scripts voor het opnieuw opbouwen van indexen wanneer brondocumentatie wordt bijgewerkt.
Whole-corpus-ingestie vs. verlieslatende top-k semantische retrieval
Wanneer een volledige documentcollectie zich binnen het actieve context window bevindt, voert het model gelijktijdig cross-attention uit over alle tokens. In plaats van te vertrouwen op top-k cosinus-similariteitsheuristieken om te raden welke drie alinea's mogelijk een antwoord bevatten, evalueert Gemini relaties tussen uiteenlopende hoofdstukken, tabellarische bijlagen en historische amendementen. Als een enterprise master service agreement bijvoorbeeld een indemnity cap definieert op pagina 12 en deze onder specifieke garantievoorwaarden overschrijft op pagina 84, garandeert whole-corpus-ingestie dat beide clausules samen in context worden geparseerd. Bij Canvas Developers maken onze engineers gebruik van ontwerppatronen voor LLM-integratie die de ruwe documentstructuur behouden—inclusief markdown-tabellen, XML-tags en documenthiërarchieën—waardoor het model kan redeneren over complete semantische landschappen zonder verlieslatende samenvatting.
Enterprise document search architectuur met de Gemini API
Het bouwen van een robuust search- en retrieval-systeem bovenop de generatieve modellen van Google vereist een zorgvuldig payload-ontwerp en runtime cache-orkestratie. Door corpus-ingestie los te koppelen van inferentie per verzoek, kunnen teams ruwe bestanden omzetten in responsieve enterprise intelligence.
Multi-document payloads en systeeminstructies structureren
Bij het orkestreren van enterprise document processing gemini api-workflows moeten document-payloads zo worden geformatteerd dat semantische grenzen en herkomst behouden blijven. In plaats van ruwe tekst samen te voegen tot een ongestructureerde stroom, plaatsen engineers documenten tussen duidelijke structurele scheidingstekens, zoals XML- of Markdown-fences met specifieke attributen: <document id="hr-policy-202" category="compliance">. Systeeminstructies moeten expliciet worden gedefinieerd om te bepalen hoe het model dit corpus doorzoekt. Strikte gedragsrichtlijnen instrueren het model om elke bewering te baseren op een geverifieerde document-identifier, alinea- of sectiemarkeringen te citeren en expliciet aan te geven wanneer een antwoord niet kan worden bepaald op basis van de ingeladen materialen. Deze structurering neemt ambiguïteit weg, dwingt deterministische citaties af en voorkomt gehallucineerde extrapolaties binnen bedrijfsdocumenten.
Gemini context caching implementeren voor herbruikbare referentie-corpora
Het meesturen van een payload van 500.000 tokens bij elke gebruikersprompt leidt tot aanzienlijke financiële overhead en latency. Het Google AI-ontwikkelaarsplatform lost dit op via expliciete context caching, zoals beschreven in de Gemini API context caching-documentatie. Door expliciete caching via client.caches.create uploaden engineeringteams een zakelijke referentiebibliotheek één keer, configureren ze een Time-To-Live (TTL, standaard 60 minuten) en verkrijgen ze een herbruikbare cache-identifier. Daaropvolgende queries verwijzen naar deze gecachete token-prefix tegen een fractie van de standaard inputtoken-tarieven, waarbij de gemini context caching kosten bestaan uit een opslagtarief per uur per miljoen tokens zolang de cache actief blijft.
Context caching biedt tevens een oplossing voor uitdagingen rond gemini 1.5 pro large context latency. Zonder caching moet het model bij de verwerking van honderdduizenden invoertokens voor elke aanroep vanaf nul key-value (KV) attention maps berekenen, waardoor time-to-first-token (TTFT) statistieken oplopen tot tientallen seconden. Context caching bewaart de vooraf berekende KV-tensoren in het accelerator-geheugen, waardoor de first-token latency in high-throughput zoekscenario's daalt tot responstijden van minder dan een seconde of enkele seconden. Bij Canvas Developers automatiseren onze engineers cache warm-up- en TTL-verlengingsroutines via op maat gemaakte cloud infrastructure-pipelines, zodat referentie-corpora ook tijdens piekmomenten van de bedrijfsvoering hot blijven.
Kosten- en latency-economie: RAG vs. Gemini long context window met caching
Het evalueren van de economische aspecten van een enterprise document search architectuur vereist een grondige analyse van zowel de infrastructurele overhead als de operationele kosten per query. Hoewel traditionele vector-pipelines op het gebied van puur tokenverbruik voordelig lijken, leidt het onderhouden van dedicated indexeringsclusters vaak tot aanzienlijke operationele frictie vergeleken met een long context window gemini integratie met caching.
Gemini context caching kosten vs. TCO van dedicated vectordatabases
Een vector search-stack in productie brengt een aanzienlijke total cost of ownership (TCO) met zich mee. Engineeringteams moeten dedicated vectordatabase-instanties, ingestion workers, pipelines voor embedding-berekeningen en herindexeringsinfrastructuur inrichten en onderhouden. Wanneer bronbeleidsdocumenten of technische handleidingen wijzigen, moeten collecties tekstchunks ongeldig worden verklaard, opnieuw worden ge-embed en opnieuw worden geïndexeerd over de vectorclusters heen. Daarentegen worden de kosten volgens de officiële prijsstructuren voor Gemini API context caching overzichtelijk opgesplitst in cache-opslag en gereduceerde query-inference. Gebruikers betalen een opslagtarief per uur per miljoen tokens naast de standaardkosten voor promptcreatie, terwijl opvolgende queries die de gecachte context aanspreken een korting van 75% tot 90% krijgen op de kosten voor input-tokens. Voor hoogfrequente enterprise-workflows waarbij teams gedurende de werkdag herhaaldelijk dezelfde compliance-bibliotheek of productcatalogus raadplegen, leveren de gemini context caching kosten voorspelbare uitgaven op, terwijl het onderhoud van databaseclusters volledig overbodig wordt.
Latency-profielen voor werksets van 100K tot 2M tokens
De query-latency in modellen met een long context window correleert direct met de promptlengte en de caching-status. Niet-gecachte verzoeken over grote tokendatasets dwingen het model om key-value (KV) attention-matrices vanaf nul opnieuw te berekenen, wat leidt tot time-to-first-token (TTFT)-vertragingen die meeschalen met het promptvolume. Bij een niet-gecachte payload van 100.000 tokens blijft de latency beheersbaar voor batchanalyses, maar opschalen naar een volledige werkset van 2.000.000 tokens kan de niet-gecachte TTFT doen oplopen tot tientallen seconden. Context caching verandert deze latency-profielen fundamenteel door vooraf berekende KV-statussen in het acceleratorgeheugen te bewaren, waardoor de TTFT voor werksets van 500.000 tot 1.000.000 tokens daalt tot responstijden van slechts enkele seconden.
Bij het afwegen van de trade-offs van rag vs gemini long context window-architecturen doen organisaties die tientallen miljoenen historische tokens beheren er goed aan een hybride retrieval-patroon te overwegen. In plaats van te proberen contexten van meerdere miljoenen tokens voor onbepaalde tijd aan te houden, gebruiken teams deterministische metadatafiltering of lichte lexicale indexering om een gericht referentiecorpus van 500.000 tokens te selecteren, dat vervolgens in een gecachte Gemini-sessie wordt geladen voor diepgaande redeneringen met hoge precisie.
Implementatierisico's voor enterprises: wat AI-coding niet alleen oplost
Het versnellen van de ontwikkeling met autonome coding agents stelt teams in staat om snel prototypes te bouwen voor een long context window gemini integratie, maar het genereren van code via prompts biedt geen garantie voor veerkracht op enterpriseniveau. Het ontwerpen van een document retrieval-systeem voor productie vereist gedisciplineerd toezicht door menselijke engineers.
Waar AI-coding de oplevering versnelt en waar geautomatiseerde code faalt
Binnen moderne engineeringteams versnellen AI coding agents en harnesses zoals Antigravity het genereren van initiële boilerplate, de scaffolding van API-clients en het creëren van testsuites. Bij een enterprise document processing gemini api-implementatie blinken geautomatiseerde coding tools uit in het genereren van getypeerde schemabindingen, het structureren van JSON-payloads en het stubben van mock-endpoints. Geautomatiseerde codegeneratie faalt echter bij het oplossen van complexe concurrency-condities, het beheren van gedistribueerde state of het ontwerpen van veerkrachtige back-offs voor rate-limiting. AI-assistenten genereren regelmatig naïeve retry-loops die cascaderende request-pieken richting upstream API-quota veroorzaken, of schrijven context caching-routines die geruisloos geheugen lekken wanneer loops voor cachevernieuwing falen. Bij Canvas Developers versnellen AI-tools de oplevering, terwijl ervaren engineers het werk aansturen, de systeemarchitectuur beheren, elke commit reviewen en de definitieve releasebeslissingen nemen.
Must-haves voor menselijke verificatie: tenant-isolatie, toegangscontroles en databeveiliging
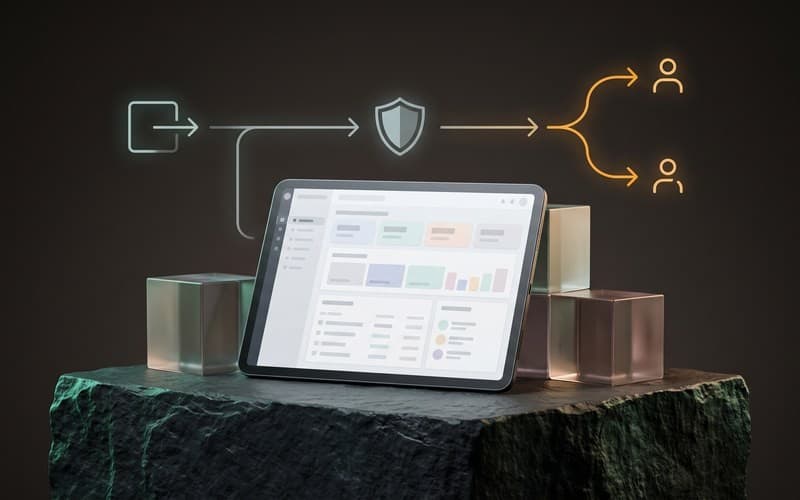
Een veilige enterprise document search architectuur moet strikte grenscontroles afdwingen voordat een document een LLM-context binnenkomt. Geautomatiseerde codegeneratie kan compliance binnen organisaties of de integriteit van multi-tenant-grenzen niet verifiëren. Menselijke engineers moeten drie cruciale beveiligingslagen ontwerpen en rigoureus testen:
- Tenant-isolatie: Het voorkomen van databesmetting tussen tenants door cache-ID's strikt te koppelen aan cryptografisch gevalideerde enterprise tenant-tokens, waardoor wordt voorkomen dat onbevoegde gebruikers toegang krijgen tot gecachte contexten.
- Attribute-Based Access Control (ABAC): Waarborgen dat documenten worden gefilterd op basis van de permissies van de aanroeper vóór de context-assemblage, zodat vertrouwelijke documenten over directiebeloningen of juridische dossiers nooit worden blootgesteld in gedeelde caches.
- Veerkracht in productie en graceful fallback: Het afhandelen van cache-evictie (wanneer een TTL verloopt tijdens langdurige query's) via geautomatiseerde pipelines voor cache-herstel, en het implementeren van exponential backoff bij het stuiten op rate limits van de Gemini API.
Om zekerheid te verkrijgen voor ingebruikname in productie, moeten engineeringteams een domeinspecifieke acceptatiechecklist hanteren: het valideren van tenant-grenzen onder gelijktijdige belasting (concurrent load), het uitvoeren van geautomatiseerde prompt-injectietests, het verifiëren van payload-redactie van gevoelige persoonsgegevens (PII), en het bevestigen van een sub-seconde fallback wanneer gecachte sessies verlopen.
Uw Gemini Search in productie nemen: scoping van de architectuur en vervolgstappen
De overstap van experimentele notebooks naar een gehard zoekplatform vereist het selecteren van een architectuurpatroon dat aansluit op uw security-posture en de randvoorwaarden voor datagovernance. Organisaties die een long context window gemini integratie evalueren, kiezen op basis van compliance-eisen doorgaans tussen twee engineering-leveringsmodellen:
Voor streng gereguleerde sectoren met strikte data residency-mandaten rolt een Private / Local AI Engineering-workflow modellen rechtstreeks uit binnen infrastructuur die de klant zelf beheert, of binnen een overeengekomen geïsoleerde cloud-tenancy. Voor enterprise-softwareproducten die prioriteit geven aan snelle feature-releases, benut een commerciële cloud-workflow—zoals ons Claude Code / OpenAI Codex Engineering-model—commerciële AI-API's met vooraf goedgekeurde beveiligingsgrenzen en geautomatiseerde verificatie-harnesses. In beide modellen verkort AI-ondersteunde scaffolding de initiële feedbackloops, terwijl ervaren engineers handmatige code-reviews uitvoeren en strikte acceptatiecriteria handhaven.
Canvas Developers bouwt, stabiliseert en hardt enterprise AI-zoeksystemen vanuit ons kantoor in Dhaka, en stuurt AI-coding agents aan onder strikt senior engineering-leiderschap. Trajecten starten met een transparante scopingfase en doorlopen overeengekomen mijlpalen, uitgebreide penetratietests en een formele overdracht. Als uw team overweegt om een breekbare vector-pipeline te vervangen of een bestaand prototype te harden, dien dan uw huidige technologiestack, documentvolume en prestatie-eisen in via ons contactformulier of bekijk onze LLM-integratiediensten om een afgebakend architectuur-assessment aan te vragen.