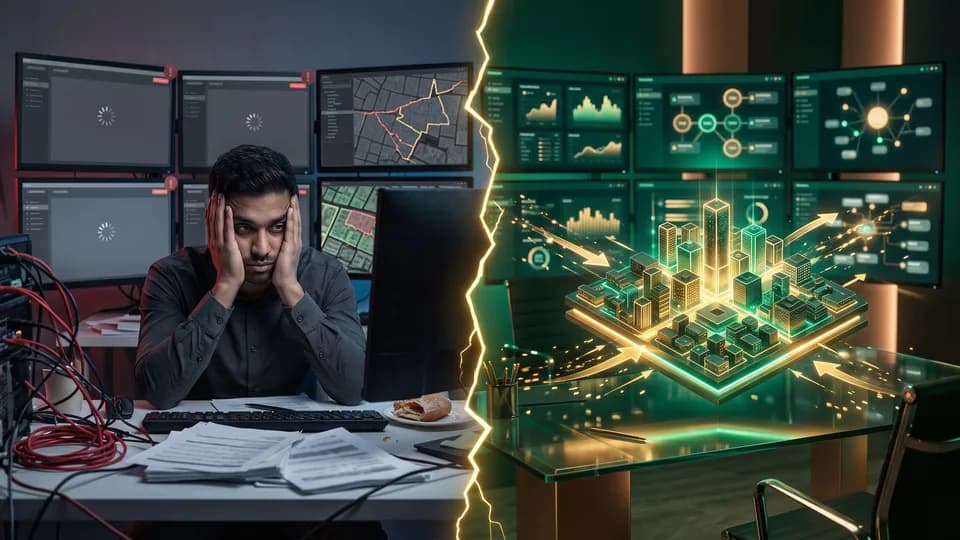
Die Skalierung einer modernen PropTech-Plattform erfordert den Echtzeitzugriff auf Immobiliendaten, Bewertungsmodelle und Flurstücksgrenzen. Die Implementierung einer direkten Reapi Integration in kundenorientierte Webservices führt jedoch häufig zu erheblichen Latenzen, Reibungsverlusten durch Rate-Limiting und vorgelagertem Payload-Bloat. Wenn Nutzer Flurstücksabfragen oder Steuerbewertungen anfordern, beeinträchtigt das Warten auf synchrone API-Antworten von Drittanbietern die Reaktionszeiten und treibt die Infrastrukturkosten in die Höhe.
Um Subsekunden-Antwortzeiten zu erzielen, müssen Entwicklungsteams von synchronen API-Abfragen zu einer asynchronen, entkoppelten Datenpipeline übergehen. Dieser technische Leitfaden beschreibt die architektonische Blaupause, um landesweite Immobiliendaten effizient zu erfassen, zu normalisieren und zwischenzuspeichern – wodurch Ihre Anwendung abgeschirmt und die Systemresilienz gewahrt bleibt.
Warum verursacht die direkte Reapi-Ingestion Latenzen und Engpässe in Ihrer PropTech-App?
Die direkte Anbindung von Webanfragen Ihrer Kunden an Upstream-Immobilien-Endpunkte führt zu unmittelbaren Performance-Schwachstellen. Wenn Client-Anwendungen landesweite Flurstücksdaten, Steuerbewertungen oder Eigentumshistorien synchron abfragen, erbt jede Nutzeraktion den Upstream-Netzwerk-Overhead, die geografische Latenz und die Kosten der Payload-Serialisierung. Selbst standardmäßige Immobiliendaten-Payloads umfassen häufig Dutzende verschachtelter Objekte, was zu Spitzenzeiten Antwortverzögerungen von mehreren hundert Millisekunden verursacht.
Mit steigendem Traffic summieren sich die versteckten Kosten synchroner Aufrufe rasant. Das Rate-Limiting des Upstream-Providers drosselt gleichzeitige Client-Abfragen, was zu kaskadierenden HTTP-429-Fehlern, einer Erschöpfung des Thread-Pools und abgebrochenen Verbindungen führt. Kommt es bei den Upstream-Datenbanken zu Lastspitzen, pflanzen sich hohe Tail-Latenzen direkt bis in Ihre Benutzeroberfläche fort – das frustriert Endnutzer und schadet der Kundenbindung.
Um zu verstehen, wie Sie eine Reapi-Integration implementieren, müssen diese operativen Engpässe an den Grenzen der PropTech-Architektur effektiv behoben werden. Eine resiliente Reapi-Integration setzt Client-Schnittstellen niemals direkt der Upstream-Volatilität aus; stattdessen etabliert sie eine intermediäre Ingestion-Schicht, die externe Abhängigkeiten von der Reaktionsfähigkeit der Kernplattform isoliert.
Welche architektonische Grundlage erfordert eine skalierbare PropTech Data Pipeline?
Der Aufbau eines durchsatzstarken PropTech-Systems erfordert eine saubere Trennung der Zuständigkeiten zwischen Ihrer Anwendungsschicht und vorgelagerten Datenanbietern. Eine robuste PropTech Architektur für die Reapi Integration isoliert Abfragen öffentlicher Immobiliendaten vom Request-Lebenszyklus des Frontends – eine solche Real Estate API Integration stellt sicher, dass Nutzerinteraktionen selbst dann performant bleiben, wenn vorgelagerte Drittanbieterdienste schwankende Latenzen aufweisen.
Entkopplung nutzerorientierter Endpunkte vom externen Datenabruf
Um Client-Anwendungen abzuschirmen, müssen Benutzeranfragen einen internen Datenspeicher oder eine Caching-Ebene abfragen, anstatt direkte HTTP-Aufrufe an externe Anbieter abzusetzen. Navigiert ein Nutzer zu einem Immobilienprofil, liest Ihre Präsentationsschicht lokale kanonische Datensätze sofort aus. Fehlt der Datensatz, ist er abgelaufen oder steht eine Datenanreicherung noch aus, liefert die Plattform unverzüglich verfügbare Basis-Metadaten zurück und reiht Synchronisierungsaufgaben im Hintergrund in die Warteschlange ein.
Diese Entkopplung verhindert, dass externer Netzwerk-Jitter die Benutzeroberflächen beeinträchtigt, eliminiert kaskadierende Timeouts und schützt Webserver vor dem Rate-Limiting von Drittanbietern. Bei Canvas Developers strukturieren unsere Ingenieure solche Immobilien API Schnittstellen über maßgeschneiderte Pipelines für die API-Entwicklung und gewährleisten so eine hohe Verfügbarkeit sowie vorhersehbare Abfrageleistungen auf stark frequentierten Immobilienportalen.
Die Wahl der richtigen Ingestion-Topologie: Synchrones Gateway vs. ereignisgesteuerte Queues
Die Wahl der Ingestion-Topologie entscheidet darüber, wie effizient Ihr System unter Last skaliert. Synchrone API-Gateways genügen für einfache Proxy-Anforderungen, brechen jedoch bei Lastspitzen durch Batch-Verarbeitungen oder zwischenzeitlichen Verlangsamungen der Upstream-Systeme ein. Im Gegensatz dazu puffert eine asynchrone, ereignisgesteuerte Architektur auf Basis von Message Queues (wie RabbitMQ, Kafka oder AWS SQS) Ingestion-Workloads ab und setzt strikte Kontrollen für die Nebenläufigkeit durch.
Eine asynchrone Datenpipeline für die Reapi-Integration von Immobiliendaten entsendet Worker-Pools, um Ingestion-Jobs mit deterministischer Geschwindigkeit abzuarbeiten, während sie Anbieterquoten einhält und plötzliche Traffic-Spitzen abfedert. Worker-Routinen wickeln Wiederholungsversuche, Backoff-Intervalle und Payload-Transformationen unabhängig voneinander ab und garantieren so, dass die Reaktionsfähigkeit der Plattform ungeachtet von Netzwerkschwankungen der Upstream-Systeme stabil bleibt.
Wie implementieren Sie eine resiliente Ingestion- und Schemanormalisierungs-Pipeline für Reapi?
Eine umfassende Datenpipeline für Immobiliendaten muss landesweite Steuerunterlagen, Grundbuchregister und Flurstücksgeometrien verarbeiten, ohne den Systemspeicher oder die Netzwerkbandbreite zu erschöpfen. Ein strukturierter Ansatz nach einem Reapi-Integration-Tutorial stellt sicher, dass die Daten-Ingestion vorhersehbar und gegenüber Schemavariabilitäten über verschiedene Jurisdiktionen hinweg resilient bleibt.
Effiziente Ingestion landesweiter Flurstücksdaten und County-Steuerunterlagen
County-Steuerdaten und Datensätze zu Flurstücksgrenzen umfassen landesweit Millionen von Flurstücken, die jeweils eigene regionale Besonderheiten aufweisen. Die Abfrage dieser gewaltigen Datensätze erfordert eine Minimierung der Payload-Größe durch selektive Abfragemodi. Laut der RealEstateAPI-Dokumentation ermöglicht der Einsatz spezialisierter Abfragemodi wie ids_only Systemen, zunächst schlanke Immobilien-IDs abzurufen, bevor vollständige Datensatzstrukturen geladen werden.
Bei der Arbeit mit einer Reapi Nationwide Parcel Data API sollten Ingestion-Worker über deterministische Cursor paginieren und Flurstücks-IDs in gebündelten Batches puffern. Diese Batches können anschließend asynchron über Bulk-Detail-Endpunkte mit Daten angereichert werden, wodurch verhindert wird, dass große GeoJSON-Polygone und umfangreiche Historien von Steuerbewertungen den Ingestion-Thread blockieren.
Transformation heterogener Immobilienattribute in ein internes kanonisches Schema
Öffentliche Register stammen von Tausenden von Steuergutachtern der Counties, die unterschiedliche Benennungskonventionen, Datumsformate und Zonendefinitionen verwenden. Beispielsweise können Flächenangaben je nach Standard des jeweiligen Counties als Bruttofläche (Gross Area), Wohnfläche (Living Area) oder beheizte Fläche (Heated Area) ausgewiesen sein. Wenn Sie Roh-Payloads direkt in Ihrer primären Anwendungsdatenbank speichern, koppeln Sie Ihre Domänenlogik eng an externe Datenstrukturen.
Stattdessen müssen Ingestion-Worker einen zwischengeschalteten Transformationsschritt ausführen, der Rohattribute in ein internes kanonisches Modell normalisiert. Einheitliche Immobiliendaten sollten konsistente Schemata etablieren für:
- Geografische Koordinaten: Standardisierte WGS84-Breiten- und Längengrade in Kombination mit normalisierten Flurstücksgrenzen.
- Bewertung und Veranlagung: Getrennt erfasster Bodenwert, Gebäudewert, steuerlicher Gesamtwert und die jeweiligen Steuerbewertungen.
- Bauliche Metadaten: Normalisierte Angaben zu Schlafzimmern, Badezimmern, Bruttogeschossfläche und Baujahr.
Defensive Parsing-Strategien zur Absicherung von Systemen gegen Upstream-Schema-Drifts
Vorgelagerte APIs passen in regelmäßigen Abständen Response-Payloads an, führen optionale Felder ein oder liefern unerwartete Null-Werte zurück, wenn in den County-Unterlagen bestimmte Angaben fehlen. Entwickler, die lernen, wie man eine Reapi-Integration implementiert, müssen bei großen Datenmengen eine defensive Deserialisierung mittels Schemavalidierungs-Bibliotheken wie Pydantic, Zod oder JSON Schema erzwingen.
Ein striktes Type-Casting an der Ingestion-Grenze stellt sicher, dass unerwartete Typen – wie etwa als String codierte numerische Steuerbewertungen oder fehlende Arrays – sofort abgefangen und typkonvertiert werden. Verletzt eine Payload kritische Validierungsregeln, leitet der Worker den fehlerhaften Datensatz für Alerts in eine Dead-Letter-Queue (DLQ) weiter, während die übergeordnete Batch-Synchronisierung unterbrechungsfrei fortgesetzt wird.
Wie optimieren Sie Caching und asynchrone Datensynchronisierung für Subsekunden-Antwortzeiten?
Um Subsekunden-Antwortzeiten auf Immobilienportalen zu erzielen, muss die persistente Speicherung von den Live-Abrufpfaden entkoppelt werden. Eine ausgereifte PropTech Architektur für die Real Estate API Integration kombiniert arbeitsspeichergestützte Caches, indizierte relationale Datenbanken und Hintergrund-Synchronisationswarteschlangen, um sofortige Übersichten über Immobiliendaten bereitzustellen, ohne externe Immobilien API Schnittstellen der Anbieter zu überlasten.
Strukturierung von Multi-Tier-Caching über Redis und relationale Speicher
Eine mehrstufige Caching-Hierarchie trennt hochfrequente Leseanfragen von relationalen Abfragelasten. In dieser Topologie fungieren In-Memory-Datenspeicher wie Redis als L1-Cache für besonders gefragte Immobiliendaten, Flurstücksgrenzen und Übersichtskarten. Redis speichert serialisierte JSON-Payloads mit standardisierten Flurstückskennungen oder APNs als Schlüssel und liefert Antworten im einstelligen Millisekundenbereich.
PostgreSQL oder MySQL dient als persistenter L2-Datenspeicher für normalisierte relationale Entitäten, Volltext-Adressindizes und historische Grundbucheinträge. Fragt eine Anwendung ein Inserat ab, prüft der Dienst zuerst Redis. Bei einem Cache-Miss ruft er den kanonischen Datensatz aus PostgreSQL ab, befüllt den Redis-Cache mit einer definierten Ablaufzeit und gibt die Payload an den Client zurück. Dieses mehrstufige Setup schützt sowohl primäre Datenbanken als auch vorgelagerte APIs vor Lastspitzen beim Lesen.
Managing TTLs and Selective Invalidation for Rapidly Shifting Public Records
Immobiliendaten weisen je nach Attribut eine unterschiedliche Volatilität auf. Statische Attribute wie Flurstücksgrenzen, Grundstücksgrößen und historische Steuerbewertungen ändern sich selten und werden in der Regel jährlich im Rahmen kommunaler Steuerzyklen aktualisiert. Im Gegensatz dazu verändern sich MLS-Listing-Status, Angebotspreise und Vorvermerke im Tagesverlauf rapide.
Um Aktualität und Kosten im Rahmen Ihrer Reapi-Integration und PropTech Data Pipeline auszubalancieren, weisen Sie den einzelnen Datenebenen differenzierte Time-to-Live-Schwellenwerte (TTL) zu:
- Statische öffentliche Registerdaten: Speichern Sie Flurstücksgeometrien, historische Grundbuchakten und Bewertungsdaten für 14 bis 30 Tage im Cache.
- Steuerbewertungen und Grundpfandrechte: Cachen Sie jährliche Steuerbescheide und Pfandrechtsvermerke angesichts ihrer planmäßigen Erfassungszyklen für 7 bis 14 Tage.
- Dynamische MLS-Status: Nutzen Sie kurze TTLs von 15 bis 60 Minuten, kombiniert mit ereignisgesteuerten Invalidierungs-Hooks, sobald neue Änderungsdatensätze eingespielt werden.
Orchestrierung von Hintergrund-Sync-Workern mit Concurrency Control und Rate-Limiting
Hintergrund-Worker müssen Daten systematisch erfassen, ohne Quotenstufen von Anbietern zu überschreiten oder lokale Datenbank-Verbindungspools zu erschöpfen. Asynchrone Job-Prozessoren (wie Celery, BullMQ oder Sidekiq) koordinieren die Worker mithilfe von verteilten Token-Bucket- oder Leaky-Bucket-Rate-Limitern.
Wenn Batch-Updates ausgelöst werden, rufen Worker Aktualisierungen der Immobiliendaten in kontrollierten Nebenläufigkeitsfenstern ab. Antwortet ein vorgelagerter Dienst mit Rate-Limiting-Warnungen oder HTTP-429-Statuscodes, pausiert ein exponentielles Backoff mit Jitter ausgehende Anfragen dynamisch. Diese Orchestrierung stellt sicher, dass die Datensynchronisierung kontinuierlich im Hintergrund läuft, ohne Serviceunterbrechungen für aktive Plattformnutzer zu verursachen.
Was sind die wichtigsten technischen Trade-offs zwischen Polling, Webhooks und KI-beschleunigtem Code?
Beim Entwurf einer Enterprise-Integration müssen Ingestion-Mechanismen und Entwicklungsgeschwindigkeit sorgfältig abgewogen werden. Beim Aufbau einer robusten PropTech Architektur für eine Real Estate API Integration (Reapi-Integration) müssen technische Teams zwischen Push- und Pull-Synchronisierung entscheiden und gleichzeitig modernes, KI-gestütztes Engineering sicher einsetzen.
Webhook-Event-Streaming vs. zeitgesteuertes Batch-Syncing: Zuverlässigkeit und Fehlerbehebung
Echtzeit-Aktualisierungen sprechen oft für ein ereignisgesteuertes Webhook-Modell, doch öffentliche Immobilienregister übertragen Änderungen nicht immer verzögerungsfrei per Push. Wo verfügbar, bietet eine robuste Implementierung von Reapi Webhooks oder ein externer Event-Listener eine geringere Latenz bei Statusänderungen von Immobilien. Allerdings erfordern Webhooks eine Signaturprüfung, idempotente Consumer-Handler und Replay-Puffer, um eine Ausführung in falscher Reihenfolge zu verhindern.
Umgekehrt ermöglicht zeitgesteuertes Batch-Polling eine deterministische Ressourcenplanung und vorhersehbare API-Ausgaben. Durch das Tracking von Cursor-Zeitstempeln und Abfragegrenzen erfassen zeitgesteuerte Worker aktualisierte Immobiliendaten, ohne eingehende HTTP-Endpunkte dem öffentlichen Web-Traffic auszusetzen. Für die großvolumige Datenerfassung in einer PropTech Data Pipeline bietet die Kombination aus stündlichen Batch-Abfragen für Massendaten und gezielten Webhook-Listenern für dringende Listing-Alerts eine optimale Balance zwischen Zuverlässigkeit und Infrastruktur-Overhead.
Was KI-Coding-Tools in Integrations-Pipelines beschleunigen vs. was Engineers selbst entwerfen müssen
Moderne Engineering-Workflows setzen zunehmend auf KI-Coding-Agents, um Routineaufgaben bei der Reapi-Integration zu beschleunigen. KI-Tools zeichnen sich besonders beim Scaffolding von Boilerplate-Code für Datenzugriffsschichten aus, generieren repetitive JSON-Serialisierungsschemata und erstellen initiale Mock-Suites für vorgelagerte Endpunkte einer Immobilien API Schnittstelle. Im Engineering-Workflow bei Canvas Developers nutzen Teams KI-gestütztes Scaffolding und iterative Tools wie Antigravity, um initiale DTOs und Parser-Modelle schnell aufzubauen.
KI-generierter Code kann jedoch grundlegende architektonische Sorgfalt nicht ersetzen. KI-Modelle übersehen häufig subtile Fehlermuster wie verteilte Race Conditions, Cache Stampedes und Randfälle bei öffentlichen Flurstücks- und Immobiliendaten. Erfahrene Engineers müssen die Architektur vorgeben, jeden Commit prüfen und strenge Audits für Sicherheit, kryptografische Speicherung von Zugangsdaten, Datenintegrität und Pipeline-Skalierung durchführen, bevor Code für die Produktion freigegeben wird.
Welche kritischen Fallstricke sollten Sie bei einer produktiven Real Estate API Integration vermeiden?
Die Bereitstellung eines Dienstes für Immobiliendaten in einer Produktivumgebung setzt Integrationsarchitekturen und die gesamte PropTech-Architektur verschiedenen betrieblichen Risiken aus. Ausfälle von Upstream-Providern, unerwartete Schemaabweichungen auf Landkreisebene und unoptimierte Polling-Routinen können das Nutzererlebnis rasch beeinträchtigen und die monatlichen API-Kosten in die Höhe treiben.
Eine robuste Reapi-Datenpipeline für Immobiliendaten muss in der Lage sein, Teilausfälle kontrolliert abzufedern. Wenn externe Endpunkte für Flurstücke vorübergehende Ausfälle oder Rate-Limiting aufweisen, stellt die Implementierung von Circuit-Breaker-Mustern sicher, dass Ihre Anwendung kontrolliert degradiert, indem sie zwischengespeicherte Basis-Immobiliendaten ausliefert, anstatt komplett auszufallen. Nicht verarbeitbare Datensätze oder unerwartete Schemaanomalien sollten direkt an Dead-Letter-Queues weitergeleitet werden, um Engineering-Teams zu benachrichtigen, ohne aktive Ingestion-Batches abzubrechen.
Ein weiterer häufiger Fallstrick ist eine unkontrollierte Quotenüberschreitung durch redundante Batch-Aufrufe. Wenn es darum geht, wie Sie eine Reapi-Integration effektiv implementieren, müssen Engineering-Teams Query-Hashing und ID-Deduplizierung vorschalten, bevor Detailabfragen abgesetzt werden. Vor dem Absenden von Bulk-Enrichment-Anfragen sollten Worker die lokalen Cache-Zeitstempel überprüfen, um nicht für unveränderte Immobiliendaten zu bezahlen.
Bevor Sie Ihre Integration für die Produktivumgebung freigeben, überprüfen Sie diese operativen Schutzmaßnahmen:
- Circuit Breakers: Automatischer Fallback auf zwischengespeicherte Datensätze bei Ausfällen von Upstream-Providern.
- Payload-Deduplizierung: In-Flight-Request-Coalescing, um doppelte externe Abfragen zu eliminieren.
- Schema-Isolierung: Striktes Boundary-Parsing mit isolierten Warteschlangen für nicht zugeordnete Felder.
- Quota-Monitoring: Echtzeit-Warnmeldungen zum Credit-Verbrauch, um Abrechnungsüberschreitungen zu verhindern.
Wie sollten Sie Ihren nächsten Meilenstein bei der Reapi-Integration planen und umsetzen?
Die erfolgreiche Umsetzung einer unternehmensweiten Reapi-Integration erfordert die Strukturierung der Bereitstellung in klare, überschaubare Meilensteine. Anstatt ein monolithisches Deployment anzustreben, sollten Entwicklungsteams den Rollout in drei zentrale Phasen unterteilen: grundlegende Schema-Ingestion und Pufferung für das Rate-Limiting, Caching und Härtung asynchroner Worker sowie End-to-End-Integrationstests mit Übergabe in die Produktion.
Bei Canvas Developers verbinden unsere Ingenieure KI-gestütztes Scaffolding für die schnelle Generierung von Schemas und Clients mit strenger menschlicher Aufsicht bei Architektur, Datenintegrität und Sicherheitsaudits. Ganz gleich, ob Sie über unsere Services zur SaaS-MVP-Entwicklung ein neues PropTech-Unternehmen aufbauen oder die Real Estate API Integration-Architektur einer bestehenden Plattform skalieren möchten – unser Team hilft dabei, volumenstarke Datenpipelines zu stabilisieren und zu härten.
Wenn Sie planen, landesweite Flurstücksdaten und Steuerbewertungen zu erfassen, starten Sie eine gezielte Integrationsbewertung über unser Kontaktformular mit Angaben zu Ihrem aktuellen Tech-Stack, Ihren Restriktionen bei der Daten-Ingestion und Ihren Performance-Zielen.