Scalare una moderna piattaforma PropTech richiede l'accesso in tempo reale a record immobiliari, modelli di valutazione e confini particellari. Tuttavia, implementare una diretta integrazione Reapi nei servizi web rivolti agli utenti introduce spesso una latenza significativa, attriti legati al rate limiting e un sovraccarico del payload a monte. Quando gli utenti richiedono la consultazione dei dati particellari o stime fiscali, l'attesa di risposte sincrone da parte di API di terze parti degrada la reattività e fa lievitare i costi di infrastruttura.
Per ottenere tempi di risposta inferiori al secondo, i team di ingegneria devono passare dalle interrogazioni sincrone delle API a una pipeline di dati asincrona e disaccoppiata. Questa guida tecnica delinea il modello architetturale per acquisire, normalizzare ed eseguire il caching dei dati immobiliari su scala nazionale in modo efficiente, isolando l'applicazione e preservando al contempo la resilienza del sistema.
Perché l'ingestione diretta di Reapi causa latenza e colli di bottiglia nella tua app PropTech?
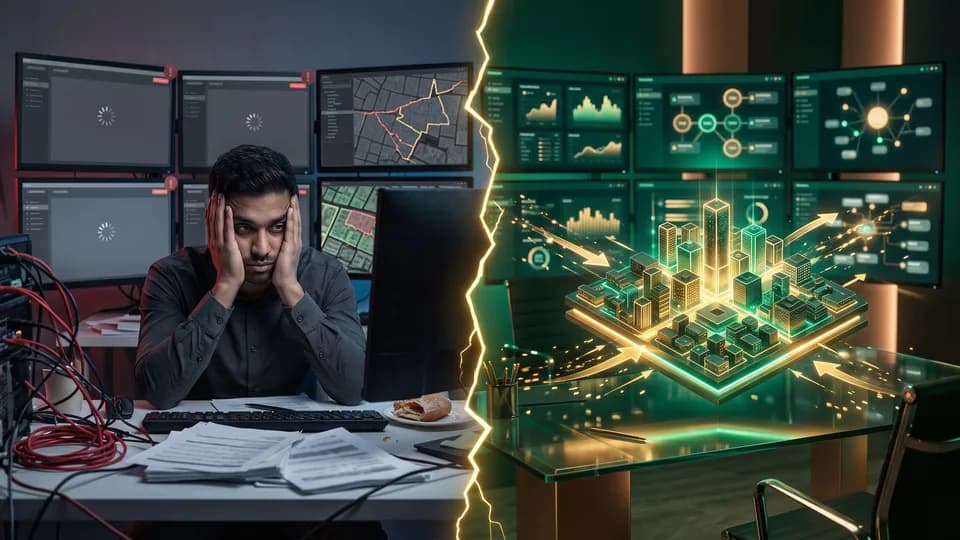
Collegare direttamente le richieste web degli utenti agli endpoint immobiliari upstream crea immediate vulnerabilità a livello di prestazioni. Quando le applicazioni client interrogano in modo sincrono record particellari su scala nazionale, valutazioni fiscali o lo storico degli atti immobiliari, ogni azione dell'utente eredita l'overhead di rete upstream, la latenza geografica e i costi di serializzazione del payload. Persino i payload standard dei record immobiliari contengono spesso decine di oggetti annidati, introducendo ritardi di risposta di centinaia di millisecondi durante i picchi di utilizzo.
Con la crescita del traffico, i costi nascosti delle chiamate sincrone aumentano rapidamente. I vincoli di rate limiting del provider upstream limitano le query concorrenti dei client, provocando errori HTTP 429 a cascata, l'esaurimento del pool di thread e connessioni interrotte. Quando i database upstream affrontano picchi di carico, elevate latenze di coda si propagano direttamente all'interfaccia utente, frustrando gli utenti finali e danneggiando la retention dei clienti.
Comprendere come implementare l'integrazione Reapi in modo efficace richiede di affrontare questi colli di bottiglia operativi a livello architetturale. Un'integrazione Reapi resiliente non espone mai le interfacce client direttamente alla volatilità upstream; crea invece un livello intermedio di ingestione che isola le dipendenze esterne dalla reattività della piattaforma principale.
Quali basi architetturali richiede una pipeline di dati immobiliari scalabile?
Nello sviluppo app PropTech, creare un sistema ad alto throughput richiede una netta separazione delle responsabilità tra il layer applicativo e i provider di dati a monte. Una solida architettura di integrazione API immobiliari isola le query sui record pubblici dal ciclo di vita delle richieste frontend, garantendo che le interazioni degli utenti rimangano reattive anche quando i servizi terzi a monte registrano una latenza variabile.
Disaccoppiare gli endpoint rivolti all'utente dal recupero dei dati esterni
Per proteggere le applicazioni client, le richieste degli utenti devono interrogare un datastore interno o un livello di caching, invece di inviare chiamate HTTP dirette a fornitori esterni. Quando un utente accede al profilo di un immobile, il presentation layer legge istantaneamente i record canonici locali. Se il record è assente, scaduto o in attesa di arricchimento, la piattaforma restituisce subito i metadati di base disponibili, accodando al contempo task di sincronizzazione in background.
Questo disaccoppiamento impedisce che il jitter della rete esterna degradi le interfacce utente, elimina i timeout a cascata e protegge i server web dal rate limiting di terze parti. In Canvas Developers, i nostri ingegneri strutturano queste interfacce attraverso pipeline personalizzate di sviluppo API, garantendo elevata disponibilità e prestazioni di interrogazione prevedibili sui portali immobiliari ad alto volume.
Scegliere la giusta topologia di acquisizione: gateway sincrono vs code event-driven
La scelta della topologia di acquisizione determina con quanta efficienza il sistema scala sotto carico. I gateway API sincroni soddisfano semplici esigenze di proxying, ma collassano di fronte a picchi di elaborazione batch o a rallentamenti intermittenti a monte. Al contrario, un'architettura asincrona ed event-driven basata su code di messaggi (come RabbitMQ, Kafka o AWS SQS) fa da buffer ai carichi di acquisizione e impone un rigoroso controllo della concorrenza.
Un'asincrona pipeline di dati immobiliari con integrazione Reapi distribuisce pool di worker per elaborare i job di acquisizione a ritmi deterministici, rispettando le quote del provider e assorbendo al contempo picchi improvvisi di traffico. Le routine dei worker gestiscono retry, logiche di backoff e trasformazioni del payload in modo indipendente, garantendo che la reattività della piattaforma resti stabile a prescindere dalle fluttuazioni della rete a monte.
Come implementare una pipeline di dati resiliente per l'ingestion e la normalizzazione dello schema per Reapi?
Una pipeline di dati completa per record immobiliari deve elaborare record fiscali, registri degli atti e geometrie particellari a livello nazionale senza esaurire la memoria di sistema o la larghezza di banda di rete. Seguire l'approccio strutturato di un tutorial per l'integrazione Reapi assicura che l'ingestion dei dati rimanga prevedibile e resiliente rispetto alla variabilità dello schema tra le diverse giurisdizioni.
Ingestion efficiente dei dati particellari e dei record fiscali di contea su scala nazionale
I record fiscali di contea e i dataset relativi ai confini particellari comprendono milioni di particelle a livello nazionale, ciascuna con specifiche peculiarità giurisdizionali. L'interrogazione di questi enormi dataset richiede di ridurre al minimo le dimensioni del payload mediante modalità di query selettive. Secondo la documentazione di RealEstateAPI, l'utilizzo di modalità di query dedicate come ids_only consente ai sistemi di recuperare innanzitutto identificativi leggeri degli immobili prima di estrarre la struttura completa dei record.
Quando si lavora con le API dati catastali e immobiliari di Reapi su scala nazionale, i worker di ingestion dovrebbero paginare tramite cursori deterministici, memorizzando i parcel ID in buffer suddivisi in lotti. Questi lotti possono poi essere popolati in modo asincrono tramite endpoint di dettaglio massivi, evitando che poligoni GeoJSON di grandi dimensioni e ampi storici delle valutazioni fiscali blocchino il thread di ingestion.
Trasformare attributi immobiliari eterogenei in uno schema canonico interno
I record pubblici provengono da migliaia di periti di contea che adottano convenzioni di denominazione, formati di data e definizioni di zonizzazione divergenti. Ad esempio, la metratura può essere indicata come superficie lorda, superficie abitabile o superficie riscaldata a seconda degli standard della contea. Salvare direttamente i payload grezzi nel database applicativo principale crea un forte accoppiamento tra la logica di dominio e le strutture dati di terze parti.
I worker di ingestion devono invece eseguire un passaggio di trasformazione intermedio che normalizzi gli attributi grezzi in un modello canonico interno. Un record immobiliare unificato dovrebbe definire schemi coerenti per:
- Coordinate geografiche: coordinate standardizzate di latitudine e longitudine WGS84 abbinate a confini particellari normalizzati.
- Valutazione e stima fiscale: valori distinti per valore del terreno, valore delle migliorie, valore imponibile totale e rispettivi record fiscali di stima.
- Metadati strutturali: conteggi normalizzati per camere da letto, bagni, metratura quadrata lorda e anno di costruzione.
Strategie di parsing difensivo per isolare i sistemi dalle derive di schema a monte
Le API a monte modificano periodicamente i payload di risposta, introducono campi opzionali o restituiscono valori null imprevisti quando i record di contea sono privi di informazioni specifiche. Gli sviluppatori che imparano come implementare l'integrazione Reapi su larga scala devono applicare una deserializzazione difensiva utilizzando librerie di convalida dello schema come Pydantic, Zod o JSON Schema.
Un rigoroso type casting al confine di ingestion garantisce che i tipi imprevisti — come valutazioni numeriche codificate come stringhe o array mancanti — vengano intercettati e convertiti tempestivamente. Se un payload viola regole di convalida critiche, il worker instrada il record anomalo verso una dead-letter queue (DLQ) per la generazione di avvisi, consentendo alla sincronizzazione batch complessiva di proseguire senza interruzioni.
Come ottimizzare il caching e la sincronizzazione asincrona dei dati per risposte inferiori al secondo?
Ottenere tempi di risposta inferiori al secondo sui portali immobiliari richiede di disaccoppiare lo storage persistente dai flussi di recupero in tempo reale. Un'avanzata architettura di integrazione API immobiliari combina cache in-memory ad altissima velocità, database relazionali indicizzati e code di sincronizzazione in background per fornire panoramiche immobiliari immediate senza sovraccaricare le API dei fornitori esterni.
Strutturare il caching multi-tier tra Redis e lo storage relazionale
Una gerarchia di caching multi-tier separa le richieste di lettura ad alta frequenza dai carichi di lavoro delle query relazionali. In questa topologia, i data store in memoria come Redis fungono da cache L1 per i record immobiliari ad alto traffico, le coordinate dei confini e le schede riassuntive. Redis memorizza payload JSON serializzati con chiavi basate su identificatori particellari standardizzati o APN, restituendo risposte nell'ordine dei singoli millisecondi.
PostgreSQL o MySQL funge da datastore L2 persistente, archiviando entità relazionali normalizzate, indici full-text per gli indirizzi e lo storico degli atti notarili. Quando un'applicazione interroga un annuncio, il servizio verifica prima la presenza del dato su Redis. In caso di cache miss, recupera il record canonico da PostgreSQL, popola la cache di Redis con una scadenza definita e restituisce il payload al client. Questa architettura a più livelli protegge sia i database primari sia le API a monte dai picchi di lettura.
Gestire TTL e invalidazione selettiva per i record pubblici in rapida evoluzione
I dati immobiliari presentano una volatilità variabile a seconda dei diversi attributi. Gli attributi statici come i confini particellari, la superficie del lotto e le valutazioni fiscali storiche cambiano raramente, aggiornandosi di norma con cadenza annuale durante i cicli fiscali delle contee. Al contrario, lo stato degli annunci MLS, i prezzi richiesti e gli indicatori di vendita condizionata variano rapidamente nell'arco della giornata.
Per bilanciare freschezza dei dati e costi all'interno della tua pipeline di dati immobiliari per l'integrazione Reapi, assegna soglie differenziate di time-to-live (TTL) ai diversi livelli di dati:
- Record pubblici statici: mantieni in cache le geometrie particellari, gli atti storici e i registri catastali per un periodo compreso tra 14 e 30 giorni.
- Valutazioni fiscali e gravami: mantieni in cache le imposte annuali e le trascrizioni di gravami per 7-14 giorni, considerando le loro tempistiche di registrazione programmate.
- Stati MLS dinamici: applica TTL ridotti, da 15 a 60 minuti, abbinati a hook di invalidazione event-driven ogni volta che vengono acquisiti nuovi record di modifica.
Orchestrare i worker di sincronizzazione in background con controllo della concorrenza e rate throttling
I worker in background devono acquisire i dati in modo sistematico, senza superare i limiti di quota dei fornitori né esaurire i pool di connessione del database locale. I sistemi di elaborazione asincrona dei job (come Celery, BullMQ o Sidekiq) coordinano i worker utilizzando rate limiter distribuiti basati su token bucket o leaky bucket.
Quando si attivano gli aggiornamenti a lotti, i worker recuperano gli aggiornamenti immobiliari all'interno di intervalli di concorrenza controllati. Se un servizio a monte risponde con avvisi di rate limiting o codici di stato HTTP 429, un algoritmo di exponential backoff con jitter sospende dinamicamente le richieste in uscita. Questa orchestrazione garantisce che la sincronizzazione dei dati in background venga eseguita continuamente, senza causare interruzioni di servizio per gli utenti attivi della piattaforma.
Quali sono i principali trade-off tecnici tra polling, webhook e codice accelerato dall'IA?
La progettazione di un'integrazione enterprise richiede di bilanciare i meccanismi di acquisizione con la velocità di sviluppo. Nel definire una solida architettura di integrazione API immobiliari, i team tecnici devono scegliere tra sincronizzazione push e pull, sfruttando al contempo la moderna ingegneria assistita dall'IA in modo sicuro.
Streaming di eventi webhook vs sincronizzazione batch programmata: affidabilità e ripristino dagli errori
Gli aggiornamenti in tempo reale suggeriscono spesso l'adozione di un modello basato su webhook ed eventi, tuttavia i registri immobiliari pubblici non sempre inviano le modifiche istantaneamente in modalità push. Ove disponibile, una resiliente implementazione webhook Reapi o un event listener esterno offre una minore latenza per le variazioni di stato degli immobili. Tuttavia, i webhook richiedono la verifica delle firme, handler consumer idempotenti e buffer di replay per prevenire esecuzioni fuori sequenza.
Al contrario, il polling a lotti programmato offre una pianificazione deterministica delle risorse e costi API prevedibili. Tracciando i timestamp dei cursori e i limiti delle query, i worker pianificati recuperano i record aggiornati senza esporre endpoint HTTP in entrata al traffico web pubblico. Per l'acquisizione di dati su larga scala, combinare passaggi batch orari per record massivi con listener webhook mirati per gli avvisi urgenti sugli annunci offre un equilibrio ottimale tra affidabilità e overhead infrastrutturale.
Cosa accelerano gli strumenti di coding basati su IA nelle pipeline di integrazione rispetto a ciò che gli ingegneri devono progettare
I moderni flussi di lavoro ingegneristici utilizzano sempre più spesso agenti di coding basati su IA per accelerare le attività di routine nell'integrazione. Gli strumenti di IA eccellono nella creazione dello scaffolding per layer di accesso ai dati boilerplate, nella generazione di schemi di serializzazione JSON ripetitivi e nella scrittura di suite di mock iniziali per gli endpoint upstream. All'interno del nostro flusso di lavoro ingegneristico in Canvas Developers, i team utilizzano lo scaffolding assistito dall'IA e strumenti iterativi come Antigravity per creare rapidamente DTO iniziali e modelli di parser.
Tuttavia, il codice generato dall'IA non può sostituire il fondamentale rigore architetturale. I modelli di IA trascurano spesso modalità di errore insidiose come race condition distribuite, cache stampede e casi limite nei record particellari pubblici. Gli ingegneri esperti devono guidare l'architettura, revisionare ogni commit e condurre audit rigorosi su sicurezza, archiviazione crittografica delle credenziali, integrità dei dati e scalabilità delle pipeline prima di rilasciare il codice in produzione.
Quali sono le insidie più critiche da evitare nelle integrazioni immobiliari in produzione?
Il rilascio in produzione di un servizio di dati immobiliari espone le architetture di integrazione a diversi rischi operativi. I disservizi dei provider a monte, le deviazioni impreviste negli schemi delle contee e le routine di polling non ottimizzate possono degradare rapidamente l'esperienza utente e far lievitare i costi mensili delle API.
Una resiliente pipeline di dati immobiliari Reapi deve gestire i guasti parziali in modo controllato. Quando gli endpoint particellari di terze parti registrano disservizi temporanei o fenomeni di rate limiting, l'implementazione di pattern circuit breaker garantisce una degradazione controllata dell'applicazione, servendo record di base in caching anziché bloccarsi del tutto. I record non analizzabili o le anomalie impreviste dello schema dovrebbero essere instradati direttamente verso dead-letter queue, allertando i team di ingegneria senza interrompere i lotti di acquisizione attivi.
Un'altra insidia frequente è l'esaurimento incontrollato delle quote causato da chiamate a lotti ridondanti. Quando si apprende come implementare l'integrazione Reapi in modo efficace, i team di ingegneria devono implementare l'hashing delle query e la deduplicazione degli ID prima di inviare le ricerche di dettaglio. Prima di inviare richieste massive di arricchimento, i worker dovrebbero verificare i timestamp della cache locale per evitare di pagare per record immobiliari non modificati.
Prima di rilasciare l'integrazione in produzione, verifica queste misure di protezione operative:
- Circuit Breaker: fallback automatico ai record in caching durante i disservizi a monte.
- Deduplicazione del payload: coalescenza delle richieste in corso per eliminare le query esterne duplicate.
- Isolamento dello schema: parsing rigoroso dei confini con code isolate per i campi non mappati.
- Monitoraggio delle quote: avvisi in tempo reale sul consumo dei crediti per prevenire costi extra di fatturazione.
Come definire l'ambito ed eseguire la prossima milestone dell'integrazione Reapi?
Per completare con successo un'integrazione Reapi di livello enterprise è necessario strutturare il rilascio in milestone distinte e gestibili. Invece di tentare un deployment monolitico, i team di ingegneria dovrebbero scaglionare il rollout in tre fasi chiave: acquisizione iniziale dello schema e buffering per il rate limiting, consolidamento di caching e worker asincroni, e test di integrazione end-to-end con passaggio alla produzione.
In Canvas Developers, i nostri ingegneri combinano lo scaffolding assistito dall'AI per la rapida generazione di schemi e client con una rigorosa supervisione umana su architettura, integrità dei dati e audit di sicurezza. Che stiate avviando una nuova iniziativa PropTech tramite i nostri servizi di sviluppo MVP SaaS o scalando l'architettura di integrazione API immobiliari di una piattaforma esistente, il nostro team aiuta a stabilizzare e consolidare pipeline ad alto volume.
Se state pianificando l'acquisizione di record catastali e fiscali su scala nazionale, avviate una valutazione di integrazione mirata tramite il nostro modulo di contatto indicando il vostro stack tecnologico attuale, i vincoli di ingestione dei dati e gli obiettivi di performance.