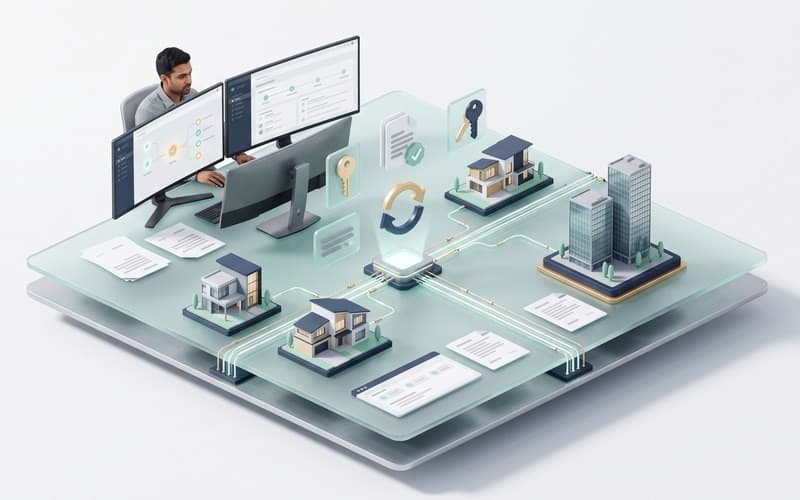
Dieses anschauliche Beispiel ist eine von Canvas Developers entworfene konzeptionelle Produktarchitektur, die demonstriert, wie Enterprise-Engineering-Teams bei der Immobilien API Integration eine durchsatzstarke Immobilien-API-Integrationsplattform strukturieren können. Es handelt sich nicht um ein abgeschlossenes Kundenprojekt. Immobilien-Investmentgesellschaften, Underwriting-Teams und Bewertungsplattformen kämpfen regelmäßig mit fragmentierten Grundbuch- und Katasterregistern, Gutachter- und Bewertungsdatenbanken sowie Datenströmen aktueller Immobilienangebote. Dieser Blueprint modelliert eine einheitliche Microservice-Architektur, die heterogene öffentliche Register und kommerzielle Feeds als Immobiliendaten aggregiert und in einer Low-Latency-Abfrageschicht bereitstellt.
Projekt im Überblick: Was leistet diese Proptech-Integrations-Engine?
Konzipiert für Proptech-Unternehmen, institutionelle Asset-Manager und automatisierte Bewertungsplattformen demonstriert dieses Konzept eine unternehmensweite Immobilien-API-Integrationsplattform, die für die Verarbeitung hochvolumiger Immobiliendatensätze ausgelegt ist. Der technische Schwerpunkt liegt auf der Zusammenführung heterogener Flurstücksdatensätze – darunter Steuerregister der Bewertungsämter, Eigentumsübertragungen und aktuelle Immobilienangebote – zu einer standardisierten Data Fabric.
Als einheitlicher Proptech-Listing-Aggregator normalisiert die Plattform heterogene Upstream-Quellen wie Endpunkte der RealEstateAPI-Dokumentation, sekundäre REAPI-Feeds und Angebote kommerzieller Marktplätze in einheitliche Schemata. Durch die Entkopplung der Schema-Ingestion von Drittanbietern von den konsumentenseitigen Abfrageschnittstellen gewährleistet die Architektur eine ausfallsichere Downstream-Bereitstellung für Bewertungs-Engines und Tools zur Immobiliensuche.
Das Briefing: Wie harmonisieren Sie fragmentierte Immobilienregister skalierbar?
Der Aufbau einer robusten bundesweiten Immobiliensuchmaschine erfordert die Bewältigung einer akuten Datenfragmentierung. Über verschiedene kommunale Zuständigkeiten hinweg speichern Grundbuch- und Katasterämter Flurstücksgrenzen, Eigentumsübertragungen und Steuerbewertungen in widersprüchlichen Formaten mit uneinheitlichen Feldbezeichnungen und fehlenden geografischen Attributen. Gleichzeitig werden kommerzielle Listing-Feeds kontinuierlich mit aktuellen Angebotspreisen und Angebotsstatus aktualisiert.
Die Integration dieser disparaten Register in eine automatisierte Immobilienbewertungspipeline bringt erhebliche Restriktionen bei Durchsatz, räumlichem Geocoding und Latenz mit sich. Ingestion-Pipelines müssen Tausende unterschiedlicher Steuer- und Flurstücksdatenpunkte über Dutzende Millionen Wohnimmobilien-Datensätze hinweg normalisieren und unformatierte Assessor Parcel Numbers (APNs) sowie Koordinatenprojektionen auflösen, ohne Engpässe für nachgelagerte Vergleichsanalysen zu verursachen.
Ansatz & Prozess: Wie beschleunigt menschgeführtes KI-Engineering Datenpipelines?
Um diese Immobilien-API-Integrationsplattform effizient zu entwickeln, setzt Canvas Developers auf menschgeführte KI-Workflows. KI-Coding-Agenten und ein hochentwickeltes Engineering-Harness beschleunigen die Generierung von routinemäßigen Data-Ingestion-Konnektoren, Schnittstellen-Boilerplate und Schema-Transformations-Mappern über kommunale Datenkataloge hinweg. Je nach Sicherheitsanforderungen auf Enterprise-Ebene stellen Teams diese Workflows über Private / Local AI Engineering bereit – unter Einsatz isolierter Open-Weight-Modelle oder kommerzieller Claude Code- und OpenAI Codex-Umgebungen gemäß kundenfreigegebenen Richtlinien.
Automatisierte Tools können die Domänenexpertise bei komplexen Datenflüssen jedoch nicht ersetzen. Erfahrene Software-Engineers leiten jede Pipeline-Phase und definieren die Microservice-Topologie, resiliente Message Queues sowie strikte Schema-Contracts. Senior Engineers prüfen jeden Pull Request, setzen Typsicherheit durch und steuern Release-Entscheidungen, um sicherzustellen, dass Feeds für die Immobilien-Analytics-Integration ihre Datenkonsistenz wahren, bevor sie Staging-Umgebungen erreichen.
Was entwickelt wurde: Wie die einheitliche GraphQL-Schicht Bewertungen unter 100 ms ermöglicht
Die konzeptionelle Architektur dieser Immobilien API Integration basiert auf einer einheitlichen GraphQL-Schicht – einer GraphQL Real Estate API –, die auf Flurstücksebene normalisierte Urkunden, Hypotheken und Steuerveranlagungen abfragt. Statt mehrere REST-Endpunkte verschiedener Grundbuch- und Steuerämter zu verwalten, fragen Client-Anwendungen über die Proptech API ein föderiertes Schema ab. Diese Schnittstelle speist ein interaktives Dashboard für die Immobilienbewertung API mit einem synchronisierten Dual-Pane-Layout: Eine Geodatenkarte visualisiert Flurstücksgrenzen neben vergleichenden Bewertungspanels mit historischen Urkunden-Timelines und detaillierten Aufschlüsselungen der Gutachterregister.
Hinter der Benutzeroberfläche führt eine Automatisierte Immobilienbewertungspipeline eine deterministische Datensatz-Deduplizierung und räumliche Geokodierung durch. Ingestion-Worker führen uneinheitliche County-FIPS-Codes, unformatierte Flurstücksnummern (Assessor Parcel Numbers, APNs) und Grenzkoordinaten zu persistenten Entitätsdatensätzen zusammen. Um einen hohen Durchsatz bei mehreren zehn Millionen Wohnimmobiliendatensätzen zu gewährleisten, aggregieren verteilte Redis-Caching-Cluster Immobiliendaten in vorberechneten Zusammenfassungen und liefern bei aktiven Suchanfragen vergleichende Marktbewertungen in unter 100 ms.
Technische Realitäten: Wo Automatisierung brilliert und was menschliche Aufsicht erfordert
Während KI-Tools Parser und Konnektoren rasch als Grundgerüst aufbauen, bringt das Data Engineering Herausforderungen mit sich, die eine Automatisierung allein nicht bewältigen kann. Kommunale Daten-Feeds weisen häufig Schema-Drift, fehlende Flurstückswerte und undokumentierte Formatierungsänderungen auf. Bei einer geschäftskritischen Immobilien-Analytics-Integration können unbehandelte vorgelagerte Diskrepanzen Bewertungsalgorithmen und Underwriting-Berechnungen verfälschen.
Menschliche Aufsicht auf Senior-Ebene bleibt für die Systemstabilität unerlässlich. Erfahrene Entwickler entwerfen belastbare Fallback-Strategien, validieren Datenbankindizes und auditieren die Datensicherheit über Mandantengrenzen hinweg. In jeder unternehmensweiten Immobilien-API-Integrationsplattform stellt ein menschliches Code-Review sicher, dass Caching-Topologien und Pipelines auch unter hoher Last zuverlässig skalieren.
Nächste Schritte: Wie können Sie eine maßgeschneiderte Proptech-Integrationsplattform konzipieren und aufbauen?
Die Überführung dieses Konzepts in eine aktive bundesweite Immobiliensuchmaschine folgt einem strukturierten, meilensteinbasierten Entwicklungspfad. Projekte beginnen mit einem technischen Scoping und führen über die Konnektorenentwicklung sowie eine rigorose Qualitätssicherung bis hin zum Cloud-Deployment.
Ob beim Aufbau eines MVPs oder bei der Bereitstellung einer durchsatzstarken Immobilien-API-Integrationsplattform: Canvas Developers verbindet menschliche Entwicklungsleitung mit KI-gestützter Beschleunigung. Um Ihre Anforderungen an das Aggregieren von Immobiliendaten zu evaluieren, vereinbaren Sie eine gezielte technische Ersteinschätzung über das Kontaktformular von Canvas Developers oder kontaktieren Sie uns per WhatsApp auf der Website.