Cet exemple illustratif est une architecture produit conceptuelle conçue par Canvas Developers pour démontrer comment les équipes d'ingénierie d'entreprise peuvent structurer une plateforme d'intégration d'API immobilières à haut débit. Il ne s'agit pas d'un projet client livré. En matière d'intégration API immobilière, les sociétés d'investissement immobilier, les services de souscription et les plateformes d'évaluation sont régulièrement confrontés au morcellement des registres fonciers municipaux, des bases de données des évaluateurs et des flux d'annonces en direct. Ce plan directeur modélise une architecture de microservices unifiée qui agrège des registres publics et des flux commerciaux hétérogènes au sein d'une couche d'interrogation à faible latence.
Aperçu du projet : que propose ce moteur d'intégration proptech ?
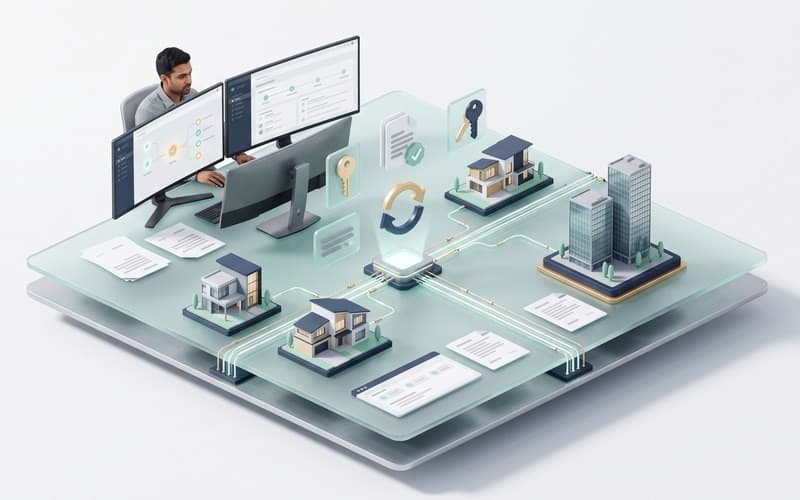
Conçu pour les entreprises de la proptech, les gestionnaires d'actifs institutionnels et les plateformes d'évaluation automatisée, ce concept présente une plateforme d'intégration d'API immobilières d'entreprise, développée pour traiter de grands volumes de registres immobiliers. Le périmètre d'ingénierie se concentre sur l'unification de jeux de données parcellaires disparates — notamment les rôles d'évaluation foncière, les transferts d'actes et l'inventaire du marché en direct — au sein d'un tissu de données standardisé.
En tant qu'agrégateur unifié d'annonces proptech, la plateforme normalise des sources amont hétérogènes — telles que les points de terminaison de la documentation RealEstateAPI, les flux secondaires REAPI et les annonces de places de marché commerciales — au sein de schémas unifiés. En découplant l'ingestion des schémas tiers des interfaces de requête orientées utilisateur, l'architecture garantit une distribution en aval résiliente pour les moteurs d'évaluation et les outils de recherche de biens immobiliers.
Le brief : comment harmoniser des registres immobiliers fragmentés à grande échelle ?
Développer un moteur de recherche de biens immobiliers à l'échelle nationale résilient exige de résoudre une fragmentation aiguë des données. D'une juridiction municipale à l'autre, les bureaux d'enregistrement des comtés conservent les limites parcellaires, les transferts d'actes de propriété et les évaluations fiscales dans des formats incompatibles, marqués par une nomenclature de champs hétérogène et des attributs géographiques manquants. Dans le même temps, les flux d'annonces commerciales s'actualisent en continu avec les prix demandés en vigueur et le statut des annonces.
L'intégration API immobilière de ces registres disparates au sein d'un pipeline d'évaluation immobilière automatisée présente de sévères contraintes de débit, de géocodage spatial et de latence. Les pipelines d'ingestion doivent normaliser des milliers de points de données fiscales et parcellaires hétérogènes sur des dizaines de millions d'enregistrements résidentiels, en traitant les numéros de parcelle (APN, Assessor Parcel Numbers) non formatés et les projections de coordonnées sans créer de goulot d'étranglement pour les analyses comparatives en aval.
Approche & processus : comment l'ingénierie IA supervisée par l'humain accélère-t-elle les pipelines de données ?
Pour bâtir efficacement cette plateforme d'intégration d'API immobilières, Canvas Developers applique des flux de travail d'ingénierie IA supervisée par l'humain. Des agents de codage IA et un harnais d'ingénierie avancé accélèrent la génération de connecteurs d'ingestion de données de routine, de code standard d'interface et de mappeurs de transformation de schémas à travers les dictionnaires de données municipaux. Selon les exigences de sécurité de l'entreprise, les équipes déploient ces flux de travail via Private / Local AI Engineering en utilisant des modèles open-weight isolés ou des environnements commerciaux Claude Code et OpenAI Codex régis par des politiques approuvées par le client.
Cependant, les outils automatisés ne peuvent remplacer l'expertise métier dans la plomberie de données complexe. Des ingénieurs logiciels expérimentés pilotent chaque phase du pipeline, définissant la topologie des microservices, des files d'attente de messages résilientes et des contrats de schéma stricts. Des ingénieurs seniors examinent chaque pull request, appliquent la sécurité du typage et encadrent les décisions de déploiement afin de garantir que les flux d'intégration d'analyses immobilières maintiennent la cohérence des données avant d'atteindre les environnements de préproduction.
Ce qui a été développé : comment la couche GraphQL unifiée permet-elle des évaluations en moins de 100 ms ?
L'architecture conceptuelle de cette intégration d'API immobilière s'articule autour d'une couche GraphQL unifiée qui interroge des actes de propriété, des hypothèques et des évaluations fiscales normalisés à l'échelle de la parcelle. Au lieu de gérer de multiples points de terminaison REST auprès des registres fiscaux municipaux, les applications clientes interrogent un schéma fédéré. Cette interface alimente un tableau de bord d'API d'évaluation immobilière interactif doté d'une disposition synchronisée à deux volets : une carte géospatiale affichant les limites parcellaires, juxtaposée à des panneaux d'évaluation comparative côte à côte intégrant la chronologie historique des actes et le détail du rôle d'évaluation.
Sous l'interface, un pipeline d'évaluation immobilière automatisée exécute une déduplication déterministe des enregistrements et un géocodage spatial. Les workers d'ingestion convertissent les codes FIPS de comté disparates, les numéros de parcelle de l'évaluateur (APN) non formatés et les coordonnées de délimitation en enregistrements d'entités persistants. Afin de prendre en charge un débit élevé sur des dizaines de millions de données immobilières résidentielles, des clusters de cache Redis distribués stockent des synthèses immobilières pré-agrégées, offrant des évaluations comparatives de marché en moins de 100 ms sur l'ensemble des requêtes de recherche actives.
Réalités techniques : où l'automatisation excelle-t-elle et qu'est-ce qui exige une supervision humaine ?
Alors que les outils d'IA permettent d'échafauder rapidement des parseurs et des connecteurs, l'ingénierie des données présente des défis que l'automatisation ne peut résoudre seule. Les flux municipaux connaissent fréquemment des dérives de schéma, des valeurs parcellaires manquantes et des modifications de formatage non documentées. Pour une intégration API immobilière analytique critique, des divergences en amont non traitées peuvent corrompre les algorithmes d'évaluation et les calculs de souscription.
Une supervision humaine experte demeure essentielle à la stabilité du système. Des ingénieurs expérimentés conçoivent des stratégies de repli résilientes, valident l'indexation des bases de données et auditent la sécurité des données entre les différents locataires. Au sein de toute plateforme d'intégration d'API immobilières d'entreprise, la revue de code humaine garantit que les topologies de mise en cache et les pipelines montent en charge de manière fiable sous un trafic intense.
Prochaines étapes : comment cadrer et développer une plateforme d'intégration proptech sur mesure ?
La transformation de ce concept en un moteur de recherche de biens immobiliers à l'échelle nationale opérationnel suit une démarche d'ingénierie structurée et jalonnée. Les projets débutent par un cadrage technique, puis progressent à travers le développement des connecteurs, une assurance qualité rigoureuse et le déploiement dans le cloud.
Qu'il s'agisse de concevoir un MVP ou de déployer une plateforme d'intégration d'API immobilières à haut débit, Canvas Developers associe un leadership d'ingénierie humaine à une accélération assistée par l'IA. Pour évaluer vos besoins en matière d'agrégation de données, planifiez une évaluation technique de cadrage via le formulaire de contact de Canvas Developers ou contactez-nous via WhatsApp sur le site.