Uma arquitetura de marketing analytics e relatórios confiável substitui painéis de anúncios fragmentados e relatórios SaaS desconectados por uma base própria e verificável para dados de receita. Em organizações B2B focadas em crescimento, os ciclos de compra envolvem diversas partes interessadas em pesquisas orgânicas, campanhas pagas, testes de produtos e interações de vendas consultivas. Depender exclusivamente de métricas isoladas obscurece a influência entre canais, inflaciona alegações de atribuição e deixa equipes executivas debatendo a validade dos dados em vez de otimizar os investimentos em aquisição.
Estabelecer um pipeline de data warehouse próprio resolve esses pontos cegos operacionais ao centralizar eventos de usuários e pontos de contato do CRM em um esquema unificado. Este guia de implementação detalha as camadas técnicas, as convenções de modelagem de dados e os fluxos de trabalho de engenharia necessários para implementar uma stack de relatórios de nível corporativo que escala com o crescimento organizacional.
Por que dashboards desconectados de plataformas falham com equipes de marketing B2B em expansão
Quando equipes de marketing B2B dependem de relatórios isolados de fornecedores, modelos conflitantes de atribuição geram atritos imediatos nas operações de receita. Grandes redes de anúncios, como LinkedIn Ads, Google Search e plataformas de mídia programática, operam sistemas de mensuração fechados. Normalmente, cada rede atribui a si mesma as conversões concluídas com base em janelas proprietárias de view-through ou regras de último clique. Ao consolidar os dados entre os canais, o total de conversões reportadas frequentemente supera a criação real de pipeline por uma margem significativa. Essa contagem dupla distorce os cálculos de custo de aquisição de clientes e abala a confiança da liderança no desempenho dos canais.
Essas discrepâncias se intensificam ao comparar as métricas de anúncios das plataformas com os registros operacionais do CRM. As redes de anúncios contabilizam cliques brutos e disparos de tags no lado do cliente, enquanto os sistemas de CRM acompanham leads qualificados, solicitações de demonstração e estágios de pipeline por conta. Bloqueadores de rastreamento, restrições de privacidade nos navegadores e ciclos prolongados de qualificação de vendas impedem que as tags de anúncios nativas se correlacionem diretamente com as atividades de vendas nas etapas seguintes. Sem uma stack de relatórios e analytics b2b estruturada, os líderes de marketing não conseguem reconciliar os investimentos em mídia paga com os valores de contratos fechados nem identificar gargalos na velocidade do pipeline.
Os dashboards nativos das plataformas também apresentam rígidos limites arquiteturais à medida que a complexidade operacional aumenta. Ferramentas de relatórios integradas raramente comportam transformações SQL personalizadas, resolução de identidade multi-touch entre diferentes sessões da web ou comparações de estados históricos ao longo de vários trimestres. A migração para uma arquitetura de marketing analytics e relatórios dedicada desacopla o armazenamento e a análise de dados dos softwares proprietários dos fornecedores, dando às equipes técnicas controle total sobre seu pipeline de dados de marketing.
Como é estruturada uma stack de relatórios de marketing centralizada?
Uma stack de relatórios de marketing centralizada e resiliente desacopla a ingestão de telemetria, o armazenamento persistente, a transformação de dados e o business intelligence em camadas modulares. Em vez de forçar redes de anúncios e sistemas de CRM a conexões ponto a ponto frágeis, essa arquitetura de marketing analytics estabelece um pipeline de data warehouse para marketing auditável, no qual cada registro recebe timestamp, é validado e torna-se rastreável até sua origem.
Coleta de eventos e streaming de dados de clientes via Segment
A camada de telemetria começa com a coleta de eventos client-side e server-side. A infraestrutura de dados de clientes padroniza o rastreamento de interações em sites de marketing, aplicações web e portais de clientes. Ao integrar pipelines de dados de clientes por meio de integrações da plataforma de desenvolvedores da Segment especializadas, as equipes seguem os padrões descritos na documentação de destinos do Twilio Segment, roteando chamadas padrão de track, page e identify por meio de SDKs de cliente com retentativas automáticas e envio em lote para destinos de armazenamento. A preservação de atributos de usuário — como IDs anônimos de dispositivos, marcadores de sessão e perfis autenticados de clientes — garante que as interações entre dispositivos permaneçam vinculáveis ao longo de ciclos de vendas estendidos no analytics B2B.
Durante a implementação, a configuração de controles rigorosos de esquema na fronteira de ingestão evita que payloads malformados e propriedades de eventos não verificadas poluam as tabelas analíticas downstream. Essa filtragem protetora resguarda a integridade dos dados em todos os modelos de relatórios subsequentes.
Armazenamento em data warehouse central e design da camada de ingestão
Fluxos de eventos brutos e extrações de APIs operacionais são carregados diretamente em data warehouses colunares em nuvem, incluindo Snowflake, Google BigQuery e Amazon Redshift. Essa camada de ingestão isola tabelas brutas e imutáveis da lógica de relatórios downstream. Organizações em rápido crescimento com políticas rigorosas de conformidade frequentemente implantam ambientes privados e isolados de data warehouse em nuvem, enquanto equipes que buscam rápida geração de valor utilizam uma infraestrutura em nuvem totalmente gerenciada.
Acima da camada de armazenamento bruto, mecanismos de transformação como o dbt compilam scripts SQL modulares e com controle de versão em modelos semânticos curados. Esses modelos de transformação normalizam timestamps discrepantes, unem estágios do ciclo de vida do CRM a pontos de contato da web e expõem métricas verificadas para ferramentas de business intelligence. Ao preservar dados brutos imutáveis, as equipes de engenharia podem atualizar fórmulas de atribuição retrospectivamente sem perder a telemetria histórica.
Como construir um pipeline de data warehouse para marketing passo a passo
A execução de um pipeline de data warehouse para marketing confiável exige uma progressão sistemática, desde a governança de eventos até a modelagem SQL multitabelas. Em vez de tentar uma implementação monolítica, as equipes de engenharia estabelecem confiança nos dados validando a taxonomia antecipadamente, configurando conectores de ingestão robustos e estruturando modelos de transformação determinísticos para sua arquitetura de marketing analytics e stack de relatórios de marketing para analytics b2b.
Etapa 1: Padronização da taxonomia de rastreamento e governança de UTMs
A precisão do pipeline de dados de marketing falha com mais frequência no perímetro de rastreamento. Antes de implementar scripts de rastreamento, como etapa crucial em um checklist de implementação de analytics, as equipes devem estabelecer um plano de rastreamento explícito que defina convenções rigorosas de nomenclatura para nomes de eventos, propriedades de payload e parâmetros de campanhas de entrada. Os nomes de eventos devem adotar uma sintaxe de objeto-ação (como Form Submitted, Pricing Viewed ou Demo Requested), em vez de strings arbitrárias.
A governança de parâmetros de campanha deve impor caracteres alfanuméricos em minúsculas, separadores com hífen e uma taxonomia padronizada entre utm_source, utm_medium, utm_campaign e utm_content. As equipes de engenharia configuram linters pré-commit automatizados e modelos de geração de URL para evitar que anomalias de caixa (como cpc versus CPC) fragmentem as fontes de tráfego dentro das tabelas do data warehouse.
Etapa 2: Sincronizando fluxos de eventos e registros de pipeline do HubSpot CRM
Conectar objetos comerciais de CRM com fluxos de sessões web anônimas une as atividades de topo de funil à receita de vendas confirmada. Ao implementar uma arquitetura de integração CRM e data warehouse do HubSpot resiliente, as equipes de engenharia aproveitam os recursos descritos na documentação de integrações de armazenamento de dados em nuvem do HubSpot, que confirma que a infraestrutura corporativa de dados suporta a sincronização bidirecional com o data warehouse para objetos principais, incluindo contatos, empresas, negócios, tíquetes e objetos personalizados no Snowflake, BigQuery e AWS S3.
Nossa prática de engenharia configura pipelines de extração automatizados que ingerem tanto alterações incrementais de estágios de negócios quanto históricos imutáveis de eventos. Ao conectar registros do HubSpot a logs de streaming, os engenheiros implementam a unificação determinística de identidades (identity stitching): associando um cookie de sessão anônimo (anonymous_id) a um registro de contato identificado (user_id) no momento em que um prospect envia um formulário de lead ou faz login. Engenheiros seniores verificam restrições de chave primária e a lógica de upsert idempotente (como instruções SQL MERGE) para evitar marcos de negócios duplicados durante janelas de sincronização de alto volume.
Etapa 3: Modelando pontos de contato unificados para atribuição e análise de coorte
Assim que os eventos brutos e os snapshots do CRM residem nas tabelas de staging do data warehouse, as camadas de transformação os normalizam em modelos de pontos de contato unificados. Cada linha na tabela de pontos de contato resultante representa uma interação autenticada ou anônima com timestamp padronizado, canal de campanha, identificador de conta e associação de negócio.
Engenheiros de analytics constroem modelos de atribuição multitoque — incluindo modelos de primeiro toque (first-touch), baseados em posição (em formato U ou W) e de decaimento temporal (time-decay) — diretamente em SQL. Esses modelos calculam a contribuição para o pipeline juntamente com análises de coorte, acompanhando a duração do ciclo de vendas desde a sessão inicial de descoberta até a assinatura do contrato. Ferramentas de IA aceleram a estruturação de transformações SQL padronizadas e views de staging, enquanto engenheiros seniores auditam funções de janela (window functions), cardinalidade de junções entre tabelas e conversões de moeda para garantir uma precisão de relatórios no nível de um balanço patrimonial.
Como uma estrutura multicanal unificada se compara a relatórios isolados?
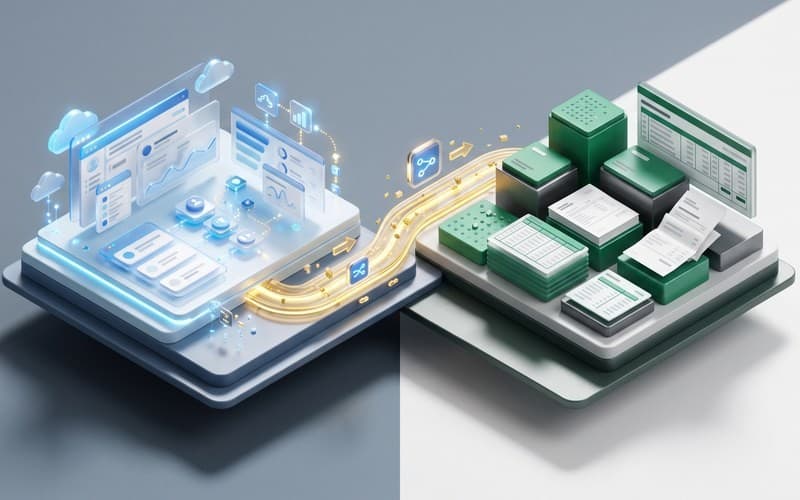
Avaliar as opções de relatórios exige comparar modelos nativos de warehouse com dashboards tradicionais baseados em soluções pontuais. Uma arquitetura de marketing analytics multicanal coesa elimina as alegações conflitantes de ferramentas isoladas de fornecedores ao unificar as interações brutas dos clientes sob um modelo de dados auditável e transparente.
Modelos de relatórios nativos de warehouse versus ferramentas fragmentadas de analytics
As stacks tradicionais de marketing dependem de ferramentas SaaS fragmentadas, nas quais cada plataforma opera sua própria lógica de atribuição de caixa-preta e seu respectivo silo de dados isolado. Ferramentas de web analytics registram sessões de navegação, plataformas de anúncios reivindicam conversões com base em janelas de atribuição proprietárias e plataformas de CRM monitoram os estágios do pipeline de vendas de forma independente. Essa fragmentação impede a visibilidade multifuncional e força as equipes a gastar horas conciliando manualmente planilhas contraditórias.
Para startups em estágio inicial com um único canal de aquisição, dashboards nativos podem ser temporariamente suficientes; no entanto, em operações de analytics B2B onde múltiplos canais e representantes de vendas interagem com as mesmas contas, a modelagem nativa no warehouse torna-se essencial. Uma stack de relatórios de marketing centralizada concentra a verdade analítica dentro de um data warehouse para marketing. As visualizações de relatórios consultam tabelas modeladas viabilizadas pela integração CRM e data warehouse, que unem gastos brutos com anúncios, telemetria web de clientes e registros verificados de negociações do CRM. Essa configuração também permite que as equipes de engenharia equilibrem de forma pragmática a sincronização em lote e o processamento em tempo real. Enquanto o monitoramento de clickstream de alta frequência se beneficia de fluxos de eventos em tempo quase real, modelos complexos de atribuição e pipelines financeiros são calculados com melhor custo-benefício em execuções em lote agendadas por hora ou diariamente, evitando gastos desnecessários de computação e entregando snapshots consistentes de relatórios.
Onde o scaffolding de IA acelera pipelines e onde os engenheiros devem verificar
Construir uma infraestrutura moderna de analytics e estruturar um pipeline de dados de marketing já não exige meses de codificação manual de boilerplate. Os fluxos modernos de trabalho de engenharia utilizam agentes e harnesses de codificação com IA para estruturar arquivos de transformação do dbt via scaffolding, gerar scripts de migração de esquema, formatar stubs de conectores de API e escrever testes unitários para modelos SQL em minutos. Essa aceleração reduz substancialmente os ciclos de feedback de desenvolvimento durante a configuração inicial.
No entanto, a geração de código por IA apresenta modos de falha técnicos bem definidos que exigem a supervisão de engenheiros sêniores. Modelos de IA não conseguem avaliar de forma independente nuances de soberania de dados, antecipar breaking changes de esquemas upstream ou garantir precisão matemática em consultas complexas de atribuição com janelas (window functions). Se não forem supervisionados, scripts automatizados frequentemente introduzem fan-outs sutis em joins, chaves primárias duplicadas ou lógicas incorretas de merge incremental que corrompem relatórios históricos. Nossa abordagem combina o scaffolding rápido por IA com engenheiros de dados experientes que seguem um rigoroso checklist de implementação de analytics ao revisar detalhadamente cada pull request, aplicar padrões de governança de dados, realizar testes de estresse no desempenho de consultas e autorizar as decisões finais de release.
O que deve constar no seu checklist de implementação de analytics para evitar a deriva de dados?
A deriva de dados e as regressões silenciosas de esquema representam as ameaças operacionais mais persistentes à integridade analítica. Manter um checklist de implementação de analytics bem estruturado garante que cada instrumentação de rastreamento, conector de pipeline e modelo de transformação cumpra critérios rigorosos de garantia de qualidade antes de embasar a tomada de decisões executivas na sua estrutura de analytics b2b e relatórios.
Validação pré-lançamento de esquemas de eventos e garantia de qualidade
A validação pré-lançamento começa em ambientes de staging antes de o código chegar às branches de produção. As equipes de engenharia devem executar payloads de eventos sintéticos por meio de proxies de rastreamento para verificar se nomes de eventos, tipos de propriedades obrigatórias e identificadores contextuais seguem rigorosamente o plano de tracking. As suítes de testes automatizados precisam assegurar que campos numéricos não possam ser ingeridos como strings e que valores nulos acionem alertas de esquema, em vez de falhas silenciosas de armazenamento.
Os protocolos de garantia de qualidade também devem validar a lógica de resolução de identidade nas transições entre dispositivos. Um checklist pré-lançamento completo abrange:
- Conformidade com o plano de tracking: Verificação automatizada de JSON Schema para cada payload de evento no cliente e no servidor.
- Persistência de identidade: Verificação de ponta a ponta da vinculação de cookies anônimos na conversão inicial do formulário de lead.
- Asserções de transformação: Testes automatizados que confirmam a unicidade das colunas, valores não nulos e a integridade referencial em todas as chaves estrangeiras.
Mitigando breaking changes decorrentes de atualizações de APIs e webhooks upstream
Plataformas SaaS externas e redes de anúncios atualizam rotineiramente versões de APIs, modificam payloads de webhooks ou descontinuam endpoints de tracking. Sem um monitoramento proativo, a renomeação não anunciada de um campo upstream pode quebrar silenciosamente os modelos de transformação downstream, resultando em dias de dados ausentes antes que os analistas percebam discrepâncias nos dashboards.
Para mitigar a instabilidade upstream, os pipelines de dados de marketing devem ingerir payloads brutos em tabelas de staging agnósticas de esquema antes de executar a análise estruturada (parsing). Monitores automatizados de observabilidade de dados devem acompanhar diariamente anomalias de volume, limites de atualização e desvios de esquema. Caso um webhook upstream deixe de enviar uma propriedade esperada, dead-letter queues capturam os payloads com falha para reprocessamento assim que os engenheiros ajustarem os modelos de transformação.
Por fim, a segurança de dados e a governança de privacidade devem ser contínuas. A arquitetura de marketing analytics precisa aplicar controle de acesso baseado em funções, mascaramento em nível de coluna para dados de identificação pessoal e fluxos automatizados de exclusão para atender às exigências de conformidade regulatória.
Como planejar e implementar sua arquitetura de analytics com a Canvas Developers
Implementar uma arquitetura de marketing analytics e de relatórios pronta para produção exige engenharia disciplinada, desde o design inicial do esquema até a manutenção contínua de pipelines. Na Canvas Developers, uma empresa de engenharia de software com escritório em Dhaka, oferecemos uma gama abrangente de serviços de arquitetura de analytics e de relatórios, desenvolvendo sistemas de dados sob medida, plataformas SaaS e integrações corporativas. Nossa abordagem de entrega combina desenvolvimento acelerado por IA com rigorosa supervisão de engenharia humana. Agentes de codificação com IA geram rapidamente boilerplates de conectores, estruturam modelos dbt e elaboram suítes de testes, enquanto engenheiros sêniores experientes direcionam a arquitetura do sistema, auditam a segurança dos dados, revisam cada pull request e autorizam os lançamentos em produção.
Dependendo das diretrizes organizacionais de governança e conformidade, os clientes podem escolher entre dois modelos transparentes de entrega com IA: 'Engenharia de IA Privada / Local', utilizando modelos de pesos abertos hospedados de forma privada na infraestrutura controlada pelo cliente, ou 'Engenharia com Claude Code / OpenAI Codex', implementando ferramentas comerciais de IA sob configurações de nuvem aprovadas. Esse modelo permite que as equipes alcancem iterações rápidas sem comprometer a privacidade dos dados, a propriedade intelectual ou a confiabilidade dos pipelines.
Quer você precise construir um novo pipeline de dados de marketing e relatórios do zero ou auditar e reforçar uma estrutura existente, cada projeto começa com um escopo bem definido, marcos de desenvolvimento acordados, testes abrangentes de garantia de qualidade e uma transição estruturada. Para avaliar sua stack de dados ativa e planejar seu roteiro de implementação, solicite uma avaliação de escopo por meio do formulário de contato da Canvas Developers.
Passo a passo
Padronizar a taxonomia de rastreamento e a governança de UTMs
Estabeleça um plano formal de rastreamento com nomenclatura de eventos no formato objeto-ação e aplique convenções padronizadas de parâmetros UTM em minúsculas em todos os canais de marketing.
Sincronizar fluxos de eventos e registros de pipeline do HubSpot CRM
Implemente conectores bidirecionais de data warehouse para ingerir telemetria bruta junto a registros de contatos, empresas e negócios do CRM, com resolução determinística de identidade.
Modelar pontos de contato unificados para atribuição e análise de coorte
Transforme logs de eventos preparados e marcos do CRM em tabelas de atribuição multitoque e modelos de coorte usando lógica SQL com controle de versão.