Une architecture analytics marketing et de reporting fiable remplace les tableaux de bord publicitaires fragmentés et les rapports SaaS déconnectés par un socle propriétaire et vérifiable dédié aux données de revenus. Au sein des entreprises B2B axées sur la croissance, les cycles d'achat impliquent de multiples parties prenantes à travers la recherche organique, les campagnes payantes, les essais de produits et les interactions commerciales à fort accompagnement. Se fier uniquement à des métriques en silos masque l'influence multicanale, gonfle artificiellement l'attribution et amène les équipes dirigeantes à débattre de la validité des données plutôt qu'à optimiser les investissements d'acquisition.
Mettre en place un pipeline de data warehouse propriétaire élimine ces angles morts opérationnels en centralisant les événements utilisateurs et les points de contact CRM au sein d'un schéma unifié. Ce guide de mise en œuvre détaille les couches techniques, les conventions de modélisation des données et les flux de travail d'ingénierie nécessaires pour déployer une stack de reporting d'entreprise capable d'évoluer au rythme de la croissance de votre organisation.
Pourquoi les tableaux de bord déconnectés des plateformes échouent à accompagner les équipes marketing B2B en pleine croissance
Lorsque les équipes marketing B2B s'appuient sur un reporting en silos propre aux plateformes, des modèles d'attribution contradictoires créent immédiatement des frictions au sein des Revenue Operations. Les principales régies publicitaires, telles que LinkedIn Ads, Google Search et les plateformes de display programmatique, fonctionnent avec des systèmes de mesure cloisonnés. Chaque réseau s'attribue généralement les conversions conclues sur la base de fenêtres post-affichage (view-through) ou de règles au dernier clic propriétaires. Lorsqu'elles sont agrégées sur l'ensemble des canaux dans le cadre d'un reporting multi canal B2B, le total des conversions rapportées dépasse souvent largement la création réelle de pipeline. Ce double comptage fausse le calcul du coût d'acquisition client et érode la confiance de la direction dans la performance des canaux.
Ces écarts s'accentuent lorsque l'on compare les métriques publicitaires des plateformes avec les enregistrements CRM opérationnels. Les régies publicitaires comptabilisent les clics bruts et les déclenchements de balises côté client, tandis que les systèmes CRM suivent les leads qualifiés, les demandes de démo et les étapes du pipeline par compte. Les bloqueurs de suivi, les restrictions de confidentialité des navigateurs et les cycles de qualification commerciale différés empêchent les balises publicitaires natives d'établir une corrélation directe avec l'activité commerciale en aval. Sans un setup analytics et reporting B2B structuré, les responsables marketing ne peuvent rapprocher les investissements médias de la valeur des contrats signés, ni identifier les goulots d'étranglement dans la vélocité du pipeline.
Les tableaux de bord natifs intégrés aux plateformes révèlent également de strictes limites architecturales à mesure que la complexité opérationnelle s'accroît. Les outils de reporting intégrés prennent rarement en charge les transformations SQL personnalisées, la résolution d'identité multi-touch entre différentes sessions web ou la comparaison des états historiques sur plusieurs trimestres. Passer à une architecture analytics marketing dédiée permet de découpler le stockage et l'analyse des données des solutions logicielles propriétaires, conférant aux équipes techniques la pleine maîtrise de leur pipeline analytics.
Comment une stack de reporting marketing centralisée est-elle structurée ?
Une stack de reporting marketing centralisée et résiliente découple l'ingestion de la télémétrie, le stockage persistant, la transformation des données et la business intelligence en couches modulaires. Plutôt que d'imposer des connexions point à point fragiles entre régies publicitaires et systèmes CRM, cette architecture analytics marketing établit un pipeline de data warehouse marketing auditable, où chaque enregistrement est horodaté, validé et traçable jusqu'à son origine.
Collecte d'événements et streaming de données clients via Segment
La couche de télémétrie débute par la collecte d'événements côté client et côté serveur. L'infrastructure de données clients standardise le suivi des interactions sur les sites web marketing, les applications web et les portails clients. Lors de l'intégration de pipelines de données clients via des intégrations spécialisées de la plateforme développeur Segment, les équipes appliquent les normes décrites dans la documentation sur les destinations Twilio Segment, en acheminant les appels standard track, page et identify à l'aide de SDK clients dotés de mécanismes de reprise automatique et de traitement par lots vers les destinations de stockage. La préservation des attributs utilisateurs — tels que les identifiants d'appareils anonymes, les marqueurs de session et les profils clients authentifiés — garantit que les interactions multi-appareils restent associables tout au long de cycles d'achat B2B prolongés.
Lors de l'implémentation, la configuration de contrôles stricts de schéma au niveau de l'ingestion empêche les charges utiles mal formées et les propriétés d'événements non vérifiées de polluer les tables analytiques en aval. Ce filtrage protecteur préserve l'intégrité des données au sein des modèles de reporting ultérieurs.
Stockage centralisé en data warehouse et conception de la couche d'ingestion
Les flux d'événements bruts et les extractions d'API opérationnelles atterrissent directement dans des data warehouses cloud colonnaires, notamment Snowflake, Google BigQuery et Amazon Redshift. Cette couche d'ingestion isole les tables brutes et immuables de la logique de reporting en aval. Les organisations à forte croissance soumises à des politiques de conformité strictes déploient souvent des environnements de data warehouse cloud privés et isolés, tandis que les équipes recherchant une création de valeur rapide privilégient une infrastructure cloud entièrement managée.
Au-dessus de la couche de stockage brut, des moteurs de transformation tels que dbt compilent des scripts SQL modulaires et versionnés en modèles sémantiques préparés. Ces modèles de transformation normalisent les horodatages disparates, croisent les étapes du cycle de vie CRM avec les points de contact web, et exposent des métriques vérifiées aux outils de business intelligence. En préservant des données brutes immuables, les équipes d'ingénierie peuvent mettre à jour les formules d'attribution de manière rétrospective sans perdre la télémétrie historique.
Comment construire un pipeline de data warehouse marketing étape par étape
Déployer un pipeline de data warehouse marketing fiable au cœur d'une architecture analytics marketing exige une progression méthodique, de la gouvernance des événements à la modélisation des données SQL multi-tables. Plutôt que de tenter un déploiement monolithique, les équipes d'ingénierie établissent la fiabilité des données en validant la taxonomie en amont, en configurant des connecteurs d'ingestion robustes et en structurant des modèles de transformation déterministes pour leur analytics B2B setup et stack de reporting marketing.
Étape 1 : Standardiser la taxonomie de tracking et la gouvernance des UTM
C'est le plus souvent au niveau du périmètre de tracking que la précision du pipeline de données est compromise. Avant de déployer les scripts de suivi, les équipes doivent établir un plan de marquage explicite — véritable checklist d'implémentation analytics — qui définit des conventions de nommage strictes pour les noms d'événements, les propriétés des payloads et les paramètres des campagnes entrantes. Les noms d'événements devraient adopter une syntaxe objet-action (comme Form Submitted, Pricing Viewed ou Demo Requested) plutôt que des chaînes de caractères arbitraires.
La gouvernance des paramètres de campagne doit imposer des caractères alphanumériques en minuscules, des séparateurs avec tirets et une taxonomie standardisée pour utm_source, utm_medium, utm_campaign et utm_content. Les équipes d'ingénierie configurent des linters automatisés en pré-commit et des modèles de génération d'URL afin d'empêcher que des anomalies de casse (telles que cpc contre CPC) ne fragmentent les sources de trafic au sein des tables du data warehouse.
Étape 2 : Synchroniser les flux d'événements et les enregistrements CRM de pipeline HubSpot
Associer les objets CRM commerciaux aux flux de sessions web anonymes permet de faire le pont entre l'activité en haut de funnel et le chiffre d'affaires validé. Lors de la mise en œuvre d'une intégration CRM data warehouse résiliente reposant sur une architecture d'intégration CRM HubSpot, les équipes d'ingénierie exploitent les fonctionnalités décrites dans la documentation HubSpot sur les intégrations de stockage de données cloud, qui confirme que l'infrastructure de données d'entreprise prend en charge la synchronisation bidirectionnelle avec le data warehouse pour les objets clés — notamment les contacts, entreprises, transactions (deals), tickets et objets personnalisés — sur Snowflake, BigQuery et AWS S3.
Notre équipe d'ingénierie configure des pipelines d'extraction automatisés qui ingèrent à la fois les changements incrémentiels d'étapes de deals et l'historique immuable des événements. Lors de la réconciliation des enregistrements CRM HubSpot avec les flux de logs, les ingénieurs mettent en œuvre un rapprochement d'identités déterministe (identity stitching) : attribuer un cookie de session anonyme (anonymous_id) à un enregistrement de contact identifié (user_id) dès qu'un prospect soumet un formulaire ou se connecte. Les ingénieurs seniors vérifient les contraintes de clé primaire et la logique d'upsert idempotente (comme les instructions SQL MERGE) afin d'éviter les doublons de jalons de deals lors des fenêtres de synchronisation à fort volume.
Étape 3 : Modéliser des points de contact unifiés pour l'attribution et l'analyse de cohortes
Une fois les événements bruts et les instantanés CRM chargés dans les tables de staging du data warehouse, les couches de transformation les normalisent en modèles de points de contact unifiés. Chaque ligne de la table de points de contact ainsi obtenue représente une interaction authentifiée ou anonyme, étiquetée avec un horodatage standardisé, un canal de campagne, un identifiant de compte et une association à un deal.
Les analytics engineers conçoivent des modèles d'attribution multi-touch — notamment au premier contact (first-touch), basés sur la position (en U ou en W) et à dépréciation temporelle (time-decay) — directement en SQL. Ces modèles alimentent le reporting multi canal B2B et calculent la contribution au pipeline ainsi que les analyses de cohortes, en suivant la durée des cycles d'achat depuis la session de découverte initiale jusqu'à la signature du contrat. Les outils d'IA accélèrent la génération du code boilerplate pour les transformations SQL et les vues de staging, tandis que les ingénieurs seniors auditent les fonctions de fenêtrage, la cardinalité des jointures entre tables et les conversions de devises pour garantir une précision de reporting digne d'un bilan comptable.
Comment un cadre multicanal unifié se compare-t-il au reporting en silos ?
Évaluer les options de reporting au sein d'une architecture analytics marketing exige de comparer les modèles natifs au data warehouse aux tableaux de bord d'outils ponctuels traditionnels. Un cadre multicanal de reporting analytics cohérent élimine les prétentions contradictoires des outils éditeurs isolés en unifiant les interactions brutes des clients sous un modèle de données auditable et transparent.
Modèles de reporting natifs au data warehouse face aux outils analytics fragmentés
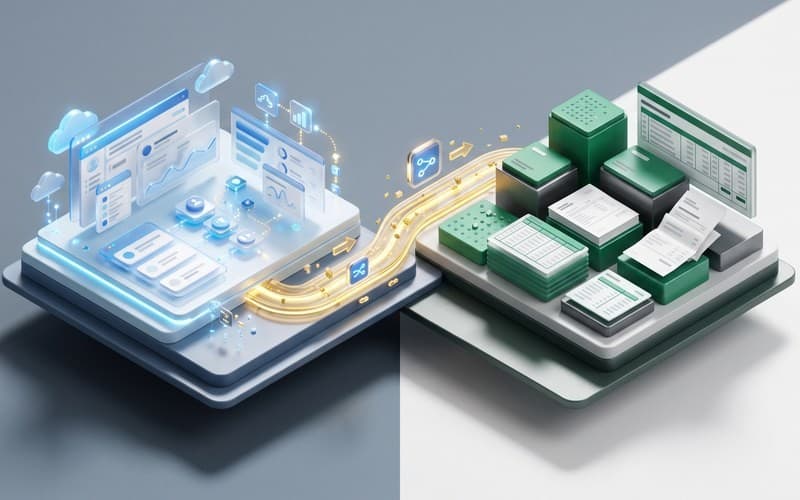
Les stacks marketing traditionnelles reposent sur des outils SaaS fragmentés, où chaque plateforme applique sa propre logique d'attribution en boîte noire et son propre silo de données isolé. Les outils de web analytics enregistrent les sessions des navigateurs, les plateformes publicitaires revendiquent des conversions basées sur des fenêtres d'attribution propriétaires et les plateformes CRM suivent les étapes du pipeline commercial de manière autonome. Cette fragmentation empêche toute visibilité transverse et contraint les équipes à passer des heures à réconcilier manuellement des feuilles de calcul contradictoires.
Pour les jeunes pousses en phase d'amorçage avec un canal d'acquisition unique, les tableaux de bord natifs peuvent temporairement suffire ; toutefois, dès lors que plusieurs canaux et commerciaux interagissent avec les mêmes comptes dans le cadre d'un reporting multi canal b2b, la modélisation native au data warehouse devient indispensable. Une stack reporting marketing centralisée place la vérité analytique au cœur du data warehouse. Grâce à une intégration CRM data warehouse, les vues de reporting interrogent des tables modélisées qui croisent les dépenses publicitaires brutes, la télémétrie web des clients et les enregistrements CRM vérifiés des opportunités commerciales. Cet analytics b2b setup permet également aux équipes d'ingénierie d'équilibrer de manière pragmatique la synchronisation par lots et le traitement en temps réel. Tandis que le monitoring à haute fréquence du parcours de navigation (clickstream) tire parti de flux d'événements en quasi-temps réel, les modèles complexes d'attribution et de pipeline financier sont calculés de façon plus économique via des traitements par lots programmés toutes les heures ou chaque jour, évitant ainsi des dépenses de calcul superflues tout en fournissant des instantanés de reporting cohérents.
Où le scaffolding par l'IA accélère les pipelines et où les ingénieurs doivent vérifier
Bâtir une infrastructure analytics moderne ne requiert plus des mois d'écriture manuelle de code répétitif. Les flux de travail d'ingénierie modernes exploitent des agents de programmation IA et des environnements dédiés pour générer le scaffolding d'un pipeline data warehouse marketing en quelques minutes : fichiers de transformation dbt, scripts de migration de schéma, squelettes de connecteurs d'API et tests unitaires pour modèles SQL. Cette accélération réduit considérablement les boucles de rétroaction du développement lors de la configuration initiale.
Toutefois, la génération de code par l'IA présente des modes de défaillance technique bien réels qui exigent la supervision d'ingénieurs seniors. Les modèles d'IA ne peuvent pas évaluer de manière autonome les nuances de souveraineté des données, anticiper les ruptures de schéma en amont, ni garantir l'exactitude mathématique des requêtes d'attribution complexes avec fenêtrage. En l'absence de contrôle, les scripts automatisés introduisent fréquemment des démultiplications de jointures (join fan-outs) insidieuses, des doublons de clés primaires ou une logique de fusion incrémentielle mal configurée qui corrompt les rapports historiques. Notre approche associe un scaffolding rapide par l'IA à des data engineers chevronnés qui appliquent une rigoureuse checklist implementation analytics : examen minutieux de chaque pull request, respect strict des normes de gouvernance des données, tests de charge sur les performances des requêtes et validation des décisions de déploiement final.
Que doit contenir votre checklist d'implémentation analytics pour prévenir la dérive des données ?
La dérive des données et les régressions silencieuses de schéma constituent les menaces opérationnelles les plus persistantes pour l'intégrité analytique. Disposer d'une checklist d'implémentation analytics explicite garantit que chaque instrumentation de tracking, connecteur de pipeline et modèle de transformation répond à des critères d'assurance qualité rigoureux avant d'éclairer la prise de décision stratégique au sein de votre setup analytics B2B et reporting.
Validation pré-lancement des schémas d'événements et assurance qualité
La validation pré-lancement commence dans les environnements de staging, bien avant que le code n'atteigne les branches de production. Les équipes d'ingénierie doivent exécuter des payloads d'événements synthétiques via des proxys de tracking afin de vérifier que le nom des événements, les types de propriétés obligatoires et les identifiants contextuels respectent strictement le plan de tracking. Des suites de tests automatisés doivent confirmer que les champs numériques ne peuvent pas être ingérés sous forme de chaînes de caractères et que les valeurs nulles déclenchent des alertes de schéma plutôt que des échecs d'ingestion silencieux.
Les protocoles d'assurance qualité doivent également valider la logique de réconciliation des identités lors des transitions d'un appareil à l'autre. Une checklist pré-lancement rigoureuse comprend notamment :
- Conformité au plan de tracking : Vérification automatisée par JSON Schema pour chaque payload d'événement côté client et côté serveur.
- Persistance de l'identité : Contrôle de bout en bout de l'association du cookie anonyme dès la première conversion sur formulaire de lead.
- Assertions de transformation : Tests automatisés validant l'unicité des colonnes, les valeurs non nulles et l'intégrité référentielle sur l'ensemble des clés étrangères.
Atténuer les changements de rupture liés aux mises à jour des API et des webhooks en amont
Les plateformes SaaS externes et les réseaux publicitaires mettent régulièrement à jour les versions de leurs API, modifient les payloads de leurs webhooks ou déprécient des endpoints de tracking. Sans monitoring proactif, le renommage inopiné d'un champ en amont peut casser silencieusement les modèles de transformation en aval, entraînant plusieurs jours de données manquantes avant que les analystes ne remarquent des écarts sur les tableaux de bord.
Pour limiter l'instabilité en amont, les pipelines de data warehouse doivent charger les payloads bruts dans des tables de staging agnostiques du schéma avant d'effectuer un parsing strict. Des moniteurs automatisés d'observabilité des données doivent suivre chaque jour les anomalies de volume, les seuils de fraîcheur et la dérive de schéma. Si un webhook en amont supprime une propriété attendue, des dead-letter queues capturent les payloads en échec afin de les rejouer une fois que les ingénieurs ont ajusté les modèles de transformation.
Enfin, la sécurité des données et la gouvernance de la confidentialité doivent demeurer continues. L'architecture analytics marketing doit appliquer un contrôle d'accès basé sur les rôles, un masquage au niveau des colonnes pour les données personnelles identifiables et des flux de suppression automatisés afin de répondre aux obligations de conformité.
Comment planifier et déployer votre architecture analytics marketing avec Canvas Developers
Le déploiement d'une architecture analytics marketing et de reporting prête pour la production exige une ingénierie rigoureuse, de la conception initiale des schémas à la maintenance continue des pipelines. Chez Canvas Developers, entreprise d'ingénierie logicielle disposant d'un bureau à Dhaka, nous proposons une gamme complète de services d'architecture analytics et de reporting, en concevant des systèmes de données sur mesure, des plateformes SaaS et des intégrations d'entreprise. Notre approche de livraison associe un développement accéléré par l'IA à une supervision humaine rigoureuse de l'ingénierie. Les agents de codage IA génèrent rapidement le code boilerplate des connecteurs, structurent les modèles dbt et rédigent les suites de tests, tandis que des ingénieurs seniors expérimentés pilotent l'architecture du système, auditent la sécurité des données, examinent chaque pull request et autorisent les mises en production.
Selon les exigences de gouvernance et de conformité de leur organisation, les clients peuvent choisir entre deux modèles transparents de prestation IA : 'Private / Local AI Engineering', qui s'appuie sur des modèles open-weight hébergés de manière privée au sein d'une infrastructure contrôlée par le client, ou 'Claude Code / OpenAI Codex Engineering', qui déploie des outils d'IA commerciaux selon des configurations cloud approuvées. Ce modèle permet aux équipes d'itérer rapidement sans compromettre la confidentialité des données, la propriété intellectuelle ni la fiabilité des pipelines.
Que vous ayez besoin de créer un nouveau pipeline de reporting de toutes pièces ou d'auditer et de renforcer une configuration existante, chaque projet débute par un cadrage précis, des jalons de développement convenus, des tests complets d'assurance qualité et une passation structurée. Pour évaluer votre stack de données active et planifier votre feuille de route d'implémentation, demandez une évaluation de cadrage via le formulaire de contact de Canvas Developers.
Étape par étape
Standardiser la taxonomie de tracking et la gouvernance des UTM
Établissez un plan de tracking formel avec une nomenclature d'événements objet-action, et appliquez des conventions de paramètres UTM standardisées en minuscules sur l'ensemble de vos canaux marketing.
Synchroniser les flux d'événements et les données du pipeline HubSpot CRM
Déployez des connecteurs d'entrepôt bidirectionnels pour ingérer la télémétrie brute aux côtés des fiches contacts, entreprises et transactions du CRM avec une résolution d'identité déterministe.
Modéliser les points de contact unifiés pour l'attribution et l'analyse de cohortes
Transformez les journaux d'événements intermédiaires et les jalons du CRM en tables d'attribution multi-touch et en modèles de cohortes à l'aide d'une logique SQL versionnée.