信頼性の高いマーケティング分析・レポーティング基盤は、分断された広告ダッシュボードや連携のないSaaSレポートを、自社で保有・検証可能なレベニューデータのためのマーケティング分析基盤へと置き換えます。成長を重視するB2B組織のマーケティング分析において、購買サイクルにはオーガニック検索、ペイドキャンペーン、製品トライアル、手厚い営業対応など、複数のステークホルダーが関与します。サイロ化したレポーティングや指標のみに依存すると、チャネル横断的な影響が見えにくくなり、アトリビューションの過大評価を招くだけでなく、経営陣が顧客獲得投資の最適化ではなくデータの妥当性をめぐる議論に終始することになります。
自社運用のデータウェアハウス パイプラインを確立し、ユーザーイベントやCRMのタッチポイントを統合スキーマへ集約することは、こうした運用の盲点を解消します。本実装ガイドでは、組織の成長に合わせて拡張可能なエンタープライズ水準のレポーティングスタックを導入するために必要な技術レイヤー、データモデリング規約、そしてエンジニアリングワークフローについて詳しく解説します。
分断されたプラットフォームダッシュボードが成長するB2Bマーケティングチームで機能しなくなる理由
B2Bマーケティングチームがベンダーごとにサイロ化したレポーティングに依存していると、アトリビューションモデルの不一致によりレベニューオペレーション全体で即座に摩擦が生じます。LinkedIn AdsやGoogle Search、プログラマティックディスプレイ広告などの主要な広告ネットワークは、それぞれ独立した測定システムで運用されています。各ネットワークは通常、独自のビュースルー期間やラストクリックルールに基づいて、獲得したコンバージョンを自社の成果として計上します。その結果、チャネル全体で数値を合算すると、レポート上の総コンバージョン数が実際のパイプライン創出数を大幅に上回ることが少なくありません。こうした重複計上は顧客獲得単価(CAC)の算出を歪め、各チャネルのパフォーマンスに対する経営陣の信頼を損なう原因となります。
こうした乖離は、広告プラットフォーム上の指標と実務上のCRMレコードを比較する際に、さらに顕著になります。広告ネットワークがカウントするのは未加工のクリック数やクライアント側でのタグ発火ですが、CRMシステムが追跡するのは選別された見込み顧客(クオリファイドリード)やデモ依頼、アカウントのパイプラインステージです。トラッキングブロッカーやブラウザのプライバシー制限、営業による選別・商談化サイクルのタイムラグなどが原因となり、広告プラットフォーム標準のタグだけではその後の営業活動と直接紐付けることができません。体系的なB2Bマーケティング分析基盤が整っていなければ、マーケティングリーダーは有料広告の費用と受注金額を照合できず、パイプラインの進行速度(ベロシティ)におけるボトルネックを特定することもできません。
また、業務の複雑化が進むにつれて、プラットフォーム標準のダッシュボードは構造上の限界に直面します。ツール内のレポーティング機能では、カスタムSQLによるデータ変換や、異なるWebセッションを横断したマルチタッチのアイデンティティ解決、複数四半期にわたる過去のステータス比較などに柔軟に対応することは困難です。専用のマーケティング分析・レポーティング基盤へ移行することで、データの蓄積と分析が特定のベンダーソフトウェアから切り離され、技術チームは自社の分析パイプライン全体を完全に自社で管理できるようになります。
一元化されたマーケティング分析基盤の構造とは?
堅牢な一元化されたマーケティング分析基盤は、テレメトリの収集、永続ストレージ、データ変換、そしてビジネスインテリジェンス(BI)をモジュール構造の階層に分離します。広告ネットワークやCRMシステムを脆弱な個別連携(ポイント・ツー・ポイント接続)で無理につなぎ合わせるのではなく、このアーキテクチャは、すべてのレコードにタイムスタンプを付与して検証し、発生元まで追跡可能な、監査性を備えたマーケティングデータ基盤のデータウェアハウスパイプラインを確立します。
Segmentによるイベント収集と顧客データストリーミング
テレメトリ層は、クライアントサイドおよびサーバーサイドでのイベント収集から始まります。顧客データインフラは、マーケティングWebサイト、Webアプリケーション、顧客ポータルを横断するインタラクション追跡を標準化し、マルチチャネル 分析 フレームワークの基盤を整えます。専用のSegment開発者プラットフォーム連携を通じて顧客データパイプラインを統合する際、チームはTwilio Segment destinationsドキュメントに記載された標準仕様に従い、自動リトライや一括バッチ処理機能を備えたクライアントSDKを使用して、標準的なtrack、page、identifyコールをストレージの送信先へとルーティングします。匿名デバイスID、セッションマーカー、認証済み顧客プロファイルなどのユーザー属性を保持することで、長期化するB2Bセールスサイクルにおいてもデバイスをまたぐインタラクションの紐付けが維持され、高精度なB2B マーケティング 分析が可能になります。
導入時には、取り込み(インジェスチョン)境界で厳格なスキーマ制御を設定することにより、不正な形式のペイロードや未検証のイベントプロパティが下流の分析テーブルを汚染するのを防ぎます。この防御的なフィルタリングにより、後続のレポーティングモデル全体でデータの整合性が保護されます。
中央データウェアハウスのストレージとインジェスチョン層の設計
未加工のイベントストリームや業務システムのAPI抽出データは、Snowflake、Google BigQuery、Amazon Redshiftなどの列指向クラウドデータウェアハウスに直接格納されます。このインジェスチョン層は、未加工で不変(イミュータブル)なテーブルを下流のレポーティングロジックから隔離します。厳格なコンプライアンスポリシーを持つ急成長企業では、プライベートで隔離されたクラウドデータウェアハウス環境を導入することが多い一方、迅速な価値創出(Time-to-Value)を求めるチームは、フルマネージド型のクラウドインフラストラクチャを活用します。
未加工ストレージ層の上位では、dbtなどの変換エンジンが、バージョン管理されたモジュール式SQLスクリプトをコンパイルし、整理されたセマンティックモデルを構築します。これらのデータ変換モデルは、ばらつきのあるタイムスタンプを正規化し、CRM データウェアハウス 連携を通じてCRMレコードのライフサイクルステージとWebタッチポイントを結合し、検証済みの指標をビジネスインテリジェンスツールに公開してマーケティング レポーティング 自動化を支えます。不変の未加工データを保持しておくことで、エンジニアリングチームは過去のテレメトリを失うことなく、過去に遡ってアトリビューション計算式を更新できます。
マーケティングデータウェアハウスパイプラインを段階的に構築する方法
信頼性の高いマーケティングデータウェアハウスパイプラインを運用し、データウェアハウス マーケティングにおける強固なマーケティング分析基盤を確立するには、イベントガバナンスから複数テーブルにわたるSQLデータモデリングに至る体系的なステップが不可欠です。エンジニアリングチームは、モノリシックな一括導入を試みるのではなく、事前にタクソノミーを検証し、堅牢なデータ取り込みコネクタを設定し、B2B マーケティング 分析・レポーティング基盤に向けて決定論的な変換モデルを構造化することで、データの信頼性を確立します。
ステップ1:トラッキングタクソノミーの標準化とUTMガバナンス
データパイプラインの精度低下は、トラッキングの境界部分で最も頻繁に発生します。トラッキングスクリプトを展開する前に、チームはイベント名、ペイロードプロパティ、およびインバウンドキャンペーンパラメータの厳格な命名規則を定めた、明確なトラッキング計画を策定する必要があります。イベント名には任意の文字列ではなく、オブジェクト・アクション構文(Form Submitted、Pricing Viewed、Demo Requested など)を採用すべきです。
キャンペーンパラメータのガバナンスでは、utm_source、utm_medium、utm_campaign、utm_content にわたって、英小文字と数字、ハイフン区切り、および標準化されたタクソノミーを徹底しなければなりません。エンジニアリングチームは、自動化されたコミット前リンターやURL生成テンプレートを設定し、大文字・小文字の表記揺れ(cpc と CPC の混在など)によってウェアハウスのテーブル内で流入元データが断片化するのを防ぎます。
ステップ2:イベントストリームとHubSpot CRMパイプラインレコードの同期
商用CRMオブジェクトと匿名のWebセッションストリームを連携させることで、ファネル上部(トップオブファネル)のアクティビティと実証済みの売上収益を結びつけることができます。耐障害性に優れたHubSpot CRM連携アーキテクチャを実装し、CRM データウェアハウス 連携を進める際、エンジニアリングチームはHubSpot クラウドデータストレージ連携ドキュメントに記載されている機能を活用します。このドキュメントでは、エンタープライズデータ基盤が、Snowflake、BigQuery、AWS S3にわたってコンタクト、会社、取引、チケット、カスタムオブジェクトなどの主要オブジェクトに対する双方向のウェアハウス同期をサポートしていることが示されています。
当社のエンジニアリング部門では、取引ステージの差分変更と不変なイベント履歴の双方を取り込む自動抽出パイプラインを構成します。HubSpotのCRMレコードとストリーミングログを統合する際、エンジニアは決定論的なアイデンティティスティッチング(ID統合)を実装します。これは、見込み顧客がリードフォームを送信するかサインインした瞬間に、匿名のセッションCookie(anonymous_id)を特定済みのコンタクトレコード(user_id)へと解決する仕組みです。シニアエンジニアは主キー制約やべき等性を持つアップサートロジック(SQLの MERGE 文など)を検証し、同期処理が集中する時間帯でも取引マイルストーンの重複を防ぎます。
ステップ3:アトリビューションとコホート分析に向けた統合タッチポイントのデータモデリング
未加工のイベントとCRMスナップショットがウェアハウスのステージングテーブルに格納されたら、変換レイヤーによってそれらを統合タッチポイントモデルへと正規化します。生成されるタッチポイントテーブルの各行は、標準化されたタイムスタンプ、キャンペーンチャネル、アカウント識別子、取引との関連付けがタグ付けされた、認証済みまたは匿名のインタラクションを表します。
アナリティクスエンジニアは、マルチチャネル 分析 フレームワークに基づき、初回接触(ファーストタッチ)、ポジションベース(U型またはW型)、時間減衰モデルなどのマルチタッチアトリビューションモデルをSQLで直接構築します。これらのモデルは、コホート分析と並行してパイプラインへの貢献度を算出し、初回のディスカバリーセッションから契約締結に至る商談サイクルの期間を追跡します。AIツールは定型的なSQL変換やステージングビューのスキャフォールディングを加速させてマーケティング レポーティング 自動化を後押しする一方、シニアエンジニアはウィンドウ関数、テーブル間結合のカーディナリティ、通貨換算を監査し、財務諸表レベルのレポーティング精度を確保します。
統合マルチチャネル分析フレームワークはサイロ化したレポーティングとどう異なるのか?
マーケティング分析基盤におけるレポーティングの選択肢を評価する際は、データウェアハウスネイティブなモデルと、従来のポイントソリューションによるダッシュボードを比較検討する必要があります。統合された強固なマルチチャネル分析フレームワークは、監査可能で透明性の高いデータモデルのもとに顧客の生データを統合することで、個別ベンダーツール間の数値の食い違いを解消します。
データウェアハウスネイティブなレポーティングモデルと分散型分析ツールの比較
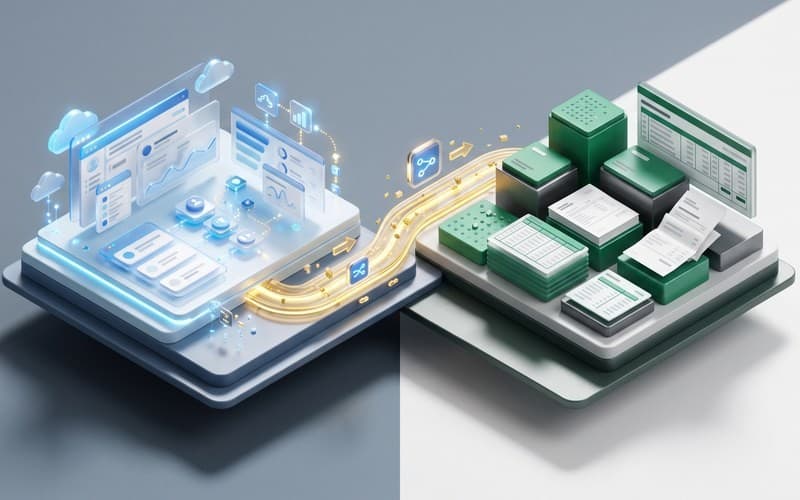
従来のマーケティングデータ基盤は、各プラットフォームがブラックボックス化された独自のアトリビューションロジックと孤立したデータサイロを抱える、分断されたSaaSツール群に依存しています。Webアナリティクスツールがブラウザセッションを記録し、広告プラットフォームが独自のルックバック期間(アトリビューションウィンドウ)に基づいてコンバージョンを主張し、CRMプラットフォームが独自に営業パイプラインのステージを追跡しているのが現状です。このようなデータの断片化は部門横断的な可視化を妨げ、矛盾するスプレッドシートの突合や手作業での調整に何時間も浪費させる原因となっています。
獲得チャネルが1つしかない初期段階のスタートアップであれば、各ツールのネイティブなダッシュボードでも一時的には十分かもしれません。しかし、複数のチャネルや営業担当者が同一アカウントに関与するB2Bマーケティング分析においては、データウェアハウスネイティブなデータモデリングが不可欠になります。データウェアハウス マーケティングの中核となる一元化されたマーケティング分析基盤は、データウェアハウス内に分析の基準となる真実を確立します。レポーティング用のビューは、広告費の生データ、顧客のWeb行動テレメトリ、そしてCRM データウェアハウス連携によって検証されたCRMレコードを結合したモデリング済みテーブルにクエリを実行します。この構成により、エンジニアリングチームはバッチ同期とリアルタイム処理を現実的にバランスさせることが可能になります。高頻度なクリックストリーム監視には準リアルタイムのストリーミングが適している一方、複雑なアトリビューションや収益パイプラインモデルは、1時間ごとや日次の定期バッチ実行で計算する方がコスト効率が高く、無駄なコンピュートコストを抑えながら、一貫したスナップショットによるマーケティングレポーティング自動化を実現できます。
AIスキャフォールディングがパイプラインを加速する領域と、エンジニアによる検証が不可欠な領域
現代的なマーケティング分析基盤の構築において、何カ月もの手作業による定型コード(ボイラープレート)の作成はもはや不要です。最新のエンジニアリングワークフローでは、AIコーディングエージェントやハーネスを活用することで、dbt変換ファイルのスキャフォールディング、スキーマ移行スクリプトの生成、APIコネクタスタブの作成、SQLモデルのユニットテスト記述をわずか数分で実行できます。この迅速化により、初期セットアップにおける開発のフィードバックループは大幅に短縮されます。
しかし、AIによるコード生成には明確な技術的障害パターン(故障モード)が存在するため、経験豊富なシニアエンジニアによる監視が不可欠です。AIモデルは、データ主権(データソブリンティ)に関する細かな要件を自律的に判断したり、上流側のスキーマにおける破壊的変更を予見したり、複雑なウィンドウ関数を用いたアトリビューションクエリの数学的正確性を担保したりすることはできません。人間のチェックなしに放置された自動化スクリプトは、意図しない結合ファンアウト(join fan-out)や主キーの重複、増分マージ(incremental merge)ロジックの設定ミスを頻繁に引き起こし、過去のレポーティングデータを破損させてしまいます。私たちのアプローチでは、AIによる迅速なスキャフォールディングと経験豊富なデータエンジニアを組み合わせています。エンジニアがすべてのプルリクエストを厳格にレビューし、データガバナンス基準を徹底し、クエリパフォーマンスの負荷テストを実施した上で、最終的なリリース承認を行います。
データドリフトを防ぐマーケティング分析基盤の実装チェックリストとは?
データドリフトや検知されにくいスキーマの破損(デグレ)は、分析の信頼性に対する最も根深い運用上の脅威です。明確な分析実装チェックリストを運用することで、貴社のB2B マーケティング 分析およびレポーティング環境において、すべてのトラッキング実装、パイプラインコネクタ、データ変換モデルが厳格な品質保証基準を満たし、経営陣の意思決定を安全に支える基盤を維持できます。
リリース前のイベントスキーマ検証と品質保証
リリース前検証は、コードが本番ブランチにマージされる前にステージング環境で開始します。エンジニアリングチームは、トラッキングプロキシ経由でテスト用の擬似イベントペイロードを実行し、イベント名、必須プロパティの型、コンテキスト識別子がトラッキングプランに厳密に準拠しているかを検証する必要があります。自動テストスイートでは、数値フィールドが文字列として取り込まれないこと、またnull値が発生した際にサイレントな取り込み失敗に終わるのではなく、スキーマアラートが確実に発火することを検証しなければなりません。
品質保証プロトコルでは、デバイスをまたぐアイデンティティ解決のロジックも検証する必要があります。網羅的なリリース前チェックリストには、以下の項目が含まれます。
- トラッキングプランへの準拠:すべてのクライアントおよびサーバーのイベントペイロードに対する自動JSONスキーマ検証。
- アイデンティティの永続性:初回リード獲得フォーム送信時における匿名Cookieの紐付けに関するエンドツーエンドの検証。
- データ変換のアサーション:すべての外部キーにわたるカラムの一意性、非null値、および参照整合性を確認する自動テスト。
上流APIおよびWebhookの更新による破壊的変更の軽減
外部SaaSプラットフォームや広告ネットワークは、日常的にAPIバージョンのアップデート、Webhookペイロードの変更、またはトラッキングエンドポイントの廃止を実施します。事前に対策を講じたプロアクティブな監視がなければ、予告のない上流でのフィールド名変更が下流のデータ変換モデルを密かに破損させ、アナリストがダッシュボードの数値の不整合に気づくまでに数日間にわたってデータが欠損する事態に陥りかねません。
上流システムの不安定性を緩和するためには、パイプラインで厳密なパースを実行する前に、未加工のペイロードをスキーマに依存しないステージングテーブルに取り込む設計が推奨されます。自動化されたデータオブザーバビリティ監視ツールにより、データ量の異常、鮮度のしきい値、スキーマドリフトを日々追跡すべきです。万が一、上流のWebhookで必要なプロパティが欠落した場合でも、デッドレターキューが失敗したペイロードを退避・保持するため、エンジニアがデータ変換モデルを修正した後に安全に再処理(リプレイ)できます。
最後に、データセキュリティとプライバシーガバナンスは継続的に維持されなければなりません。マーケティング分析・レポーティング基盤では、コンプライアンス要件を遵守するため、ロールベースのアクセス制御(RBAC)、個人識別情報(PII)のカラムレベルでのマスキング、および自動削除ワークフローを確実に適用する必要があります。
Canvas Developersと進めるマーケティング分析基盤の計画と導入
本番環境に対応したマーケティング分析・レポーティング基盤を導入・運用するには、初期のスキーマ設計から継続的なパイプライン保守に至るまで、規律あるエンジニアリングが求められます。ダッカにオフィスを構えるソフトウェアエンジニアリング企業であるCanvas Developersでは、カスタムデータシステム、SaaSプラットフォーム、エンタープライズ統合の構築を手がけ、包括的な分析・レポーティング基盤サービスを提供しています。当社のデリバリーアプローチは、AIを活用した開発の加速と、エンジニアによる厳格な監理を融合させたものです。AIコーディングエージェントがコネクタのボイラープレートを迅速に生成し、dbtモデルの雛形を作成し、テストスイートを起草する一方で、経験豊富なシニアエンジニアがシステムアーキテクチャの指揮、データセキュリティの監査、すべてのプルリクエストのレビュー、そして本番リリースの承認を行います。
組織のガバナンスやコンプライアンス要件に応じて、お客様は透明性の高い2つのAIデリバリーモデルからお選びいただけます。クライアント管理下のインフラ内でホストされるオープンウェイトモデルを活用する「Private / Local AI Engineering」、あるいは承認されたクラウド構成のもとで商用AIツールを展開する「Claude Code / OpenAI Codex Engineering」です。このモデルにより、チームはデータプライバシー、知的財産、パイプラインの信頼性を損なうことなく、迅速なイテレーションを実現できます。
新しいレポーティングパイプラインをゼロから構築する場合でも、既存の環境を監査して堅牢化する場合でも、すべてのプロジェクトは明確なスコープ定義、合意された開発マイルストーン、包括的な品質保証テスト、そして体系的な引き継ぎから始まります。現在稼働中のデータスタックを評価し、導入ロードマップを策定するには、Canvas Developersのお問い合わせフォームよりスコープ診断をご依頼ください。
手順
トラッキングタクソノミーとUTM管理の標準化
「オブジェクト-アクション」形式のイベント命名規則に基づく正式なトラッキングプランを策定し、すべてのマーケティングチャネルで小文字による標準化されたUTMパラメータ規約を徹底します。
イベントストリームとHubSpot CRMパイプラインの同期
双方向のウェアハウスコネクタを展開し、確定的ID解決を行いながら、生のテレメトリデータとともにHubSpot CRMのコンタクト、会社、取引レコードを取り込みます。
アトリビューションとコホート分析に向けた統合タッチポイントのモデリング
バージョン管理されたSQLロジックを活用し、ステージングされたイベントログとCRMマイルストーンを、マルチタッチアトリビューションテーブルやコホートモデルへと変換・統合します。