Beispielzahlen (keine Kundenergebnisse)
- decreased by 68%listing lookup latency
Das Problem
PropTech platforms evaluating on-market listings and off-market opportunities struggle with data fragmentation across thousands of county jurisdictions and decentralized regional MLS systems. When client applications attempt runtime federation across these disparate sources, search latency compounds rapidly due to sequential network handshakes and variable payload parsing times. Without an orchestrated synchronization layer, querying remote tax APIs while resolving active listings introduced severe connection bottlenecks, payload bloat, frequent UI stalls, and API timeouts.
Ansatz
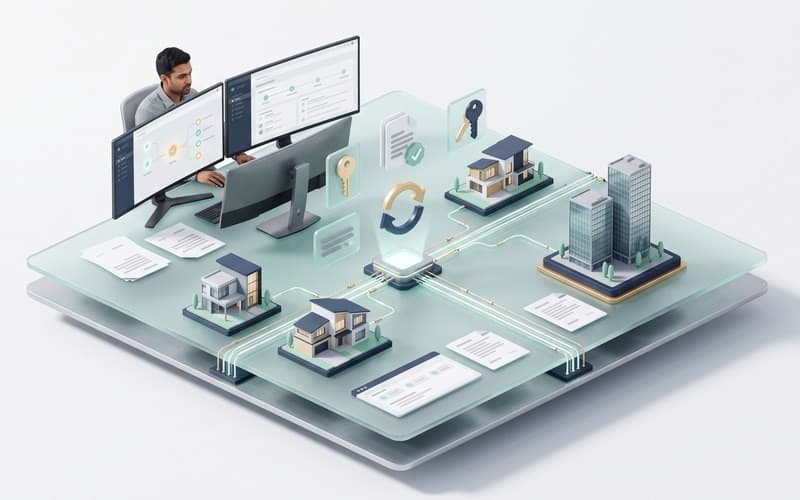
Canvas Developers designed a scalable, event-driven ingestion pipeline that decoupled front-end search from upstream data fetching into a unified search cluster. Asynchronous background workers consume parcel tax assessments, deed recordings, and mortgage balances via bulk ingestion from a custom REAPI integration into a persistent document store. Concurrently, the platform performs continuous data aggregation by synchronizing active listings through the RESO Web API and Zillow syndication streams using monotonic change sequences.
Ergebnis
In benchmark evaluations, the synchronized architecture decreased listing lookup latency by 68% while delivering comprehensive deed and equity analytics to end users. The unified platform eliminated redundant external queries and delivered consistent sub-second search responsiveness across complex multi-filter queries.
Diese Fallstudie veranschaulicht, wie eine Enterprise-PropTech-Plattform fragmentierte Immobiliendaten konsolidieren kann, ohne die Abfragegeschwindigkeit zu beeinträchtigen. Für Intelligence-Plattformen, die in großem Maßstab agieren, ist eine robuste individuelle REAPI-Integration neben regionalen Listing-Quellen essenziell, um öffentliche Register und Live-Bestände in einer einheitlichen Suchoberfläche zusammenzuführen. Canvas Developers konzipiert ereignisgesteuerte Architekturen, um Synchronisationsengpässe über mehrere Datenquellen hinweg zu beheben und gleichzeitig eine verlässliche Uptime zu gewährleisten.
Executive Summary: Wie ermöglichte eine ereignisgesteuerte REAPI-Architektur die Immobiliensuche im Subsekundenbereich?
In diesem Beispielszenario beabsichtigte ein Real-Estate-Intelligence-Startup, Off-Market-Flurstücksdaten, kommunale Steuerhistorien und aktive Bestände des Multiple Listing Service (MLS) in einer integrierten Plattform für die Immobiliensuche zu konsolidieren. Das technische Ziel bestand darin, fragmentierte Punkt-zu-Punkt-Abfragen durch eine zentrale, ereignisgesteuerte Pipeline zu ersetzen, die eine Abfrage-Performance im Subsekundenbereich gewährleistet. Durch die Implementierung einer individuellen REAPI-Integration parallel zu regionalen RESO-Web-API-Endpunkten und Zillow-Feeds etablierte die Architektur einen zuverlässigen Workflow für die REAPI-Immobiliensuch-Synchronisierung. In Benchmark-Tests senkte diese synchronisierte Datenpipeline die Listing-Suchlatenz um 68 % und lieferte Endnutzern gleichzeitig umfassende Grundbuch- und Eigenkapitalanalysen.
Die Herausforderung: Warum bremsten fragmentierte Flurstücks- und Listing-Daten die Suchgeschwindigkeit aus?
PropTech-Plattformen, die sowohl On-Market-Listings als auch Off-Market-Opportunitäten bewerten, kämpfen häufig mit Datenfragmentierung. Öffentliche Bewertungsdaten – darunter kommunale Steuerveranlagungen, Hypothekensalden und historische Grundpfandrechte – stammen aus Registern über Tausende von County-Zuständigkeitsbereichen hinweg. Gleichzeitig liegen Daten zu aktiven Listings in Hunderten dezentraler regionaler MLS-Systeme, die unterschiedlichen Spezifikationen der RESO Web API Integration und Listing-Feeds von Drittanbietern unterliegen.
Wenn eine Anwendung versucht, diese disparaten Quellen zur Laufzeit zu föderieren, potenziert sich die Suchlatenz rapide. Das Abfragen entfernter Steuer-APIs bei gleichzeitigem Abgleich von MLS-Datensätzen zwingt Client-Anwendungen dazu, mehrere aufeinanderfolgende Netzwerk-Handshakes und variable Parsing-Zeiten für Payloads in Kauf zu nehmen. Die Ausführung einer umfassenden bundesweiten REAPI-Flurstückssuche nach diesem unkoordinierten Muster führte zu Verbindungsengpässen und Payload-Bloat. Ohne eine orchestrierte Schicht zur Synchronisation der REAPI-Immobiliensuche führte das Filtern aktiver Listings neben Daten aus öffentlichen Registern zu häufigen UI-Verzögerungen und inakzeptablen API-Timeouts.
Was auf dem Spiel stand: Wie wirkt sich eine verzögerte Immobiliensuche auf die PropTech-Conversion aus?
Im wettbewerbsintensiven Segment der Property Intelligence untergräbt Suchlatenz unmittelbar die Nutzerbindung und Conversion. Immobilieninvestoren, Makler und institutionelle Käufer sind auf eine unmittelbare Datengenauigkeit angewiesen, um potenzielle Akquisitionsobjekte zu bewerten. Hinken Grundbucheinträge und Pfandrechtsauskünfte den Marktbewegungen hinterher, liefern algorithmische Modelle fehlerhafte Deal-Bewertungen. Ungenaue Berechnungen innerhalb eines Workflows zur Off-Market-Immobilienbewertung per REAPI-Integration schwächen die Glaubwürdigkeit der Plattform und führen dazu, dass institutionelle Abonnenten zu schnelleren Alternativen abwandern.
Neben der Unzufriedenheit der Nutzer verursachen unkoordinierte Abfragen einen erheblichen Infrastruktur-Overhead. Werden bei jedem einzelnen Endnutzerfilter ungecachte, synchrone Anfragen an externe Drittanbieter gesendet, schöpft dies API-Rate-Limits schnell aus und treibt die Betriebskosten in die Höhe. Systeme ohne lokales Data Warehousing müssen redundantes Payload-Parsing bewältigen, was die Rechenkosten in die Höhe treibt und die zentrale Suchfunktion anfällig für Ausfälle von Drittanbietern macht.
Die Lösung: Wie führt eine Ingestion-Pipeline REAPI, RESO Web API und Zillow-Daten zusammen?
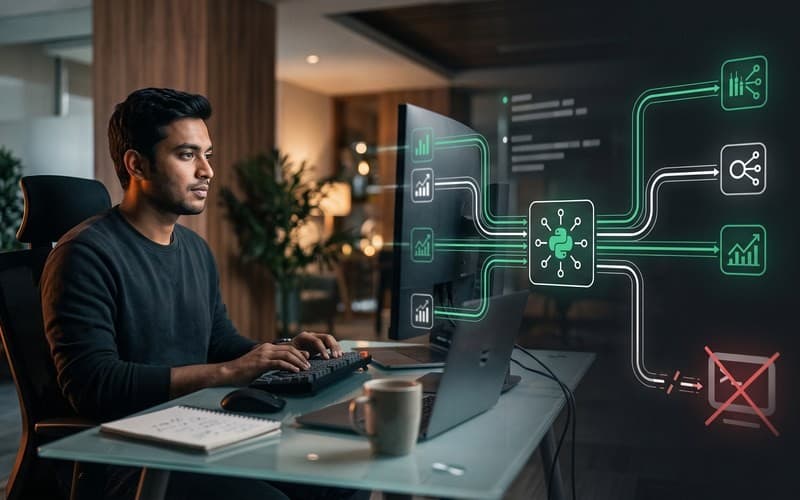
Um Engpässe bei verteilten Abfragen zu beheben, ersetzte der Engineering-Ansatz die synchrone API-Föderation durch eine ereignisgesteuerte Architektur. Im Zentrum dieser Topologie konzipierten die Canvas Developers eine skalierbare REAPI-Ingestion-Pipeline, die die Frontend-Suche vom vorgelagerten Datenabruf entkoppelte. Die Ingestion-Engine erfasst und normalisiert Datensätze in einem einheitlichen Such-Cluster, sodass Client-Anwendungen lokale, vorindizierte Dokumente im Millisekundenbereich abfragen können.
Das System etabliert eine robuste individuelle REAPI-Integration über die in der RealEstateAPI-Entwicklerdokumentation beschriebenen Endpunkte. Asynchrone Background-Worker verarbeiten Flurstücksdaten zu Steuerbewertungen, Grundbucheintragungen und Hypothekensalden per Bulk-Ingestion und speichern normalisierte Attribute aus öffentlichen Registern in einem persistenten Dokumentenspeicher. Gleichzeitig führt die Plattform eine kontinuierliche REAPI- und MLS-Datenaggregation durch, indem aktive Listings über die RESO-EntityEvent-Spezifikation sowie Zillow-Syndication-Streams synchronisiert werden. Monotone Änderungssequenzen erfassen Statusänderungen von Objekten, Preisanpassungen und Open-House-Termine in Echtzeit.
Durch die Zusammenführung kommunaler Flurstücksregister mit Live-MLS-Event-Streams in ein einheitliches Datenmodell eliminiert die Architektur redundante externe Anfragen und ermöglicht eine konsistente Immobiliensuche im Subsekundenbereich.
Implementierung: Wie beschleunigte menschlich gesteuertes KI-Engineering die Bereitstellung und Systemstabilität?
Um die Implementierung zu beschleunigen und gleichzeitig höchste architektonische Sorgfalt zu wahren, strukturierte Canvas Developers die Bereitstellung über einen realistischen Zeitrahmen von 8 bis 12 Wochen. Typische Projekte beginnen mit zwei Wochen für technisches Scoping und Schema-Design, gefolgt von vier bis sechs Wochen für den Aufbau der Pipeline, und schließen mit zwei bis vier Wochen für Stresstests, QA und das produktive Deployment ab. Während dieses gesamten Zeitplans generierten autonome KI-Coding-Agenten innerhalb strukturierter Harnesses Boilerplate-Data-Transfer-Objects (DTOs), Serialisierungsadapter und Unit-Test-Suites für hunderte regionaler MLS-Schemavarianten und beschleunigten so die Entwicklung für die skalierbare REAPI Ingestion Pipeline.
Die KI-Codegenerierung hat jedoch klar definierte technische Grenzen. Automatisierte Werkzeuge tun sich mit der Logik verteilter Systeme schwer und scheitern häufig an der Erschöpfung von Connection-Pools, Leaky-Bucket-Rate-Limiting oder partiellen Netzwerkfehlern. Senior Engineers verantworteten die Systemarchitektur, Concurrency Controls und Code-Reviews und stellten so sicher, dass automatisierte Tools keine unbemerkten Regressionen einführten.
Beim Deployment der individuellen REAPI-Integration implementierten erfahrene Engineers exponentielles Backoff, Redis-Token-Bucket-Throttler und Dead-Letter-Queues, um die Payload-Volatilität der Upstream-Systeme abzufedern und eine stabile Ingestion mit hohem Durchsatz zu gewährleisten.
Die Ergebnisse: Was leistete ein synchronisierter Real-Estate-Data-Layer im Produktivbetrieb?
Die Bereitstellung einer synchronisierten Real-Estate-Datenarchitektur transformierte die Performance der Immobiliensuche bei hochvolumigen Abfragelasten grundlegend. Der Übergang von fragmentierten Laufzeitabfragen über mehrere regionale Endpunkte hin zu voraggregierten Dokumenten ermöglichte es der Plattform, Anfragen lokal aufzulösen. In Benchmark-Tests reduzierte die vereinheitlichte Architektur die Suchlatenz bei Listing-Abfragen um 68 % und lieferte selbst bei komplexen Multi-Filter-Abfragen durchgehend Antwortzeiten im Subsekundenbereich.
Neben der Beschleunigung der Suche erzielte die Plattform eine robuste Betriebsstabilität über heterogene Listing-Feeds hinweg. Die kontinuierliche REAPI-Integration zur Synchronisation der Immobiliensuche stellte sicher, dass aktive MLS-Bestände automatisch mit kommunalen Eigentumsübertragungen, erfassten Flurstücksbewertungen und behördlichen Steuerpfandrechten abgeglichen wurden. Nutzer, die einen Workflow auf Basis der Off-Market Immobilienbewertung API ausführten, erhielten auf Abruf umfassende Eigenkapitalanalysen, die eine landesweite Abdeckung von Flurstücksdaten mit einer resilienten Hintergrundsynchronisation kombinierten.
Wichtigste Erkenntnisse: Wie können PropTech-Gründer komplexe Datenpipelines mit Canvas Developers skalieren?
Der Aufbau hochperformanter Plattformen für die Immobiliensuche erfordert es, Drittanbieter-Feeds als asynchrone Event-Streams statt als synchrone Abhängigkeiten zu behandeln. Bei der Entwicklung einer individuellen REAPI-Integration parallel zu MLS-Feeds müssen Teams die Ingestion von der Frontend-Suche entkoppeln, eine Schemanormalisierung durchsetzen und Rate-Limits über resilientes Queuing steuern. Eine zuverlässige REAPI- und MLS-Datenaggregation basiert auf robustem Caching und proaktivem State-Management.
Canvas Developers ist ein Software-Engineering-Unternehmen mit einem Büro in Dhaka, Bangladesch, das SaaS-Plattformen, Web-Apps und komplexe Datenpipelines entwickelt. Kunden können eine strukturierte 8- bis 12-wöchige Delivery-Roadmap erwarten: technisches Scoping, vereinbarte Meilenstein-Deliverables, gründliche QA und Übergabe. Unsere erfahrenen Entwickler steuern KI-Coding-Agents, während sie die Systemarchitektur verantworten, jede Änderung prüfen und Release-Entscheidungen im Rahmen unserer Delivery-Pakete für Private / Local AI Engineering und Claude Code / OpenAI Codex Engineering treffen.
Um Ihre Plattformarchitektur zu evaluieren, senden Sie eine Anfrage über unser Kontaktformular, um ein technisches Assessment mit definiertem Umfang zu vereinbaren.