예시 수치(고객 성과 아님)
- decreased by 68%listing lookup latency
문제
PropTech platforms evaluating on-market listings and off-market opportunities struggle with data fragmentation across thousands of county jurisdictions and decentralized regional MLS systems. When client applications attempt runtime federation across these disparate sources, search latency compounds rapidly due to sequential network handshakes and variable payload parsing times. Without an orchestrated synchronization layer, querying remote tax APIs while resolving active listings introduced severe connection bottlenecks, payload bloat, frequent UI stalls, and API timeouts.
접근 방식
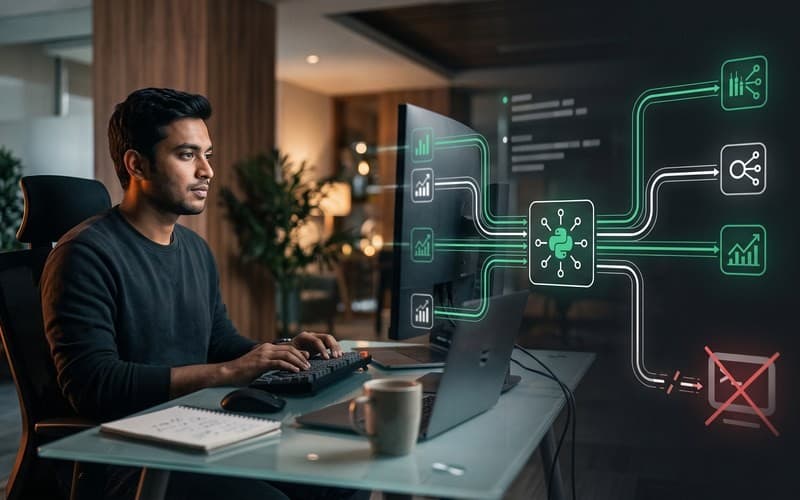
Canvas Developers designed a scalable, event-driven ingestion pipeline that decoupled front-end search from upstream data fetching into a unified search cluster. Asynchronous background workers consume parcel tax assessments, deed recordings, and mortgage balances via bulk ingestion from a custom REAPI integration into a persistent document store. Concurrently, the platform performs continuous data aggregation by synchronizing active listings through the RESO Web API and Zillow syndication streams using monotonic change sequences.
성과
In benchmark evaluations, the synchronized architecture decreased listing lookup latency by 68% while delivering comprehensive deed and equity analytics to end users. The unified platform eliminated redundant external queries and delivered consistent sub-second search responsiveness across complex multi-filter queries.
본 사례 연구는 엔터프라이즈 프롭테크 플랫폼이 쿼리 응답 속도를 저하시키지 않으면서 파편화된 부동산 인텔리전스를 통합할 수 있는 방식을 보여줍니다. 대규모로 운영되는 인텔리전스 플랫폼의 경우, 공공 기록과 실시간 매물을 일관된 검색 인터페이스로 통합하려면 지역 매물 소스와 함께 견고한 맞춤형 REAPI 연동을 구축하는 것이 필수적입니다. Canvas Developers는 안정적인 가동 시간을 유지하면서 다중 소스 동기화 병목 현상을 해결하는 이벤트 기반 아키텍처를 설계합니다.
핵심 요약: 이벤트 기반 REAPI 아키텍처는 어떻게 1초 미만의 매물 탐색을 가능하게 했는가?
본 시나리오에서는 한 부동산 인텔리전스 스타트업이 비공개 매물의 필지 기록, 지자체 세금 내역, 그리고 활성화된 Multiple Listing Service(MLS) 매물 인벤토리를 하나의 통합 매물 탐색 플랫폼으로 통합하고자 했습니다. 주요 기술적 목표는 1초 미만의 쿼리 성능을 유지하는 중앙 집중형 이벤트 기반 파이프라인을 구축하여 파편화된 점대점(point-to-point) 쿼리를 대체하는 데 초점을 맞추었습니다. 해당 아키텍처는 지역별 RESO Web API 연동 엔드포인트 및 Zillow 피드와 함께 맞춤형 REAPI 연동을 구현함으로써, 신뢰할 수 있는 REAPI 매물 검색 동기화 워크플로를 구축했습니다. 벤치마크 평가 결과, 이 동기화된 부동산 데이터 파이프라인은 최종 사용자에게 포괄적인 소유권 및 자산 가치 분석 데이터를 제공하는 동시에 매물 검색 지연 시간을 68% 단축했습니다.
도전 과제: 파편화된 필지 및 매물 데이터가 검색 속도를 저하시킨 이유는 무엇이었을까요?
공개 매물과 비공개 매물 기회를 모두 평가하는 프롭테크 플랫폼은 데이터 파편화로 인해 프롭테크 데이터 연동에 어려움을 겪는 경우가 많습니다. 지자체 세금 평가액, 모기지 잔액, 과거 담보권 설정 이력 등을 포함한 공공 평가 데이터는 수천 개에 달하는 카운티 관할 구역의 등록 기관에서 생성됩니다. 이와 동시에, 활성 매물 데이터는 저마다 상이한 RESO Web API 연동 규격과 서드파티 신디케이션 피드가 적용되는 수백 개의 분산된 지역 MLS 시스템에 흩어져 있어, 단일한 MLS 데이터 통합을 어렵게 만듭니다.
안정적인 부동산 데이터 파이프라인 없이 애플리케이션이 이처럼 서로 다른 소스 전반에서 런타임 페더레이션을 시도하면 검색 지연 시간이 급격히 가중됩니다. 원격 세무 API를 호출하는 동시에 MLS 기록을 조회하는 부동산 API 연동 방식은, 클라이언트 애플리케이션으로 하여금 다중 순차 네트워크 핸드셰이크와 가변적인 페이로드 파싱 시간을 감수하게 만듭니다. 이러한 조율되지 않은 패턴 하에서 포괄적인 REAPI 전국 필지 검색을 실행할 경우 연결 병목 현상과 페이로드 비대화가 발생했습니다. 체계적으로 조율된 맞춤형 REAPI 연동 기반의 REAPI 매물 검색 동기화 데이터 계층 없이는, 지자체 공공 기록과 활성 매물을 함께 필터링할 때 빈번한 UI 멈춤 현상과 용인하기 어려운 API 타임아웃이 발생했습니다.
주요 쟁점: 지연된 매물 탐색은 프롭테크 전환율에 어떤 영향을 미치는가?
경쟁이 치열한 부동산 인텔리전스 시장에서 검색 지연 시간은 사용자 유지율과 전환율을 직접적으로 저해합니다. 부동산 투자자, 중개인, 기관 매수자는 인수 대상을 평가할 때 데이터의 즉각적인 정확도에 크게 의존합니다. 소유권 이전 기록과 근저당 공시 내역이 시장 동향보다 늦게 반영되면 알고리즘 모델은 결함이 있는 거래 평가 결과를 도출하게 됩니다. 비공개 매물 가치 평가를 위한 맞춤형 REAPI 연동 워크플로에서 발생하는 부정확한 계산은 플랫폼 신뢰도를 떨어뜨리고, 기관 가입자가 더 빠른 대안을 찾아 이탈하게 만듭니다.
단순한 사용자 불만을 넘어, 체계적으로 조율되지 않은 쿼리 요청은 심각한 인프라 오버헤드를 초래합니다. 최종 사용자의 필터 조건마다 외부 벤더에 캐싱되지 않은 동기식 요청을 전송하면 API 호출 한도가 빠르게 소진되고 운영 비용이 급증합니다. 로컬 데이터 웨어하우징이 갖춰지지 않은 시스템은 중복된 페이로드 파싱을 반복해야 하므로 컴퓨팅 비용이 증가하며, 핵심 검색 기능이 외부 서드파티 장애에 취약해집니다.
솔루션: 수집 파이프라인은 어떻게 REAPI, RESO Web API, Zillow 데이터를 통합하는가?
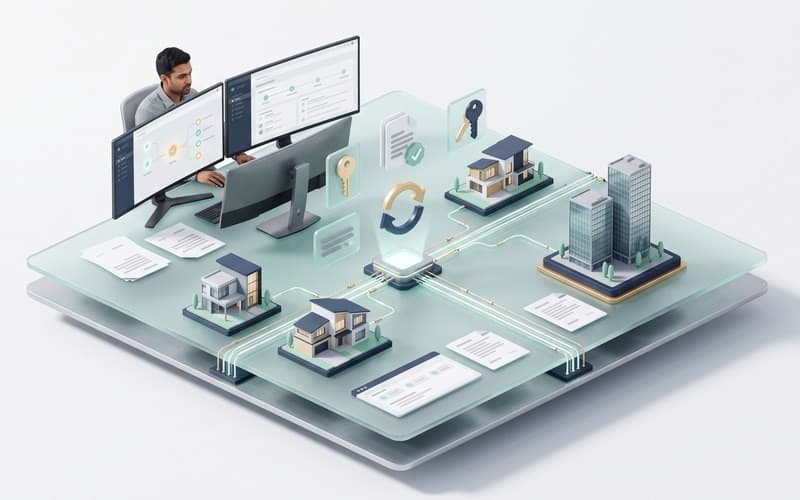
분산 쿼리 병목 현상을 해결하기 위해, 엔지니어링 접근 방식은 동기식 API 페더레이션을 이벤트 기반 아키텍처로 대체했습니다. 이러한 토폴로지의 중심에서 Canvas Developers는 프론트엔드 검색과 업스트림 데이터 가져오기를 분리하는 확장 가능한 REAPI 수집 파이프라인을 설계했습니다. 수집 엔진은 레코드를 수집하고 정규화하여 통합 검색 클러스터에 반영함으로써, 클라이언트 애플리케이션이 로컬에 사전 인덱싱된 문서를 수 밀리초 만에 쿼리할 수 있도록 지원합니다.
본 시스템은 RealEstateAPI 개발자 문서에 명시된 엔드포인트를 활용하여 견고한 맞춤형 REAPI 연동을 구축합니다. 비동기 백그라운드 워커는 대량 수집 방식을 통해 필지 과세 평가액, 등기 기록, 모기지 잔액을 처리하며, 정규화된 공공 속성을 영구 문서 저장소에 저장합니다. 이와 동시에 플랫폼은 RESO EntityEvent 사양 및 Zillow 신디케이션 스트림을 통해 활성 매물을 동기화함으로써 지속적인 REAPI 및 MLS 데이터 애그리게이션을 수행합니다. 단조 변경 시퀀스는 매물 상태 변경, 가격 조정, 오픈하우스 일정을 실시간으로 추적합니다.
지자체 필지 기록과 실시간 MLS 이벤트 스트림을 단일 데이터 모델로 조화롭게 통합함으로써, 해당 아키텍처는 불필요한 외부 요청을 제거하고 1초 미만의 일관된 매물 조회를 제공합니다.
구현: 인간 주도 AI 엔지니어링은 어떻게 딜리버리와 시스템 안정성을 가속화했는가?
아키텍처의 엄격한 완성도를 유지하면서 구현 속도를 가속화하기 위해, Canvas Developers는 8~12주의 현실적인 타임라인에 걸쳐 딜리버리 일정을 구조화했습니다. 일반적인 프로젝트는 2주간의 기술적 범위 정의 및 스키마 설계로 시작하여 4~6주간의 부동산 데이터 파이프라인 구축을 거친 뒤, 2~4주간의 부하 테스트, QA 및 프로덕션 배포로 마무리됩니다. 이러한 일정 전반에서 구조화된 하네스(harness) 환경 내에서 동작하는 자율형 AI 코딩 에이전트가 수백 개에 달하는 지역별 MLS 데이터 통합 스키마 변형에 맞춰 상용구 데이터 전송 객체(DTO), 직렬화 어댑터, 단위 테스트 스위트를 자동 생성함으로써 확장 가능한 REAPI 수집 파이프라인의 개발을 크게 가속화했습니다.
하지만 AI 코드 생성에는 명확한 기술적 한계가 존재합니다. 자동화 도구는 분산 시스템 로직을 처리하는 데 취약하여, 커넥션 풀 고갈(connection pool exhaustion), 리키 버킷(leaky-bucket) 속도 제한, 또는 부분적인 네트워크 장애 등에 제대로 대응하지 못하는 경우가 많습니다. 이에 따라 시니어 엔지니어가 시스템 아키텍처, 동시성 제어, 코드 리뷰를 직접 총괄하여 자동화 도구로 인한 잠재적 결함(silent regression)이 발생하지 않도록 철저히 관리했습니다.
맞춤형 REAPI 연동 배포 단계에서는 숙련된 엔지니어들이 지수 백오프(exponential backoff), Redis 토큰 버킷 스로틀러, 데드 레터 큐(dead-letter queue)를 구축하여 업스트림 페이로드의 급격한 변동성을 흡수하고 안정적인 고처리량 데이터 수집을 보장했습니다.
도입 성과: 동기화된 부동산 데이터 계층이 프로덕션 환경에서 가져온 성과는 무엇일까요?
동기화된 부동산 데이터 아키텍처를 구축함으로써 대규모 검색 워크로드 전반의 매물 탐색 성능을 획기적으로 개선했습니다. 여러 지역 엔드포인트에서 런타임 시점에 실행되던 파편화된 조회 방식에서 벗어나 사전 애그리게이션된 문서 구조로 전환함에 따라, 플랫폼이 쿼리를 로컬에서 직접 처리할 수 있게 되었습니다. 벤치마크 테스트 결과, 이러한 통합 아키텍처는 매물 조회 검색 지연 시간을 68% 단축하며 복잡한 다중 필터 쿼리 전반에서 1초 미만의 일관된 검색 응답성을 제공했습니다.
검색 속도 향상과 더불어, 플랫폼은 이기종 데이터 피드 전반에서 견고한 운영 안정성을 확보했습니다. 지속적인 REAPI 매물 검색 동기화를 통해 활성 MLS 매물 인벤토리가 지자체 소유권 이전 등기 기록, 공시 필지 평가액, 강제 조세 압류 내역과 자동으로 대조·조율되었습니다. 비공개 매물 가치 평가 맞춤형 REAPI 연동 워크플로우를 실행하는 사용자는 전국 단위의 필지 기록 커버리지와 안정적인 백그라운드 동기화가 결합되어, 온디맨드 방식으로 종합적인 자산 가치 분석 데이터를 제공받았습니다.
핵심 요약: 프롭테크 창업자가 Canvas Developers와 함께 복잡한 부동산 데이터 파이프라인을 확장하는 방법
고성능 매물 탐색 플랫폼을 구축하려면 서드파티 피드를 동기적 종속 항목이 아닌 비동기 이벤트 스트림으로 다루어야 합니다. MLS 피드와 함께 맞춤형 REAPI 연동을 개발할 때, 개발팀은 데이터 수집을 프론트엔드 검색과 분리하고, 스키마 정규화를 적용하며, 복원력 있는 큐잉을 통해 호출 제한(rate limit)을 관리해야 합니다. 신뢰할 수 있는 REAPI 및 MLS 데이터 애그리게이션은 견고한 캐싱과 선제적인 상태 관리에 달려 있습니다.
Canvas Developers는 방글라데시 다카에 오피스를 둔 소프트웨어 엔지니어링 기업으로, SaaS 플랫폼, 웹 애플리케이션 및 복잡한 데이터 파이프라인을 구축합니다. 고객사는 기술 범위 정의, 합의된 마일스톤 산출물, 철저한 QA 및 인수인계로 구성된 체계적인 8~12주 딜리버리 로드맵을 기대하실 수 있습니다. 당사의 숙련된 엔지니어들은 시스템 아키텍처를 총괄하고 모든 변경 사항을 검토하며 배포를 결정하는 한편, Private / Local AI Engineering 및 Claude Code / OpenAI Codex Engineering 딜리버리 패키지 전반에서 AI 코딩 에이전트를 지휘합니다.
귀사의 플랫폼 아키텍처를 평가하고 맞춤형 기술 평가 일정을 잡으시려면 문의 양식을 통해 상담을 신청해 주세요.