Chiffres illustratifs (pas des résultats clients)
- decreased by 68%listing lookup latency
Le problème
PropTech platforms evaluating on-market listings and off-market opportunities struggle with data fragmentation across thousands of county jurisdictions and decentralized regional MLS systems. When client applications attempt runtime federation across these disparate sources, search latency compounds rapidly due to sequential network handshakes and variable payload parsing times. Without an orchestrated synchronization layer, querying remote tax APIs while resolving active listings introduced severe connection bottlenecks, payload bloat, frequent UI stalls, and API timeouts.
Approche
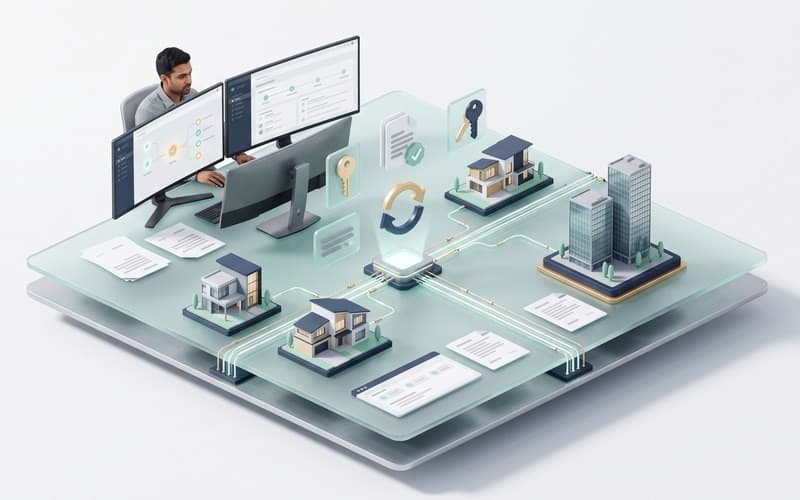
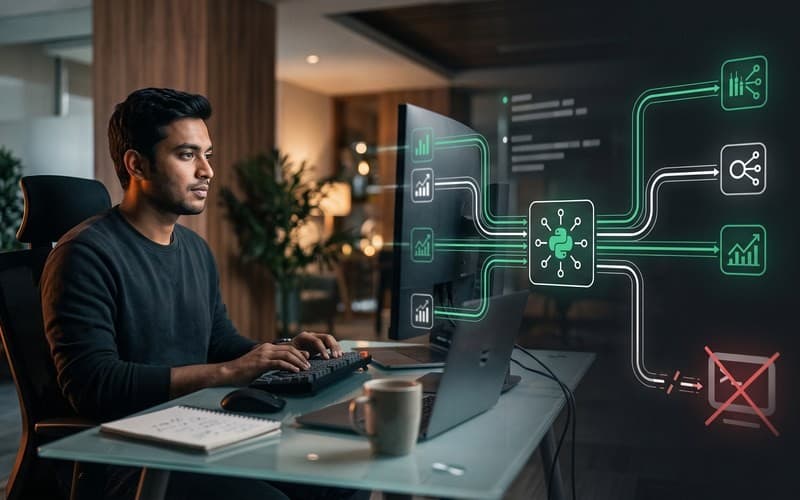
Canvas Developers designed a scalable, event-driven ingestion pipeline that decoupled front-end search from upstream data fetching into a unified search cluster. Asynchronous background workers consume parcel tax assessments, deed recordings, and mortgage balances via bulk ingestion from a custom REAPI integration into a persistent document store. Concurrently, the platform performs continuous data aggregation by synchronizing active listings through the RESO Web API and Zillow syndication streams using monotonic change sequences.
Résultat
In benchmark evaluations, the synchronized architecture decreased listing lookup latency by 68% while delivering comprehensive deed and equity analytics to end users. The unified platform eliminated redundant external queries and delivered consistent sub-second search responsiveness across complex multi-filter queries.
Cette étude de cas démontre comment une plateforme PropTech d'entreprise peut consolider des informations immobilières fragmentées sans compromettre la réactivité des requêtes. Pour les plateformes de données opérant à grande échelle, concevoir une intégration REAPI sur mesure robuste aux côtés des sources d'annonces régionales est essentiel pour unifier les registres publics et l'inventaire en temps réel au sein d'une interface de recherche cohérente. Canvas Developers conçoit des architectures orientées événements afin de résoudre les goulots d'étranglement de synchronisation multisource tout en maintenant une disponibilité fiable.
Synthèse : comment une architecture REAPI orientée événements a-t-elle permis une découverte en moins d'une seconde ?
Dans ce scénario illustratif, une startup spécialisée dans l'intelligence immobilière cherchait à consolider des données parcellaires hors marché, des historiques fiscaux municipaux et l'inventaire actif du Multiple Listing Service (MLS) au sein d'une plateforme intégrée de découverte de biens immobiliers. L'objectif technique consistait à remplacer des requêtes point à point fragmentées par un pipeline centralisé et orienté événements, garantissant des performances de requête inférieures à la seconde. En mettant en œuvre une intégration REAPI sur mesure aux côtés de points de terminaison régionaux RESO Web API et de flux Zillow, l'architecture a établi un flux de travail fiable de synchronisation recherche immobilière REAPI. Lors d'évaluations de référence, ce pipeline de données synchronisé a réduit de 68 % la latence de recherche d'annonces, tout en offrant aux utilisateurs finaux des analyses complètes sur les actes de propriété et les capitaux propres.
Le défi : pourquoi la fragmentation des données parcellaires et d'annonces ralentissait-elle la vitesse de recherche ?
Les plateformes PropTech qui évaluent à la fois les annonces sur le marché et les opportunités hors marché sont fréquemment confrontées à la fragmentation des données. Les données des évaluateurs publics, notamment les évaluations fiscales municipales, les soldes hypothécaires et l'historique des privilèges, proviennent de registres répartis sur des milliers de juridictions de comtés. Parallèlement, les données d'annonces actives résident au sein de centaines de systèmes MLS régionaux décentralisés, régis par des spécifications RESO distinctes et des flux de syndication tiers.
Lorsqu'une application tente une fédération à l'exécution entre ces sources disparates, la latence de recherche s'accumule rapidement. Interroger des API fiscales distantes tout en résolvant simultanément les enregistrements MLS contraint les applications clientes à subir de multiples négociations réseau séquentielles et des temps variables d'analyse de la charge utile. L'exécution d'une recherche parcellaire REAPI à l'échelle nationale selon ce modèle non coordonné entraînait des goulets d'étranglement de connexion et une surcharge des charges utiles. Sans une couche orchestrée de synchronisation recherche immobilière REAPI, le filtrage des annonces actives en parallèle des registres municipaux provoquait de fréquents blocages de l'interface utilisateur et des délais d'expiration d'API inacceptables.
Les enjeux : quel est l'impact d'un retard dans la découverte de biens immobiliers sur la conversion PropTech ?
Dans le secteur concurrentiel de l'intelligence immobilière, la latence de recherche nuit directement à la rétention des utilisateurs et à la conversion. Les investisseurs immobiliers, les courtiers et les acquéreurs institutionnels s'appuient sur une fidélité immédiate des données pour évaluer les cibles d'acquisition. Lorsque les actes de propriété et les déclarations de sûretés accusent un retard sur les mouvements du marché, les modèles algorithmiques produisent des évaluations de transactions erronées. Des calculs inexacts lors d'un flux d'évaluation immobilière hors marché REAPI dégradent la crédibilité de la plateforme, incitant les abonnés institutionnels à la délaisser au profit d'alternatives plus rapides.
Au-delà de l'insatisfaction des utilisateurs, les requêtes non coordonnées imposent une lourde surcharge à l'infrastructure. L'envoi de requêtes synchrones et non mises en cache vers des prestataires externes pour chaque filtre appliqué par l'utilisateur final épuise les quotas de requêtes de l'API et fait grimper les dépenses opérationnelles. Les systèmes dépourvus d'entrepôt de données localisé subissent une analyse redondante des payloads, ce qui accroît les coûts de calcul tout en rendant les fonctionnalités centrales de recherche vulnérables aux pannes de services tiers.
La solution : comment un pipeline d'ingestion unifie-t-il les données REAPI, RESO Web API et Zillow ?
Afin de résoudre les goulots d'étranglement liés aux requêtes distribuées, l'approche d'ingénierie a remplacé la fédération synchrone d'API par une architecture orientée événements. Au cœur de cette topologie, Canvas Developers a conçu un pipeline d'ingestion REAPI scalable qui découple la recherche front-end de la récupération des données en amont. Le moteur d'ingestion ingère et normalise les enregistrements au sein d'un cluster de recherche unifié, permettant aux applications clientes d'interroger des documents locaux pré-indexés en quelques millisecondes.
Le système établit une intégration REAPI sur mesure robuste en s'appuyant sur les points de terminaison décrits dans la documentation pour développeurs de RealEstateAPI. Des workers asynchrones en arrière-plan consomment les évaluations fiscales des parcelles, les enregistrements d'actes et les soldes hypothécaires via une ingestion en masse, stockant les attributs publics normalisés dans un magasin de documents persistant. Parallèlement, la plateforme assure une agrégation de données REAPI et MLS continue en synchronisant les annonces actives grâce à la spécification RESO EntityEvent et aux flux de syndication Zillow. Des séquences de modifications monotoniques suivent en temps réel les changements de statut des biens, les ajustements de prix et les calendriers de visites libres.
En harmonisant les registres parcellaires municipaux et les flux d'événements MLS en direct au sein d'un modèle de données unifié, cette architecture élimine les requêtes externes redondantes et garantit des recherches de biens systématiquement inférieures à la seconde.
Mise en œuvre : comment l'ingénierie IA supervisée par l'humain a-t-elle accéléré la livraison et la stabilité du système ?
Afin d'accélérer la mise en œuvre tout en maintenant une grande rigueur architecturale, Canvas Developers a structuré la livraison sur un calendrier réaliste de 8 à 12 semaines. Les missions types débutent par deux semaines de cadrage technique et de conception des schémas, suivies de quatre à six semaines de construction du pipeline, pour se conclure par deux à quatre semaines de tests de résistance (stress testing), de QA et de déploiement en production. Tout au long de ce planning, des agents de codage IA autonomes opérant dans des environnements d'exécution structurés ont généré le code répétitif (boilerplate) des objets de transfert de données (DTO), les adaptateurs de sérialisation et les suites de tests unitaires pour des centaines de variantes régionales de schémas MLS, accélérant ainsi le développement du pipeline d'ingestion REAPI scalable.
Cependant, la génération de code par l'IA possède des limites techniques bien définies. Les outils automatisés éprouvent des difficultés avec la logique des systèmes distribués, échouant fréquemment à gérer l'épuisement des pools de connexions, la régulation de débit par seau percé (leaky-bucket rate limiting) ou les pannes réseau partielles. Des ingénieurs seniors ont pris en charge l'architecture système, les contrôles de concurrence et la revue de code, veillant à ce que l'outillage automatisé n'introduise aucune régression silencieuse.
Lors du déploiement de l'intégration REAPI sur mesure, des ingénieurs expérimentés ont implémenté un algorithme de backoff exponentiel, des limiteurs de débit à seau de jetons sous Redis et des files de rebut (dead-letter queues) afin d'absorber la volatilité des charges utiles en amont, garantissant ainsi une ingestion stable à haut débit.
Les résultats : quels bénéfices une couche de données immobilières synchronisée a-t-elle apportés en production ?
Le déploiement d'une architecture de données immobilières synchronisée a transformé les performances de découverte de biens immobiliers face à des volumes de recherche élevés. Le passage de requêtes fragmentées exécutées à la volée sur plusieurs points de terminaison régionaux à des documents pré-agrégés a permis à la plateforme de traiter les requêtes localement. Lors des tests de référence (benchmarks), l'architecture unifiée a réduit la latence de recherche des données d'annonces de 68 %, assurant une réactivité constante inférieure à la seconde sur les requêtes complexes à filtres multiples.
Parallèlement à l'accélération des recherches, la plateforme a atteint une solide stabilité opérationnelle sur l'ensemble de ses flux hétérogènes. La synchronisation recherche immobilière REAPI continue a permis de rapprocher automatiquement l'inventaire MLS actif des actes de transfert municipaux, des évaluations parcellaires fiscales et des privilèges fiscaux légaux. Les utilisateurs exécutant un flux d'évaluation immobilière hors marché REAPI ont obtenu à la demande des analyses complètes de valeur nette, associant une couverture parcellaire à l'échelle nationale à une synchronisation en arrière-plan résiliente.
Points clés à retenir : comment les fondateurs de PropTech peuvent-ils mettre à l'échelle des pipelines de données complexes avec Canvas Developers ?
La conception de plateformes performantes de découverte de biens immobiliers exige de traiter les flux tiers comme des flux d'événements asynchrones plutôt que comme des dépendances synchrones. Lors du développement d'une intégration REAPI sur mesure aux côtés des flux MLS, les équipes doivent dissocier l'ingestion de la recherche front-end, imposer une normalisation des schémas et gérer les limites de débit via des files d'attente résilientes. Une agrégation de données REAPI et MLS fiable repose sur une mise en cache robuste et une gestion proactive de l'état.
Canvas Developers est une entreprise d'ingénierie logicielle disposant d'un bureau à Dhaka, au Bangladesh, spécialisée dans la création de plateformes SaaS, d'applications web et de pipelines de données complexes. Les clients doivent s'attendre à une feuille de route de livraison structurée de 8 à 12 semaines : cadrage technique, livrables d'étapes convenus, assurance qualité rigoureuse et transfert. Nos ingénieurs expérimentés supervisent des agents de codage IA tout en maîtrisant l'architecture système, en examinant chaque modification et en décidant des déploiements pour l'ensemble de nos offres Private / Local AI Engineering et Claude Code / OpenAI Codex Engineering.
Pour évaluer l'architecture de votre plateforme, envoyez une demande via notre formulaire de contact afin de planifier une évaluation technique cadrée.