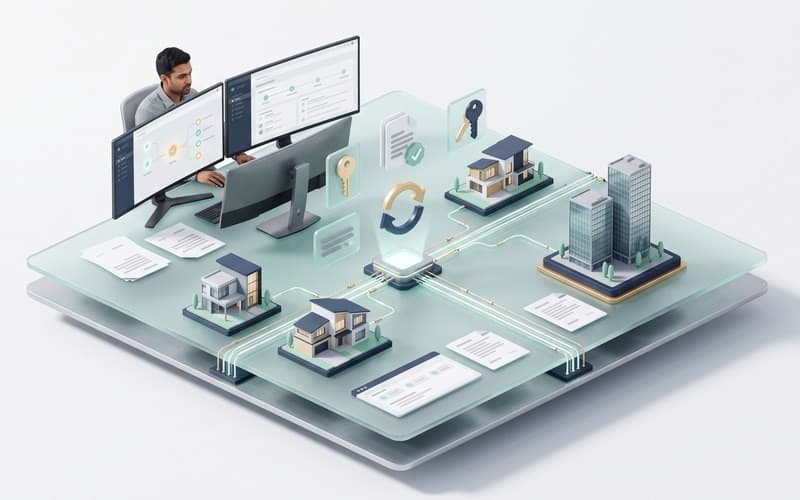
Detta illustrativa exempel är en konceptuell produktarkitektur utformad av Canvas Developers för att demonstrera hur ingenjörsteam inom storföretag kan strukturera en API-integrationsplattform för fastighetsdata med hög genomströmning. Det rör sig inte om ett levererat kunduppdrag. Fastighetsinvesteringsbolag, underwriting-avdelningar och värderingsplattformar kämpar rutinmässigt med fragmenterade kommunala lagfartsregister, taxeringsdatabaser och flöden av aktiva fastighetsannonser. Denna ritning modellerar en enhetlig mikrotjänstarkitektur för API-integration för fastighetsdata som aggregerar heterogena offentliga register och kommersiella flöden till ett frågelager med låg latens.
Projektet i korthet: Vad levererar denna proptech-integrationsmotor?
Utformat för proptech-bolag, institutionella kapitalförvaltare och plattformar för automatiserad fastighetsvärdering demonstrerar detta koncept en storskalig API-integrationsplattform för fastighetsdata byggd för att bearbeta stora volymer fastighetsposter. Det tekniska arbetet fokuserar på att förena disparata fastighetsdata – däribland offentliga taxeringsregister, lagfartsregister och aktiva fastighetsannonser – i en standardiserad data fabric.
Som en samlad proptech-annonsaggregator normaliserar plattformen heterogena uppströmskällor såsom slutpunkter från RealEstateAPI-dokumentationen, sekundära REAPI-flöden och annonser från kommersiella marknadsplatser till enhetliga scheman. Genom att frikoppla inläsning av tredjepartsscheman från användarvända frågegränssnitt säkerställer arkitekturen en robust leverans i efterföljande led till värderingsmotorer och sökmotorer för fastigheter.
Uppdraget: Hur harmoniserar man fragmenterade fastighetsregister i stor skala?
Att bygga en robust rikstäckande sökmotor för fastigheter kräver att man löser en akut datafragmentering. Över olika kommunala jurisdiktioner lagrar inskrivningsmyndigheter fastighetsgränser, lagfartsöverlåtelser och taxeringsuppgifter i motstridiga format, med inkonsekventa fältnamn och saknade geografiska attribut. Samtidigt uppdateras kommersiella annonsflöden kontinuerligt med aktuella utgångspriser och annonsstatusar.
Att integrera dessa disparata register i en pipeline för automatiserad fastighetsvärdering medför allvarliga begränsningar vad gäller genomströmning, spatial geokodning och latens. Inläsningspipelines måste normalisera tusentals varierande taxerings- och fastighetsdatapunkter över tiotals miljoner bostadsposter samt hantera oformaterade Assessor Parcel Numbers (APN) och koordinatprojektioner, utan att skapa flaskhalsar för efterföljande jämförande analyser.
Metod & process: Hur accelererar människostyrd AI-utveckling datapipelines?
För att effektivt bygga denna API-integrationsplattform för fastighetsdata tillämpar Canvas Developers människostyrda AI-arbetsflöden. AI-kodningsagenter och ett avancerat utvecklingsramverk accelererar genereringen av rutinmässiga anslutningar för datainläsning, standardkod för gränssnitt och mappningsfunktioner för schematransformation över kommunala datakataloger. Beroende på säkerhetskrav på företagsnivå driftsätter teamen dessa arbetsflöden genom privat/lokal AI-utveckling med isolerade modeller med öppna vikter eller kommersiella Claude Code- och OpenAI Codex-miljöer i enlighet med kundgodkända policyer.
Automatiserade verktyg kan dock inte ersätta domänexpertis vid komplex datainfrastruktur. Erfarna mjukvaruingenjörer styr varje fas i pipelinen och definierar mikrotjänsttopologi, robusta meddelandeköer och strikta schemakontrakt. Seniora ingenjörer granskar varje pull request, upprätthåller typsäkerhet och styr releasebeslut för att säkerställa att flöden för integration av fastighetsanalys bibehåller datakonsistens innan de når staging-miljöer.
Vad som byggdes: Hur möjliggör det enhetliga GraphQL-lagret värderingar på under 100 ms?
Den konceptuella arkitekturen kretsar kring ett enhetligt GraphQL-lager som gör förfrågningar mot normaliserade lagfarter, inteckningar och taxeringsvärden på fastighetsnivå. I stället för att hantera flera REST-slutpunkter mot lokala skatte- och lagfartsregister möjliggör denna API-integration för fastighetsdata att klientapplikationer gör förfrågningar mot ett federerat schema. Detta gränssnitt driver en interaktiv API-instrumentpanel för fastighetsvärdering med en synkroniserad tvådelad layout: en geospatial karta som återger fastighetsgränser jämte paneler för jämförande värdering sida vid sida, med historiska lagfartstidslinjer och detaljerade uppdelningar av taxeringslängder.
Under gränssnittet utför en pipeline för automatiserad fastighetsvärdering deterministisk deduplicering av poster och rumslig geokodning. Inläsningsprocesser sammanställer varierande County FIPS-koder, oformaterade APN-nummer (Assessor Parcel Numbers) och gränskoordinater till persistenta entitetsposter. För att stödja hög genomströmning över tiotals miljoner bostadsposter lagrar distribuerade Redis-cachekluster föraggregerade fastighetssammanfattningar, vilket levererar jämförande marknadsvärderingar på under 100 ms vid aktiva sökfrågor.
Tekniska realiteter: Var utmärker sig automatisering och vad kräver mänsklig tillsyn?
Medan AI-verktyg snabbt bygger upp grundstrukturen för parsers och anslutningar, innebär data engineering utmaningar som automatisering inte kan lösa på egen hand. Kommunala dataflöden drabbas ofta av schemaglidning, saknade fastighetsvärden och odokumenterade formatändringar. För verksamhetskritisk API-integration för fastighetsdata kan ohanterade avvikelser i uppströmsdata förvanska värderingsalgoritmer och riskbedömningskalkyler.
Senior mänsklig tillsyn är fortsatt avgörande för systemstabiliteten. Erfarna ingenjörer utformar robusta fallback-strategier, validerar databasindexering och granskar datasäkerheten över klientgränser. I varje företagsanpassad API-integrationsplattform för fastighetsdata säkerställer mänsklig kodgranskning att cachingtopologier och pipelines skalar tillförlitligt under hög belastning.
Nästa steg: Hur kan ni kravställa och bygga en skräddarsydd proptech-integrationsplattform?
Att omvandla detta koncept till en aktiv rikstäckande sökmotor för fastigheter följer en strukturerad, milstolpebaserad utvecklingsprocess. Uppdrag inleds med teknisk kravställning och fortsätter med utveckling av kopplingar, rigorös kvalitetssäkring och driftsättning i molnet.
Oavsett om det handlar om att bygga en MVP eller att driftsätta en API-integrationsplattform för fastighetsdata med hög genomströmning kombinerar Canvas Developers mänskligt ingenjörsledarskap med AI-assisterad acceleration. För att utvärdera era behov av dataaggregering, boka en avgränsad teknisk utvärdering via kontaktformuläret hos Canvas Developers eller kontakta oss via WhatsApp på webbplatsen.
Resultat
This illustrative example is a conceptual product architecture designed by Canvas Developers to demonstrate how enterprise engineering teams can structure a high-throughput real estate API integration platform. It is not delivered client work.