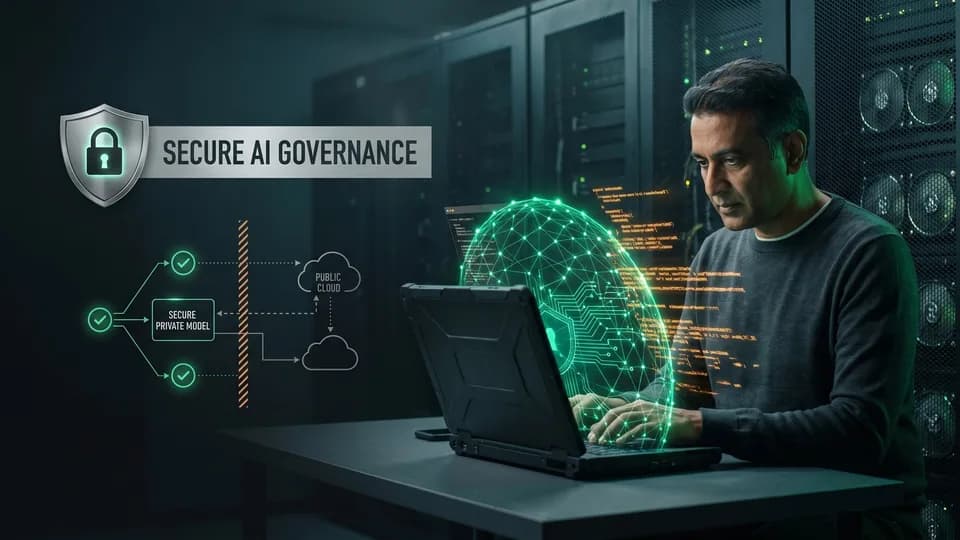
I moderni team di ingegneria si affidano sempre più agli agenti di programmazione automatizzati per accelerare il rilascio dei prodotti, ma l'adozione di modelli esterni senza controlli rigorosi comporta gravi responsabilità legali e di sicurezza. Definire una solida governance aziendale dell'AI per il codice (AI code governance) garantisce che il codice sorgente proprietario, la logica interna e i dati aziendali sensibili rimangano protetti dalla conservazione non autorizzata della telemetria e dall'esposizione della proprietà intellettuale.
Per i leader tecnologici, bilanciare la velocità degli sviluppatori con la conformità di livello enterprise richiede limiti operativi chiari, un'infrastruttura di modelli air-gapped (isolato dalla rete) o ospitati privatamente, e una rigorosa supervisione umana su ogni pull request automatizzata.
Quali rischi introduce l'assenza di AI code governance nel software enterprise?
Rischi di esfiltrazione di dati tramite cronologia dei prompt e telemetria commerciale
Quando gli sviluppatori software incollano frammenti di codice proprietario all'interno di assistenti cloud pubblici, trasmettono logica applicativa interna, schemi di database ed endpoint API attraverso reti esterne. I provider commerciali conservano di frequente la cronologia dei prompt, i buffer di contesto della sessione e la telemetria di sistema per scopi di debug o valutazione. In assenza di una formale governance aziendale dell'AI per il codice, le organizzazioni espongono inavvertitamente asset intellettuali critici e configurazioni operative sensibili a infrastrutture di terze parti.
Ambiguità sulla titolarità della proprietà intellettuale nel codice addestrato nel cloud
I modelli AI basati su cloud integrano spesso le interazioni degli sviluppatori in dataset di addestramento continuo, a meno che contratti aziendali espliciti per la gestione dei dati non lo impediscano. Questa pipeline rende poco chiara la provenienza del codice sorgente, innescando dispute legali relative alla contaminazione delle licenze e alle opere derivate. Mantenere una rigorosa protezione della proprietà intellettuale nello sviluppo AI richiede controlli verificabili che assicurino che la logica di business proprietaria non addestri mai modelli di fondazione esterni né trapeli nei prompt della concorrenza.
L'espansione della Shadow AI non verificata nei team di ingegneria
In assenza di una chiara policy aziendale sul software AI, i singoli ingegneri adottano frequentemente estensioni IDE non verificate e agenti di programmazione automatizzati per rispettare scadenze di sprint serrate. Questo utilizzo ombra non gestito aggira gli audit interni di sicurezza del codice AI, rende i repository vulnerabili all'estrazione non autorizzata della telemetria e inietta dipendenze esterne non documentate nelle applicazioni di produzione. Di conseguenza, le organizzazioni perdono visibilità su dove la logica generata dalle macchine penetri nella codebase.
In che modo gli strumenti AI su cloud pubblico differiscono dall'ingegneria AI privata?
Isolamento dei dati nei modelli open-weight self-hosted rispetto alle API pubbliche
Le API cloud commerciali elaborano le richieste relative al codice attraverso un'infrastruttura multi-tenant distribuita, in cui payload dei prompt, buffer di contesto e metadati di sistema lasciano la rete aziendale. Anche quando i fornitori enterprise offrono garanzie contrattuali di non conservazione dei dati (zero-retention), le informazioni transitano su livelli di routing pubblici e restano esposte alle vulnerabilità delle infrastrutture di terze parti. Al contrario, l'ingegneria AI privata (private AI engineering) garantisce un isolamento assoluto dei dati eseguendo modelli fondazionali open-weight come LLM locali enterprise esclusivamente all'interno dell'infrastruttura di proprietà e gestita dall'organizzazione. Algoritmi proprietari, logica di business e segreti di configurazione non escono mai dai perimetri approvati, garantendo la protezione della proprietà intellettuale per l'AI e impedendo l'ingestione esterna dei dati e l'addestramento non autorizzato dei modelli. Questo perimetro architetturale elimina l'esposizione verso la supply chain di terze parti a livello di inferenza.
Sicurezza del perimetro di rete ed elaborazione del codice air-gapped (isolato dalla rete)
Le imprese che operano in settori regolamentati come finanza, sanità e infrastrutture critiche devono applicare una rigorosa segmentazione della rete. L'implementazione di modelli AI self-hosted per il codice all'interno di subnet private o di ambienti interni completamente air-gapped (isolati dalla rete) elimina del tutto i vettori di esfiltrazione di dati verso l'esterno. I team di sicurezza possono stabilire rigidi controlli in ingresso, comunicazioni mutual TLS e runtime di container isolati che bloccano completamente il traffico in uscita verso Internet. Poiché l'hardware di inferenza risiede all'interno del perimetro aziendale, gli analisti della sicurezza monitorano tutto il traffico di rete attraverso i sistemi di rilevamento delle intrusioni esistenti e i log centralizzati dei firewall.
Bilanciare la velocità degli sviluppatori con il controllo dell'infrastruttura enterprise
Vietare ai team di ingegneria l'uso dell'assistenza automatizzata spesso degrada la produttività e favorisce involontariamente l'adozione incontrollata di shadow AI. Mettere a disposizione cluster di inferenza interni e controllati bilancia la velocità degli sviluppatori con una rigorosa governance AI enterprise. Gli ingegneri del software mantengono una rapida generazione del codice, l'accelerazione dello scaffolding e la sintesi dei test unitari direttamente all'interno dei flussi di lavoro di sviluppo approvati. Parallelamente, la leadership IT applica la policy aziendale per l'AI software, quote hardware e isolamento di rete, garantendo che l'accelerazione dello sviluppo rispetti i requisiti operativi di sicurezza del codice AI. Questo duplice approccio offre moderni strumenti di sviluppo senza sacrificare gli standard istituzionali e la governance aziendale dell'AI per il codice (AI code governance).
Come si presenta un'architettura di governance aziendale dell'AI per il codice?
Distribuzione di modelli open-weight all'interno di Virtual Private Cloud controllati dal cliente
Le architetture di sicurezza enterprise prevengono la fuga di dati isolando l'esecuzione dell'inferenza all'interno di un Virtual Private Cloud (VPC) dedicato o di un data center on-premise. In questo modello, foundation model open-weight ad alte prestazioni vengono eseguiti su istanze di calcolo GPU dedicate, predisposte, protette e gestite direttamente dai team di infrastruttura aziendali. Ospitando i modelli all'interno di perimetri di rete controllati dal cliente, le policy infrastrutturali limitano il traffico a endpoint privati interni. Questa configurazione garantisce che i repository di codice sorgente proprietario, i database di staging e gli schemi delle API interne non comunichino mai con cluster pubblici esterni tramite l'internet aperto. Questa infrastruttura isolata costituisce la base tecnica per la moderna governance aziendale dell'AI per il codice, garantendo alle organizzazioni la completa sovranità sulla persistenza della memoria, sulle interfacce di rete e sugli ambienti di esecuzione dei modelli.
Configurazione dei controlli di accesso basati sui ruoli e delle finestre di contesto effimere
Controllare il modo in cui il personale di ingegneria si interfaccia con i motori di inferenza interni richiede policy di accesso granulari e contesti di prompt rigorosamente regolamentati. I sistemi di Identity and Access Management (IAM) devono applicare autorizzazioni basate sui ruoli, limitando le query ai modelli ai soli ingegneri autorizzati in base all'ambito del progetto, alla classificazione dei repository e ai livelli di abilitazione sui branch. Inoltre, gli harness di inferenza devono implementare finestre di contesto effimere che elaborano i dati dei prompt esclusivamente nella memoria volatile, senza scrivere token intermedi su dischi di archiviazione persistente. Al termine di una sessione di ingegneria o alla conclusione di un'attività, i token di prompt e i suggerimenti di codice generati vengono eliminati completamente dai buffer di memoria. Questa disciplina architetturale previene fughe accidentali di dati tra progetti diversi e garantisce che la logica di dominio sensibile rimanga rigorosamente compartimentata all'interno dei confini di sviluppo autorizzati.
Automazione dell'audit logging e del monitoraggio della telemetria dei modelli
La supervisione operativa richiede una visibilità continua su ogni interazione di sviluppo assistita da sistemi automatici all'interno dell'organizzazione. Nell'implementare un'infrastruttura di LLM locali enterprise per il codice, i responsabili dell'ingegneria integrano raccoglitori automatici di telemetria che registrano metadati dei prompt, versioning dei modelli, timestamp di esecuzione e identità degli utenti. Invece di registrare codice sorgente grezzo contenente segreti industriali proprietari, le pipeline di audit tengono traccia di hash crittografici, metriche di consumo dei token e prestazioni di latenza nell'intero cluster di inferenza. Dashboard centralizzate di Security Information and Event Management (SIEM) analizzano questi flussi di telemetria confrontandoli con le baseline di conformità, segnalando all'istante pattern di query anomali, tentativi di accesso non autorizzati o attività di estrazione massiva. Audit trail completi forniscono prove di conformità verificabili per i framework di settore, preservando al contempo la produttività degli sviluppatori.
Perché i senior engineer devono guidare lo sviluppo assistito dall'AI?
Dove eccellono i modelli AI: accelerare scaffolding, logica ripetitiva e test di QA
I moderni agenti di programmazione automatizzati offrono significativi incrementi di produttività quando vengono impiegati per task di ingegneria del software meccanici e ben circoscritti. I modelli automatizzati eccellono nella generazione dello scaffolding iniziale di progetto (boilerplate), nella sintesi di interfacce CRUD standard, nella conversione dei formati di dati e nella redazione di suite complete di test unitari e di regressione. Gestendo i pattern di codice ripetitivi, gli assistenti automatizzati liberano i team di ingegneria dalla generazione di sintassi di routine e accelerano i cicli di sviluppo di base. Se integrate in workflow di sviluppo strutturati, queste funzionalità consentono alle organizzazioni di prototipare nuove feature ed estendere rapidamente la copertura dei test senza sacrificare la velocità di base.
Dove falliscono i modelli AI: coesione architetturale, flussi di pagamento e colli di bottiglia di scalabilità
Nonostante la rapidità nella generazione del codice, i modelli automatici mancano di una comprensione olistica dei sistemi enterprise complessi e della coesione architetturale a lungo termine. Gli strumenti automatizzati incontrano spesso difficoltà con la gestione complessa dello stato, la concorrenza transazionale, l'indicizzazione dei database e i colli di bottiglia di scalabilità ad alti volumi. In ambiti critici come l'elaborazione dei pagamenti, i flussi di autenticazione e le pipeline di dati sensibili, il codice generato dalle macchine introduce spesso vulnerabilità di sicurezza latenti, percorsi di eccezione non gestiti o configurazioni predefinite non sicure. Mantenere una rigorosa sicurezza codice AI enterprise richiede di riconoscere che i modelli statistici non possono valutare il rischio operativo, lasciando vulnerabili le transazioni finanziarie critiche e la resilienza del sistema se lasciati senza controllo.
Garantire il presidio umano su architettura, revisione approfondita del codice e rilasci
L'adozione efficace di strumenti di programmazione automatizzati richiede una solida AI code governance, in cui software engineer esperti sono chiamati a guidare, valutare e governare ogni output. Gli architetti umani devono mantenere la titolarità della progettazione fondamentale dei sistemi, definire i confini delle interfacce e determinare come i nuovi componenti interagiscono con i sistemi enterprise esistenti. Una disciplinata policy aziendale AI software per il CIO impone una scrupolosa revisione da parte di senior engineer su tutte le pull request assistite da macchine, verificando la sanificazione dei dati, i controlli di sicurezza e l'integrità architetturale. Le decisioni di rilascio devono rimanere tassativamente sotto il controllo umano, garantendo che i suggerimenti generati automaticamente non bypassino mai la verifica manuale prima di entrare negli ambienti di produzione.
Come si confrontano i modelli AI self-hosted con le soluzioni SaaS commerciali?
Conformità normativa e residenza dei dati nei diversi modelli di hosting
Le organizzazioni soggette a quadri normativi rigorosi, come GDPR, HIPAA o mandati regionali di sovranità dei dati, affrontano notevoli sfide di conformità quando utilizzano servizi AI commerciali multi-tenant. I provider cloud instradano frequentemente i payload di inferenza attraverso cluster di server distribuiti a livello globale, rendendo difficile verificare e confermare l'effettiva residenza dei dati. Utilizzando modelli AI self-hosted per il codice, le aziende ancorano l'elaborazione del codice e l'analisi dei repository a specifiche aree geografiche o a strutture on-premises private. I team infrastrutturali mantengono il controllo fisico e logico diretto sui volumi di archiviazione e sui nodi di elaborazione, soddisfacendo senza ambiguità i requisiti normativi di audit.
Integrità del codebase a lungo termine e protezione dalle modifiche alle API upstream
L'affidamento ad API AI commerciali esterne introduce volatilità operativa ogni volta che i provider upstream deprecano endpoint, modificano i pesi dei modelli o regolano i filtri di sicurezza interni senza preavviso. Queste modifiche non annunciate possono alterare il comportamento di sintesi del codice, compromettere gli harness di sviluppo personalizzati o degradare la coerenza dell'output nei diversi cicli di sviluppo. I deployment self-hosted isolano i team interni dalle modifiche impreviste dei vendor. Congelando le versioni dei modelli e validando gli aggiornamenti attraverso cicli di rilascio interni controllati, le organizzazioni preservano standard deterministici di generazione del codice e mantengono l'integrità del codebase nel lungo periodo.
Overhead di manutenzione dell'infrastruttura vs dipendenze da vendor esterni
Sebbene gli strumenti SaaS commerciali offrano un'immediata comodità chiavi in mano, scambiano la semplicità operativa con un lock-in sistemico del vendor e una persistente esposizione della telemetria. La gestione di modelli interni richiede l'allocazione di capitale per istanze di calcolo GPU, orchestrazione dei modelli e una supervisione specialistica della manutenzione. Tuttavia, questo investimento ingegneristico stabilisce una sovrana sicurezza codice AI enterprise, una difesa completa del perimetro di rete e una disponibilità continua durante i disservizi del cloud pubblico. Le aziende possono valutare questi compromessi operativi identificando quali codebase sensibili richiedano un isolamento infrastrutturale assoluto.
Quali policy pratiche di AI code governance dovrebbero applicare i CIO per i team supportati dall'AI?
Classificazione delle attività approvate rispetto a quelle soggette a restrizioni per i workflow con agenti AI
Un'efficace policy aziendale AI software per i CIO inizia con una classificazione trasparente delle attività lungo l'intero ciclo di vita dell'ingegneria del software. La leadership tecnologica dovrebbe indicare esplicitamente quali attività di sviluppo possono avvalersi di agenti di programmazione automatizzati e quali richiedono invece una stesura esclusivamente umana. Sebbene gli assistenti automatizzati siano ideali per generare codice boilerplate di routine, redigere test di integrazione e sintetizzare trasformazioni di schemi, dovrebbe essere loro vietato modificare in modo autonomo chiavi crittografiche, flussi di autenticazione, integrazioni con gateway di pagamento e la logica di business proprietaria. Limitare il coinvolgimento dei modelli nei moduli ad alto rischio previene configurazioni errate accidentali a tutela della sicurezza del codice AI, mantenendo al contempo la produttività degli sviluppatori nelle attività di sviluppo a basso rischio.
Gate obbligatori di sicurezza e analisi statica per le PR generate da macchine
Poiché gli agenti automatizzati possono generare allucinazioni su dipendenze di pacchetti inesistenti o introdurre sottili vulnerabilità, le pull request automatizzate richiedono gate di verifica obbligatori. Le pipeline CI/CD devono integrare test statici di sicurezza delle applicazioni (SAST), software composition analysis (SCA) e convalida automatica delle dipendenze per tutti gli invii di codice assistiti da macchine. L'attribuzione esplicita del modello tramite tag nelle pull request garantisce che i revisori esaminino la logica generata con il dovuto rigore. L'applicazione di questi gate automatizzati rafforza la protezione della proprietà intellettuale AI nello sviluppo, convalidando la provenienza del codice e impedendo a librerie esterne non verificate di entrare nei branch di produzione.
Formalizzare i criteri di approvazione dei fornitori per gli harness AI cloud e locali
L'acquisizione di harness per l'ingegneria AI privata richiede standard aziendali chiari che affrontino la privacy dei dati, la conservazione della proprietà intellettuale e i confini di rete. Le policy di approvvigionamento devono imporre contratti verificati a zero-retention e rigide clausole di non-addestramento prima che qualsiasi strumento di sviluppo basato su cloud venga approvato. Per i repository mission-critical, le linee guida aziendali dovrebbero stabilire soglie esplicite in cui i team devono passare dalle API commerciali a modelli AI self-hosted o a modelli di deployment isolati. Formalizzare questi criteri di valutazione protegge gli asset proprietari e garantisce una governance AI enterprise e una conformità coerenti in tutte le unità di ingegneria.
Come possono le aziende adottare in sicurezza l'ingegneria AI con governance oggi?
Condurre una valutazione mirata della governance per i flussi di lavoro interni
Per adottare lo sviluppo automatizzato in sicurezza, le organizzazioni dovrebbero iniziare con un audit ingegneristico strutturato. La valutazione dei permessi esistenti sui repository, dei flussi di lavoro degli sviluppatori e dei requisiti di conformità consente di identificare dove l'assistenza automatizzata accelera il rilascio e dove è invece necessario un rigoroso isolamento. Definire un framework operativo per la governance aziendale dell'AI per il codice garantisce che gli strumenti automatizzati siano allineati alle policy aziendali di protezione dei dati prima di un'adozione più ampia tra i team di prodotto.
Implementare un'infrastruttura isolata con Canvas Developers
Per le organizzazioni che ricercano velocità di sviluppo in piena sicurezza, Canvas Developers offre modelli di delivery dedicati per l'ingegneria AI privata che combinano l'accelerazione dell'AI con una rigorosa supervisione umana. Attraverso il proprio pacchetto Private / Local AI Engineering, Canvas Developers distribuisce modelli open-weight all'interno dell'infrastruttura controllata dal cliente, garantendo che il codice sorgente proprietario non lasci mai i perimetri privati. Software engineer esperti, specialisti QA e architetti DevOps guidano ogni flusso di lavoro automatizzato, presidiano l'architettura fondamentale del sistema e revisionano tutte le modifiche al codice prima del rilascio. Per valutare i vostri flussi di lavoro ingegneristici o predisporre un ambiente di deployment isolato, richiedete una valutazione mirata tramite il modulo di contatto su Canvas Developers Contact.