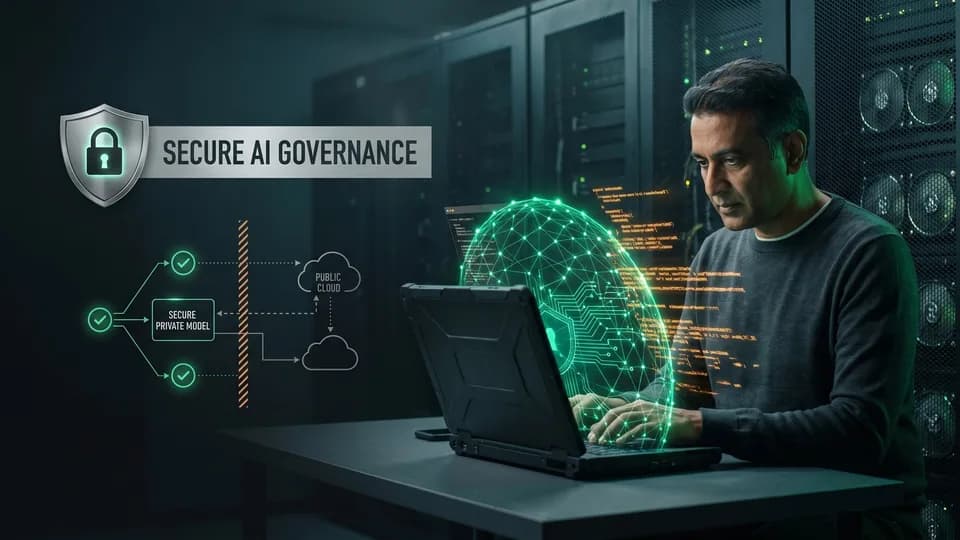
Les équipes d'ingénierie modernes s'appuient de plus en plus sur des agents de codage automatisés pour accélérer la livraison des produits, mais l'adoption de modèles externes sans contrôles stricts engendre de graves risques juridiques et compromet la sécurité du code IA. Mettre en place une solide gouvernance du code IA en entreprise garantit que le code source propriétaire, la logique interne et les données métier sensibles restent protégés contre la rétention non autorisée de la télémétrie et l'exposition de la propriété intellectuelle.
Pour les responsables technologiques, concilier la vélocité des développeurs et les exigences de conformité de l'entreprise nécessite des limites opérationnelles claires, une infrastructure de modèles isolée du réseau ou hébergée en privé, ainsi qu'une supervision humaine rigoureuse de chaque pull request automatisée.
Quels risques l'absence de gouvernance du code IA fait-elle peser sur les logiciels d'entreprise ?
Risques d'exfiltration de données via l'historique des prompts et la télémétrie commerciale
Lorsque les développeurs collent des extraits de code propriétaire dans des assistants cloud publics, ils transmettent la logique applicative interne, les schémas de bases de données et les points de terminaison d'API à travers des réseaux externes. Les fournisseurs commerciaux conservent fréquemment l'historique des prompts, les mémoires tampons de contexte de session et la télémétrie système à des fins de débogage ou d'évaluation. Sans une véritable gouvernance du code IA en entreprise, les organisations exposent par inadvertance des actifs intellectuels critiques et des configurations opérationnelles sensibles à des infrastructures tierces.
Ambiguïtés sur la propriété intellectuelle du code entraîné dans le cloud
Les modèles d'IA basés sur le cloud intègrent souvent les interactions des développeurs au sein de jeux de données d'entraînement continu, à moins que des contrats explicites de traitement des données d'entreprise ne s'y opposent. Ce pipeline brouille la traçabilité du code source, suscitant des litiges juridiques relatifs à la contamination de licences et aux œuvres dérivées. Maintenir une stricte protection PI en développement IA exige des contrôles vérifiables garantissant que la logique métier propriétaire n'entraîne jamais de modèles de fondation externes et ne fuite pas dans les prompts de concurrents.
L'expansion d'une Shadow AI non régulée au sein des équipes d'ingénierie
Sans garde-fous d'entreprise clairs ni politique IA DSI, les ingénieurs adoptent fréquemment des extensions d'EDI non vérifiées et des agents de codage automatisés pour respecter des délais de sprint serrés. Cet usage shadow non maîtrisé contourne les audits internes de sécurité du code IA, rend les dépôts vulnérables à l'extraction non autorisée de télémétrie et injecte des dépendances externes non documentées dans les applications en production. Par conséquent, les organisations perdent toute visibilité sur les points d'entrée de la logique générée par machine dans la base de code.
En quoi les outils d'IA du cloud public diffèrent-ils de l'ingénierie IA privée ?
Isolation des données au sein des modèles open-weight auto-hébergés face aux API publiques
Les API de cloud commercial traitent les requêtes de code sur une infrastructure mutualisée et distribuée où les charges utiles de prompts, les tampons de contexte et les métadonnées système quittent le réseau d'entreprise. Même lorsque les fournisseurs professionnels offrent des garanties contractuelles de non-rétention, les données traversent des couches de routage publiques et demeurent exposées aux vulnérabilités d'infrastructures tierces. À l'inverse, l'ingénierie IA privée garantit une isolation absolue des données en exécutant des modèles fondationnels open-weight exclusivement au sein d'infrastructures détenues et administrées par l'organisation. Les algorithmes propriétaires, la logique métier et les secrets de configuration ne quittent jamais les périmètres approuvés, empêchant l'ingestion externe de données et tout entraînement non autorisé de modèles. Cette frontière architecturale élimine l'exposition de la chaîne d'approvisionnement tierce au niveau de la couche d'inférence.
Sécurité du périmètre réseau et traitement du code en environnement isolé (air-gap)
Les entreprises opérant dans des secteurs réglementés tels que la finance, la santé et les infrastructures critiques doivent appliquer une segmentation réseau rigoureuse. Le déploiement de modèles d'IA auto-hébergés pour le code au sein de sous-réseaux privés ou d'environnements internes totalement isolés (air-gap) élimine entièrement les vecteurs de fuite de données sortantes. Les équipes de sécurité peuvent établir des contrôles d'accès entrants rigoureux, des communications en TLS mutuel (mTLS) et des environnements d'exécution de conteneurs isolés bloquant intégralement les sorties vers Internet. Le matériel dédié à l'inférence résidant au sein du périmètre de l'entreprise, les analystes de sécurité surveillent l'ensemble du trafic réseau via les systèmes de détection d'intrusion existants et les journaux de pare-feu centralisés.
Concilier vélocité des développeurs et contrôle de l'infrastructure d'entreprise
Interdire aux équipes d'ingénierie d'utiliser l'assistance automatisée dégrade souvent la productivité et favorise involontairement l'adoption d'un Shadow AI non maîtrisé. La mise à disposition de clusters d'inférence internes et contrôlés permet d'équilibrer la vélocité des développeurs et une rigoureuse gouvernance du code IA en entreprise. Les ingénieurs logiciels conservent une génération rapide de code, l'accélération du scaffolding et la synthèse de tests unitaires directement au sein de flux de développement approuvés. Parallèlement, la politique IA de la DSI encadre les règles d'accès d'entreprise, les quotas matériels et l'isolation réseau, garantissant que l'accélération de l'ingénierie s'aligne sur les exigences de sécurité opérationnelle et la sécurité du code IA. Cette double approche met à disposition des outils de développement modernes sans sacrifier les exigences de gouvernance du code IA de l'entreprise.
À quoi ressemble une architecture de gouvernance du code IA en entreprise ?
Déploiement de modèles open-weight au sein de clouds privés virtuels contrôlés par le client
Les architectures de sécurité d'entreprise préviennent les fuites de données en isolant l'exécution de l'inférence au sein d'un cloud privé virtuel (VPC) dédié ou d'un centre de données sur site. Dans ce modèle, des modèles fondateurs open-weight hautement performants s'exécutent sur des instances de calcul GPU dédiées, provisionnées, sécurisées et maintenues directement par les équipes d'infrastructure de l'entreprise. En hébergeant les modèles au sein de périmètres réseau contrôlés par le client, les politiques d'infrastructure restreignent le trafic à des points de terminaison privés internes. Cette configuration garantit que les dépôts de code source propriétaire, les bases de données de préproduction et les schémas d'API internes ne communiquent jamais avec des clusters publics externes sur l'Internet ouvert. Cette infrastructure isolée constitue le socle technique d'une gouvernance du code IA en entreprise moderne, accordant aux organisations une souveraineté totale sur la persistance en mémoire, les interfaces réseau et les environnements d'exécution des modèles.
Configuration des contrôles d'accès basés sur les rôles et fenêtres de contexte éphémères
Contrôler la manière dont les équipes d'ingénierie interagissent avec les moteurs d'inférence internes exige des politiques d'accès granulaires et des contextes de prompts strictement encadrés. Les systèmes de gestion des identités et des accès (IAM) doivent appliquer des autorisations basées sur les rôles, limitant les requêtes adressées aux modèles aux seuls ingénieurs habilités selon le périmètre du projet, la classification du dépôt et les niveaux d'autorisation sur les branches. De plus, les environnements d'inférence doivent mettre en œuvre des fenêtres de contexte éphémères qui traitent les données de prompt exclusivement en mémoire volatile, sans écrire de jetons intermédiaires sur des disques de stockage persistant. Lorsqu'une session d'ingénierie prend fin ou qu'une tâche s'achève, les jetons de prompt et les suggestions de code générées sont intégralement purgés des mémoires tampons. Cette rigueur architecturale empêche toute fuite involontaire de données entre projets et garantit que la logique métier sensible demeure strictement cloisonnée au sein des limites de développement autorisées.
Automatisation de la journalisation d'audit et surveillance de la télémétrie des modèles
La supervision opérationnelle exige une visibilité continue sur chaque interaction de développement assistée par machine au sein de l'organisation. Lors de la mise en œuvre d'une infrastructure de LLM local pour le code en entreprise, les responsables de l'ingénierie déploient des collecteurs automatisés de télémétrie qui enregistrent les métadonnées des prompts, la version des modèles, les horodatages d'exécution et l'identité des utilisateurs. Au lieu d'enregistrer du code source brut contenant des secrets industriels propriétaires, les pipelines d'audit consignent des empreintes cryptographiques, des métriques de consommation de jetons et les performances de latence sur l'ensemble du cluster d'inférence. Des tableaux de bord centralisés de gestion des événements et des informations de sécurité (SIEM) analysent ces flux de télémétrie par rapport aux référentiels de conformité, signalant instantanément les profils de requêtes anormaux, les tentatives d'accès non autorisées ou les activités d'extraction massive. Des pistes d'audit exhaustives fournissent des preuves de conformité vérifiables pour les cadres réglementaires sectoriels tout en préservant la vélocité des développeurs.
Pourquoi les ingénieurs seniors doivent-ils piloter le développement assisté par l'IA ?
Les atouts des modèles d'IA : accélération du scaffolding, logique répétitive et tests QA
Les agents de codage automatisés modernes offrent des gains de productivité significatifs lorsqu'ils sont affectés à des tâches de génie logiciel bien délimitées et mécaniques. Les modèles automatisés excellent dans la génération de scaffolding de projet boilerplate, la synthèse d'interfaces CRUD standard, la conversion de formats de données et la rédaction de suites complètes de tests unitaires et de régression. En prenant en charge les structures de code répétitives, les assistants automatisés libèrent les équipes d'ingénierie de la rédaction syntaxique de routine et accélèrent les cycles de développement de base. Lorsqu'elles sont intégrées à des flux de développement structurés, ces fonctionnalités permettent aux entreprises de prototyper rapidement des fonctionnalités et d'étendre la couverture des tests sans sacrifier la vélocité initiale.
Les limites des modèles d'IA : cohésion architecturale, flux de paiement et goulets d'étranglement de scalabilité
Malgré leur rapidité de génération de code, les modèles automatiques manquent d'une compréhension globale des systèmes d'entreprise complexes et de la cohésion architecturale à long terme. Les outils automatisés peinent fréquemment à gérer les subtilités de la gestion d'état, la concurrence transactionnelle, l'indexation des bases de données et les goulets d'étranglement de scalabilité à fort volume. Dans des domaines critiques tels que le traitement des paiements, les flux d'authentification et les pipelines de données sensibles, le code généré par machine introduit souvent des vulnérabilités de sécurité latentes, des chemins d'exception non gérés ou des configurations par défaut non sécurisées. Garantir une sécurité du code IA en entreprise rigoureuse impose de reconnaître que les modèles statistiques ne peuvent pas évaluer le risque opérationnel, exposant ainsi les transactions financières critiques et la résilience du système en l'absence de contrôle.
Garantir la responsabilité humaine sur l'architecture, la revue de code approfondie et les mises en production
Le déploiement efficace des outils de codage automatisés exige que des ingénieurs logiciels chevronnés encadrent, évaluent et assurent la gouvernance du code IA pour chaque résultat produit. Les architectes humains doivent conserver la responsabilité de la conception fondamentale des systèmes, définir les limites des interfaces et déterminer comment les nouveaux composants interagissent avec les systèmes d'entreprise existants. Une politique IA DSI rigoureuse impose que les développeurs seniors réalisent des revues de code approfondies sur toutes les pull requests assistées par machine, vérifiant l'assainissement des données, les contrôles de sécurité et l'intégrité architecturale. Les décisions de mise en production doivent demeurer strictement sous contrôle humain, garantissant que les suggestions générées par machine ne contournent jamais la validation manuelle avant d'atteindre les environnements de production.
Comment les modèles d'IA auto-hébergés se comparent-ils aux solutions SaaS commerciales ?
Conformité réglementaire et résidence des données selon les modèles d'hébergement
Les organisations régies par des cadres réglementaires stricts, tels que le RGPD, la loi HIPAA ou des exigences régionales de souveraineté des données, font face à des défis majeurs de conformité lorsqu'elles utilisent des services d'IA commerciaux mutualisés. Les fournisseurs de cloud acheminent fréquemment les charges utiles d'inférence à travers des clusters de serveurs répartis dans le monde entier, ce qui rend difficile la vérification formelle de la résidence des données. En recourant à des modèles d'IA auto-hébergés pour le code, les entreprises ancrent le traitement du code et l'analyse des dépôts dans des zones géographiques précises ou au sein d'infrastructures privées sur site. Les équipes d'infrastructure conservent un contrôle physique et logique direct sur les volumes de stockage et les nœuds de traitement, répondant sans ambiguïté aux exigences légales d'audit.
Intégrité à long terme de la base de code et protection contre les modifications d'API en amont
S'appuyer sur des API d'IA commerciales externes introduit une volatilité opérationnelle dès lors que les fournisseurs en amont déprécient des points de terminaison, modifient les poids des modèles ou ajustent leurs filtres de sécurité internes sans préavis. Ces ajustements inopinés peuvent altérer le comportement de synthèse de code, perturber les harnais d'ingénierie sur mesure ou dégrader la cohérence des résultats au fil des cycles de développement. Les déploiements auto-hébergés prémunissent les équipes internes contre les modifications imprévues des fournisseurs. En figeant les versions des modèles et en validant les mises à jour selon des cycles de livraison internes maîtrisés, les organisations préservent des standards déterministes de génération de code et maintiennent l'intégrité à long terme de leur base de code.
Charge de maintenance de l'infrastructure vs dépendances envers les fournisseurs externes
Si les outils SaaS commerciaux offrent une commodité clé en main immédiate, ils troquent cette simplicité opérationnelle contre une dépendance systémique envers le fournisseur et une exposition continue de la télémétrie. L'exploitation de modèles en interne nécessite d'allouer des ressources financières aux instances de calcul GPU, à l'orchestration des modèles et à une supervision spécialisée de la maintenance. Néanmoins, cet investissement d'ingénierie établit une sécurité du code IA en entreprise souveraine, une défense complète du périmètre réseau et une disponibilité continue en cas de panne du cloud public. Les entreprises peuvent évaluer ces arbitrages opérationnels en identifiant les bases de code sensibles qui exigent une isolation absolue de l'infrastructure.
Quelles politiques concrètes les DSI doivent-ils appliquer aux équipes assistées par l'IA ?
Classifier les tâches autorisées et restreintes pour les workflows d'agents IA
Une politique IA DSI opérationnelle pour la gouvernance du code IA commence par une classification transparente des tâches tout au long du cycle de vie de l'ingénierie logicielle. Les responsables technologiques doivent désigner explicitement les activités de développement pouvant s'appuyer sur des agents de codage automatisés et celles nécessitant une création exclusivement humaine. Si les assistants automatisés sont bien adaptés à la génération de code récurrent (boilerplate), à la rédaction de tests d'intégration et à la synthèse de transformations de schémas, il doit leur être interdit de modifier de manière autonome les clés cryptographiques, les flux d'authentification, les intégrations de passerelles de paiement et la logique métier propriétaire. Restreindre l'intervention des modèles dans les modules à haut risque prévient les erreurs de configuration accidentelles et renforce la sécurité du code IA, tout en maintenant la vélocité des développeurs sur les tâches à faible risque.
Imposer des points de contrôle de sécurité et d'analyse statique pour les PR générées par machine
Dans la mesure où les agents automatisés peuvent halluciner des dépendances de paquets inexistantes ou introduire des vulnérabilités subtiles, les pull requests automatisées exigent des points de contrôle obligatoires. Les pipelines CI/CD doivent intégrer des tests statiques de sécurité des applications (SAST), l'analyse de composition logicielle (SCA) et la validation automatisée des dépendances pour toutes les soumissions de code assistées par machine. L'attribution explicite du modèle sur les pull requests garantit que les relecteurs examinent la logique générée avec toute la rigueur nécessaire. L'application de ces contrôles automatisés renforce la protection PI développement IA en validant la provenance du code et en empêchant les bibliothèques externes non vérifiées d'intégrer les branches de production.
Formaliser les critères d'approbation des fournisseurs pour les environnements cloud et de LLM local pour le code
L'acquisition d'environnements d'ingénierie IA exige des normes claires de gouvernance IA en entreprise, encadrant la confidentialité des données, la rétention de la propriété intellectuelle et les périmètres réseau. Les politiques d'achat doivent imposer des contrats vérifiés de rétention zéro et des clauses strictes interdisant l'entraînement des modèles avant d'approuver tout outil de développement dans le cloud. Pour les référentiels stratégiques et critiques, les directives d'entreprise doivent définir des seuils précis imposant la transition des API commerciales vers des modèles d'IA auto-hébergés ou des environnements de déploiement isolés. Formaliser ces critères d'évaluation protège les actifs propriétaires et garantit une gouvernance du code IA rigoureuse et conforme au sein de l'ensemble des équipes d'ingénierie.
Comment les entreprises peuvent-elles adopter en toute sécurité une ingénierie IA encadrée aujourd'hui ?
Mener une évaluation ciblée de la gouvernance pour les workflows internes
Pour adopter le développement automatisé en toute sécurité, les organisations devraient commencer par un audit d'ingénierie structuré. L'évaluation des autorisations existantes sur les dépôts, des workflows de développement et des exigences de conformité permet d'identifier où l'assistance machine accélère les livraisons et où une isolation stricte est nécessaire. La mise en place d'un cadre opérationnel pour la gouvernance du code IA en entreprise garantit que les outils automatisés s'alignent sur les politiques internes de protection des données avant un déploiement plus large auprès des équipes produit.
Mettre en place une infrastructure isolée avec Canvas Developers
Pour les organisations en quête d'une vélocité d'ingénierie sécurisée, Canvas Developers propose des modèles de prestation dédiés à l'ingénierie IA privée qui associent l'accélération par l'IA à une supervision humaine rigoureuse. Grâce à son offre Private / Local AI Engineering, Canvas Developers déploie des modèles open-weight au sein d'une infrastructure contrôlée par le client, garantissant que le code source propriétaire ne quitte jamais les périmètres privés. Des ingénieurs logiciels expérimentés, des spécialistes QA et des architectes DevOps pilotent chaque workflow automatisé, maîtrisent l'architecture système fondamentale et vérifient toutes les modifications de code avant leur mise en production. Pour évaluer vos workflows d'ingénierie ou mettre en place un environnement de déploiement isolé, demandez une évaluation ciblée via le formulaire de contact sur Canvas Developers Contact.