تصميم المنتجات وUI/UX
اختبار المستخدمين
اكتشف أين يواجه المستخدمون الحقيقيون صعوبة في منتجك، ولماذا. نُجري اختبارات قابلية الاستخدام على النماذج الأولية والمنتجات العاملة، ثم نقدّم لك إصلاحات مرتبة حسب الأولوية ومدعومة بالأدلة.
من يطلب اختبار قابلية الاستخدام
يختلف فريقك حول سبب تعثّر المستخدمين عند خطوة ما، وكل رأي يبدو معقولًا. ويُظهر الاختبار ما يفعله أشخاص حقيقيون بالمنتج، فيستند القرار إلى ما رأيته يحدث فعلًا.
- فرق توشك على إطلاق إعادة تصميم لم يجرّبها سوى أشخاص من داخل الشركة
- مديرو منتجات يرون في التحليلات تسرّبًا في مسار التحويل، لكنهم لا يرون سببه
- قادة فرق الدعم الذين تصف تذاكرهم مرارًا الالتباس نفسه في أحد المسارات
شاهد أشخاصًا حقيقيين يستخدمون منتجك
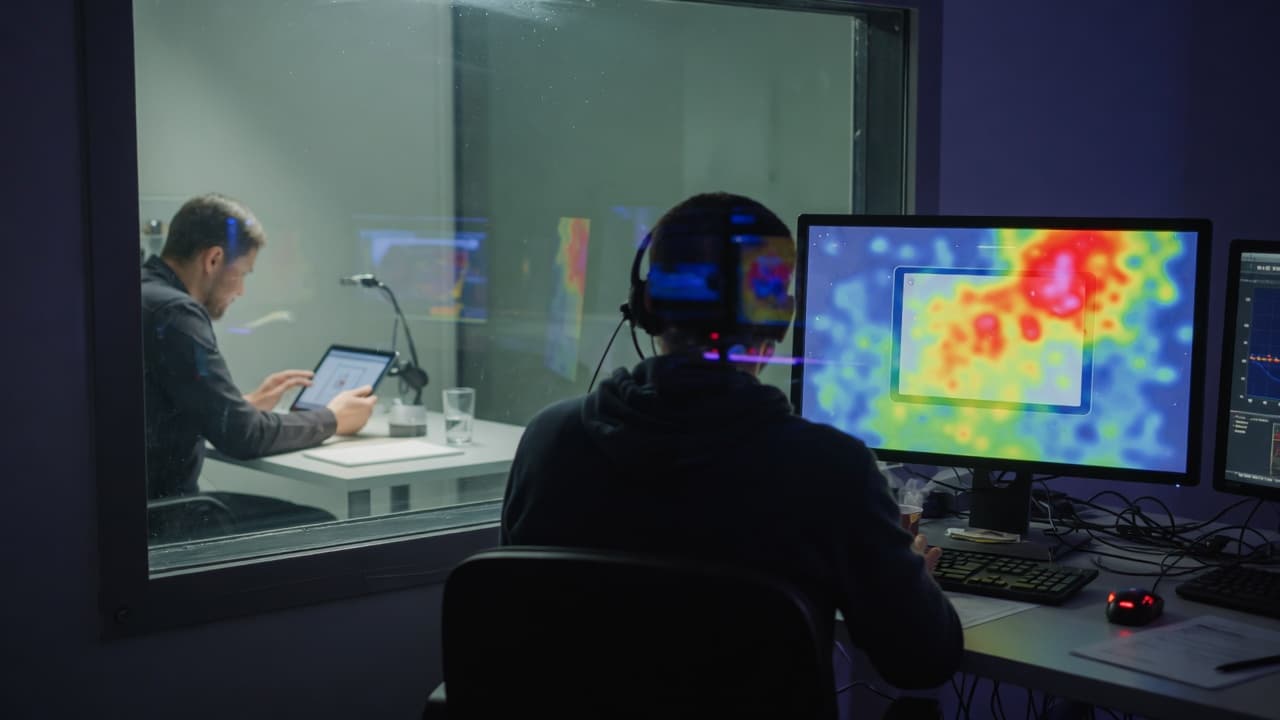
تعرف الفرق منتجاتها جيدًا لدرجة يصعب معها أن ترى أين يتعثر المستخدمون الجدد. واختبار قابلية الاستخدام يكشف ذلك مباشرة: أشخاص حقيقيون يحاولون إنجاز مهام حقيقية بينما يراقبهم باحث. نختبر النماذج الأولية ونسخ ما قبل الإنتاج والمنتجات العاملة مع مشاركين يطابقون مستخدميك، ونجمع ما نلاحظه مع بيانات التحليلات التي تسمح لنا باستخدامها، ثم نوضح في تقريرنا ما الخلل، ولماذا يهم، وكيف يُصلَح. ويمكن أن يكون الاختبار تعاقدًا مستقلًا، حتى للمنتجات التي بناها فريق آخر.
تحليل بمساعدة الذكاء الاصطناعي، واختبار بقيادة الباحثين
كيف يساعد الذكاء الاصطناعي
- يصوغ مسودات سيناريوهات الاختبار والمهام وأسئلة فرز المشاركين انطلاقًا من أهدافك، ليصقلها الباحثون.
- يفرّغ نصيًا تسجيلات الجلسات التي وافق عليها المشاركون، ويُعلِّم لحظات التردد والأخطاء والمهام المتروكة.
- يجمع الملاحظات من مختلف الجلسات في مشكلات، ترتبط كل منها بالمقاطع والاقتباسات التي تستند إليها.
- يلخّص بيانات الخرائط الحرارية ومسارات التحويل والتسجيلات التي تسمح لنا باستخدامها، ليبيّن أين ينبغي التدقيق أكثر.
ما يتولّاه خبراؤنا
- المشاركون أشخاص حقيقيون يطابقون مستخدميك، يستقطبهم الباحثون ويديرون جلساتهم، وليسوا أبدًا محاكاة بالذكاء الاصطناعي.
- يتحقق الباحثون من كل مشكلة أشار إليها الذكاء الاصطناعي بالرجوع إلى التسجيلات، ويفصلون السلوك المرصود عن الآراء.
- تأتي تقييمات الخطورة والتوصيات من باحثين راجعوا الأدلة، لا من نموذج ذكاء اصطناعي.
- يُجري البشر اختبارات إمكانية الوصول باستخدام قارئات الشاشة والتنقل بلوحة المفاتيح، ولا نكتفي بالفحص الآلي.
داخل جلسة اختبار قابلية استخدام بإشراف مباشر
جلسة معتادة بإشراف مباشر وتحليلها؛ ويُتفق على مهامك وسُلّم الخطورة في خطة الاختبار.
الشرح والموافقة
يشرح المشرف الجلسة ويطلب الموافقة على التسجيل؛ فالمنتج هو ما يُختبر، لا المشارك.
نقطة تحقق: لا يبدأ التسجيل إلا بعد الموافقة
التمهيد
أسئلة سهلة عن عمل المشارك وأدواته الحالية، ليُفهم سلوكه لاحقًا في سياقه.
مهام مع التفكير بصوت عالٍ
يحاول المشاركون إنجاز مهام واقعية ويقولون ما يتوقعونه؛ ويستوضح المشرف دون أن يلمّح أبدًا إلى الإجابات.
المراجعة الختامية
أسئلة مفتوحة عمّا بدا صعبًا أو مفاجئًا، وعن أي شيء توقعه المشارك ولم يجده.
تقييم الخطورة
عبر كل الجلسات، يؤكد الباحثون كل مشكلة بالرجوع إلى التسجيلات، ويقيّمون مدى إعاقتها للمهمة.
نقطة تحقق: لا تدخل النتائجَ إلا المشكلاتُ المؤكدة
النتائج
تُوثَّق كل مشكلة مؤكدة مع مقطعها المسجّل، والمهمة التي أعاقتها، وإصلاح مقترح.
عند حدوث خلل: إذا تعثّر أحد المشاركين، يدوّن المشرف موضع التعثر وينتقل إلى ما بعده؛ فالمهمة المتعثرة نتيجةٌ بحد ذاتها، لا جلسة فاشلة.
كيف تسير دراسة قابلية الاستخدام
- 01
التخطيط
نتفق على ما سنختبره، والمهام، ومعايير النجاح، ومن سنستقطب من المشاركين، إضافةً إلى الموافقة وطريقة تخزين التسجيلات ومعالجتها.
- 02
الاستقطاب والاختبار
يستقطب الباحثون مشاركين مطابقين، ويُجرون جلسات بإشراف مباشر أو دون إشراف على نموذجك الأولي أو نسخة ما قبل الإنتاج أو منتجك العامل.
- 03
التحليل
يساعد الذكاء الاصطناعي في تفريغ الجلسات نصيًا ووسمها، ويراجع الباحثون التسجيلات ويؤكدون كل مشكلة ويقيّمون خطورتها.
- 04
التوصية وإعادة الاختبار
جلسة لاستعراض النتائج مع المقاطع والإصلاحات الموصى بها، ثم اختبار متابعة بعد إجراء التغييرات، إن رغبت في ذلك.
طريقتان للعمل بأدوات الذكاء الاصطناعي
يساعد الذكاء الاصطناعي في توليف الأبحاث المسموح باستخدامها واستكشاف التصاميم. اختر أين يُسمح له بمعالجة أبحاثك وملفاتك.
- الهندسة بالذكاء الاصطناعي الخاص / المحلي
نماذج مستضافة بشكل خاص داخل بنية تحتية تتحكم بها أو في بيئة معزولة متفق عليها.
ناقش هذه الباقة معنا - الهندسة باستخدام Claude Code / OpenAI Codex
استخدام Claude Code و/أو OpenAI Codex بإعدادات سحابية تعتمدها مؤسستك.
ناقش هذه الباقة معنا
لست متأكدًا؟ سنوصي بإحداهما خلال تحديد النطاق. قارن خيارات التطوير بالذكاء الاصطناعي
ما تحصل عليه
مخرجات اختبار قابلية الاستخدام
خطة الاختبار
الأهداف والمهام ومعايير النجاح ومواصفات المشاركين، نتفق عليها معك قبل بدء استقطاب المشاركين.
جلسات بإشراف مباشر
جلسات مباشرة عن بُعد يرشد فيها باحثٌ المشاركين خلال المهام، ويطرح أسئلة متابعة ليفهم سبب تعثرهم.
اختبارات دون إشراف
يُنجز المشاركون المهام بمفردهم مع تسجيل الشاشة والصوت، للحصول على قراءات أسرع من عدد أكبر من الأشخاص.
مراجعة تحليلات السلوك
الخرائط الحرارية ومسارات التحويل وتسجيلات الجلسات التي تسمح لنا باستخدامها، لتبيّن أين يغادر المستخدمون أو يترددون أو يكررون الخطوات.
اختبار إمكانية الوصول
فحوصات لوحة المفاتيح وقارئات الشاشة والتباين والتركيز، مربوطة بمعايير النجاح في WCAG، مع خطوات إعادة إنتاج كل مشكلة.
تقرير النتائج
مشكلات مرتبة حسب الخطورة، مع مقاطع فيديو واقتباسات وإصلاحات موصى بها، إضافةً إلى تصورات لإعادة التصميم لأخطر المشكلات.
طلبات شائعة في اختبار قابلية الاستخدام
سيناريوهات نموذجية نحدد نطاقها، وليست دراسات حالة لعملاء.
خطوة في إتمام الشراء يتخلى عندها الناس
تُظهر التحليلات أن الزوار يغادرون عند خطوة التوصيل، ولدى الفريق نظريات متنافسة حول السبب. نُجري جلسات بإشراف مباشر على تلك الخطوة مع أشخاص يطابقون عملاءك، ونختبر كل نظرية مقابل ما يفعلونه فعلًا.
إعادة تصميم جاهزة في بيئة ما قبل الإنتاج
مسار جديد للتهيئة للاستخدام يعمل في بيئة ما قبل الإنتاج، لكن لم يستخدمه سوى الفريق. نعطي مستخدمين يجربونه لأول مرة المهامَّ نفسها على المسارين الحالي والجديد، ونقيّم خطورة كل مشكلة، ونشير إلى ما ينبغي إصلاحه قبل الإصدار.
فئات مستخدمين مختلفة، والتطبيق واحد
يستخدم الإداريون في المكتب والعاملون الميدانيون التطبيق نفسه بطرق مختلفة جدًا. نُجري جلسات بإشراف مباشر مع كل فئة لنفهم سبب تعثّر المهام، ثم جولة دون إشراف لنرى مدى انتشار المشكلات نفسها.
ما لا يشمله اختبار المستخدمين
- اكتشاف الاحتياجات والدوافع والمشكلات غير المحلولة من اختصاص خدمة أبحاث تجربة المستخدم؛ أما اختبار المستخدمين فيتحقق مما إذا كان الناس يستطيعون إنجاز المهام باستخدام تصميم أو منتج.
- نُبلغ عن الأخطاء الوظيفية التي تظهر في الجلسات، لكن الاختبار الوظيفي واختبار الانحدار المنهجيين من اختصاص خدمة ضمان جودة البرمجيات والاختبار.
- لا نضع مستخدمين يحاكيهم الذكاء الاصطناعي مكان المشاركين. وإذا صعُب استقطاب جمهور متخصص، نعدّل الخطة معك بدلًا من ذلك.
- تُربط نتائج إمكانية الوصول بمعايير WCAG لتوجيه الإصلاحات؛ لكنها ليست تدقيقًا كاملًا لمدى توافق منتجك مع المعايير.
كيف يغذّي الاختبار التصميم وضمان الجودة والإصدارات
إصلاحات تُصمَّم ثم يُعاد اختبارها
يستطيع مصممونا تحويل النتائج إلى مسارات ونماذج أولية معدّلة ثم اختبارها مجددًا، فتعرف أن الإصلاح ناجح قبل أن يُبنى.
مشكلات يستطيع المهندسون إعادة إنتاجها
تأتي كل مشكلة مع خطواتها وشاشاتها ومقاطعها، فيتمكن المطورون، من فريقنا أو فريقك، من معالجتها دون أخذ ورد طويل.
قابلية الاستخدام ضمن دورة ضمان الجودة
تتحول المهام الحرجة ونتائج إمكانية الوصول إلى فحوصات لضمان الجودة، فتُفحص المشكلات التي أصلحتها مجددًا قبل كل إصدار.
الاختبار مستمر بعد الإطلاق
تكشف جولات الاختبار على المنتج العامل، إلى جانب التحليلات وتذاكر الدعم، ما إذا كانت التغييرات قد نجحت وأين تظهر العوائق التالية.
أسئلة وأجوبة
الأسئلة الشائعة
كم عدد المشاركين الذين ينبغي أن نختبر معهم؟
يعتمد ذلك على ما تحتاج إلى معرفته. فلاكتشاف مشكلات قابلية الاستخدام، عادةً ما يكشف عدد قليل من المشاركين من كل فئة مستخدمين المشكلات المتكررة، وتكشف عدة جولات صغيرة أكثر مما تكشفه جولة واحدة كبيرة. أما لمقارنة النسخ بالأرقام، فتحتاج إلى عينات أكبر، غالبًا دون إشراف. ونوصي بحجم العينة في خطة الاختبار بناءً على سؤالك وجمهورك.
هل يمكنكم اختبار منتج بناه فريق آخر؟
نعم. يمكننا اختبار منتجك العامل، أو نسخة ما قبل الإنتاج، أو نموذج أولي، أو منتج أحد المنافسين للمقارنة. ويمكن التعاقد على الاختبار وحده، ولا يشمل التطوير أو الاستضافة. ويمكن أن يصمم فريقنا الإصلاحات أو أن تُسلَّم إلى مصمميك ومطوريك.
هل تُجرون اختبارات A/B؟
نعم، عندما تكون الزيارات كافية للوصول إلى نتيجة واضحة. نحدد الفرضية ومقياس النجاح، وينفّذ مطوروك أو مطورونا النسخ البديلة، ثم نحلل النتيجة معك. ومع الزيارات الأقل، عادةً ما يجيب الاختبار بإشراف مباشر عن السؤال بسرعة ووضوح أكبر.
كيف يُتعامل مع تسجيلات الجلسات والبيانات الشخصية عند استخدام أدوات الذكاء الاصطناعي؟
يوافق المشاركون قبل تسجيل أي شيء. ونتفق على التسجيلات وبيانات التحليلات التي يجوز لنا استخدامها، ونُخفي التفاصيل الشخصية أو نحذفها حيثما أمكن، ولا نستخدم إلا أدوات الذكاء الاصطناعي التي توافق عليها. وتتبع المعالجة إحدى باقتَي التطوير لدينا: الهندسة بالذكاء الاصطناعي الخاص / المحلي، على نماذج مستضافة بشكل خاص، أو الهندسة باستخدام Claude Code / OpenAI Codex، مع مزوّدين تجاريين وفق إعدادات متفق عليها للحسابات والاحتفاظ بالبيانات.
دراسات حالة ذات صلة
مشاريع ذات صلة

مقالات ذات صلة
خدمات ذات صلة

استشارات وحوكمة الـ Vibe Coding
حواجز حماية معمارية، وفرض للاختبارات المؤتمتة، وتدقيق للأكواد البرمجية المولدة بالذكاء الاصطناعي. اح...
اعرف المزيد
أبحاث تجربة المستخدم
اعرف ما يحتاجه مستخدموك قبل أن تصمّم أو تبني. نُجري مقابلات مع مستخدمين حقيقيين، ونراجع بيانات التحل...
اعرف المزيد
تصميم التفاعل
اجعل كل إجراء واضحًا: استجابة عندما ينقر المستخدمون، ومؤشر تقدّم أثناء انتظارهم، ومساعدة عندما يتعذر...
اعرف المزيد
Figma والتصميم المرئي
واجهات واضحة ومتسقة للويب والجوال، مصممة في Figma. نغطي كل شاشة رئيسية وكل حالة ونقطة توقف، في ملفات...
اعرف المزيد
اكتشف أين يتعثر المستخدمون
أخبرنا بما تريد معرفته وما هو جاهز للاختبار، وسنخطط لدراسة تُجرى وحدها أو بالتوازي مع التصميم والتطوير.