プロダクトデザインと UI/UX
ユーザーテスト
実際のユーザーが御社製品のどこで、そしてなぜ苦労するのかを確認しましょう。私たちはプロトタイプと稼働中の製品でユーザビリティテストを実施し、その後、証拠に裏付けられた優先順位付けされた修正を提供します。
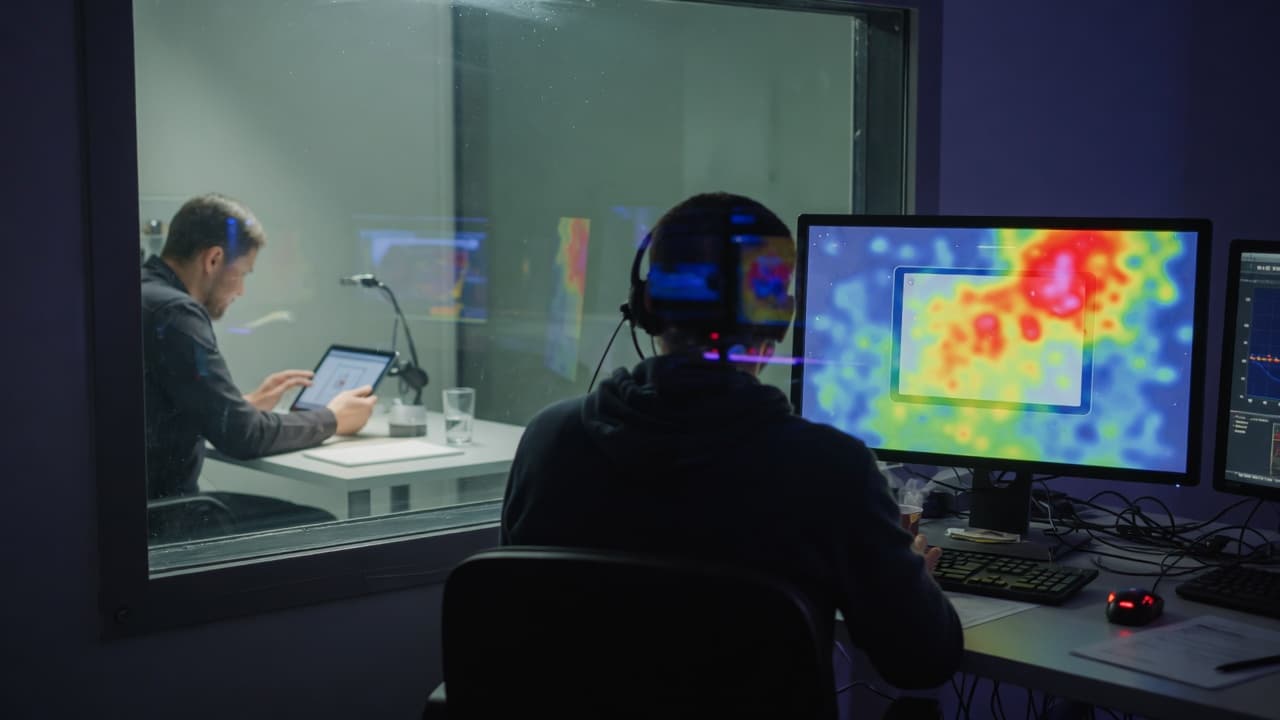
誰がユーザビリティテストを求めるか
あなたのチームは、なぜユーザーがあるステップで止まってしまうのかについて意見が分かれ、どの意見ももっともらしく聞こえます。テストは実際の人々が製品をどう使うかを示すので、決定はあなたが実際に目にしたことに基づきます。
- 内部関係者しか試していないリデザインをリリースしようとしているチーム
- アナリティクスでファネルの離脱は見えても、その原因が見えないプロダクトマネージャー
- チケットで同じフローにおける同じ混乱が繰り返し報告されているサポートリード
実際の人々が御社製品を使うのを観察する
チームは自社製品を知りすぎているため、新規ユーザーがどこで苦労するのかが見えません。ユーザビリティテストはそれを直接示します:実際の人々が実際のタスクに取り組み、その間リサーチャーが観察します。私たちは御社のユーザーに合致する参加者とともにプロトタイプ、ステージングビルド、稼働中の製品をテストし、観察したことと御社が使用を許可してくれた分析を組み合わせ、何が間違っているか、なぜそれが重要か、どう修正するかを報告します。テストは、別のチームが構築した製品を含めて、単独のエンゲージメントとすることもできます。
AI支援の分析、リサーチャー主導のテスト
AIがどのように支援するか
- 御社の目標からテストスクリプト、タスク、スクリーナー質問のドラフトを作成し、リサーチャーが洗練させます。
- 同意を得たセッション録画を書き起こし、ためらい、エラー、放棄されたタスクの瞬間にタグ付けします。
- 複数のセッションにわたる観察を課題にグループ化し、それぞれをその背後にあるクリップと引用にリンクします。
- 御社が使用を許可してくれたヒートマップ、ファネル、録画のデータを要約し、どこをより詳しく見るべきかを示します。
当社の専門家が担うこと
- 参加者は御社のユーザーに合致する実際の人々であり、リサーチャーによってリクルートされモデレートされます。決してAIシミュレーションではありません。
- リサーチャーはすべてのAIタグ付けされた課題を録画と照合し、観察された行動を意見と分けて保ちます。
- 深刻度の評価と推奨事項は、モデルからではなく、証拠をレビューしたリサーチャーから提供されます。
- スクリーンリーダーとキーボードナビゲーションによるアクセシビリティテストは、自動スキャンだけでなく、人によって行われます。
モデレーターありのユーザビリティセッションの内側
典型的なモデレーターありのセッションと分析です。あなたのタスクと深刻度スケールはテスト計画で合意されます。
ブリーフィングと同意
モデレーターがセッションを説明し、録画の同意を求めます。テストされるのは製品であり、参加者ではありません。
チェックポイント: 録画は同意後にのみ開始されます
ウォームアップ
仕事や現在使っているツールについての簡単な質問で、後の行動を文脈の中で読み取れるようにします。
考えを声に出すタスク
参加者は現実的なタスクに取り組み、何を期待するかを口に出します。モデレーターは探りを入れますが、決して答えのヒントは与えません。
デブリーフィング
何が難しかったか、驚いたかについての自由な質問、そして参加者が期待していたのに見つけられなかったことについての質問です。
深刻度の評価
すべてのセッションを通じて、リサーチャーは録画の中で各課題を確認し、それがどれほどタスクを妨げるかを評価します。
チェックポイント: 確認された課題のみが調査結果に反映されます
調査結果
確認された各課題は、そのクリップ、妨げられたタスク、提案された修正とともに文書化されます。
何かが失敗したとき: 参加者がつまずいた場合、モデレーターはどこでつまずいたかを記録して先に進みます。止まったタスクは調査結果であって、失敗したセッションではありません。
ユーザビリティ調査の進め方
- 01
計画
何をテストするか、タスク、成功基準、誰をリクルートするかに加え、同意、録画の保存・処理方法について合意します。
- 02
リクルートとテスト
リサーチャーが条件に合う参加者をリクルートし、あなたのプロトタイプ、ステージングビルド、またはライブ製品でモデレーターありまたはモデレーターなしのセッションを実施します。
- 03
分析
AIがセッションの文字起こしとタグ付けを支援します。リサーチャーが録画を確認し、各課題を検証し、その深刻度を評価します。
- 04
提案と再テスト
クリップと推奨される修正を交えた調査結果のウォークスルーを行い、ご希望があれば、変更後にフォローアップテストを実施します。
AIツールを使う2つの方法
AIは許可されたリサーチの統合とデザインの探索を支援します。リサーチとファイルを処理してよい場所を選択してください。
- Claude Code/OpenAI Codex エンジニアリング
お客様の組織が承認するクラウド設定での Claude Code および/または OpenAI Codex。
このパッケージについて相談する
お決まりでないですか?スコープ設定の際に一つをおすすめします。 AIデリバリーのオプションを比較する
お客様が受け取るもの
ユーザビリティテストの成果物
テスト計画
目的、タスク、成功基準、参加者プロファイル。リクルート開始前に御社と合意します。
モデレートありのセッション
リサーチャーが参加者をタスクに沿って導き、彼らがなぜ苦労するのかを理解するためにフォローアップの質問をする、ライブのリモートセッション。
モデレートなしのテスト
参加者が画面と音声を録画した状態で自分自身でタスクを完了し、より多くの人々にわたって素早く読み取ることができます。
行動分析のレビュー
御社が使用を許可してくれたヒートマップ、ファネル、セッション録画。ユーザーがどこで離脱し、ためらい、またはステップを繰り返すかを示します。
アクセシビリティテスト
WCAG成功基準にマッピングされたキーボード、スクリーンリーダー、コントラスト、フォーカスのチェック。各課題を再現する手順付き。
調査結果レポート
深刻度でランク付けされた課題。ビデオクリップ、引用、推奨される修正、さらに最も深刻な問題に対するリデザインのコンセプト付き。
典型的なユーザビリティテストの依頼
クライアントのケーススタディではなく、当社がスコープを定める典型的なシナリオです。
人々が離脱するチェックアウトのステップ
アナリティクスは訪問者がデリバリーのステップで離脱していることを示しており、チームにはその理由について相反する仮説があります。当社はそのステップで、あなたの顧客に合致する人々とモデレーターありのセッションを実施し、各仮説を彼らが実際に行うことと照らし合わせて確認します。
ステージングで準備が整ったリデザイン
新しいオンボーディングフローはステージング上で動作しますが、チームしか使っていません。当社は初めて使うユーザーに現行フローと新フローで同じタスクを行ってもらい、各問題を深刻度で評価し、リリース前に修正すべき点を指摘します。
異なるユーザーグループ、同じアプリ
オフィス管理者と現場スタッフは、同じアプリをまったく異なる使い方をします。当社は各グループとモデレーターありのセッションを実施してなぜタスクが止まるのかを学び、その後モデレーターなしのラウンドで同じ問題がどれほど広く現れるかを確認します。
ユーザーテストがカバーしないもの
- ニーズ、動機、未解決の問題を発見することはUXリサーチです。ユーザーテストは、人々がデザインや製品でタスクを完了できるかどうかを確認します。
- セッション中に見られた機能的なバグは報告されますが、体系的な機能テストおよびリグレッションテストはSoftware QA & Testingに属します。
- 当社は参加者をAIでシミュレートされたユーザーに置き換えることはしません。専門的な対象者のリクルートが難しい場合は、代わりにあなたと一緒に計画を変更します。
- アクセシビリティの調査結果は、修正の指針となるようWCAG基準にマッピングされますが、それは製品の完全な適合性監査ではありません。
テストがデザイン、QA、リリースにどう反映されるか
設計され再テストされた修正
私たちのデザイナーは調査結果を改訂されたフローとプロトタイプに変え、それらを再度テストできます。そのため、構築される前に修正が機能することが分かります。
エンジニアが再現できる課題
各問題には手順、画面、クリップが付いているため、私たちの、または御社の開発者が長いやり取りなしに対応できます。
QAサイクルにおけるユーザビリティ
重要なタスクとアクセシビリティの調査結果はQAチェックになり、御社が修正した問題が各リリース前に再度チェックされます。
ローンチ後もテストは続く
ライブ製品での複数回のテストに加え、アナリティクスとサポートチケットにより、変更が効果を上げたかどうか、そして次にどこで摩擦が生じるかが明らかになります。
FAQ
よくあるご質問
何人の参加者でテストすべきですか?
それは何を学ぶ必要があるかによります。ユーザビリティの問題を見つけるには、通常、ユーザーグループごとに数人の参加者で繰り返し発生する課題が明らかになり、1回の大規模なラウンドよりも複数の小規模なラウンドの方が多くを学べます。数値でバージョンを比較するには、より大きなサンプルが必要で、多くの場合モデレーターなしで行います。あなたの課題と対象者に基づいて、テスト計画で規模を推奨します。
別のチームが構築した製品をテストできますか?
はい。ライブ製品、ステージングビルド、プロトタイプ、または比較用の競合他社の製品をテストできます。テストは単独で依頼でき、開発やホスティングは含まれません。修正は当社のチームが設計することも、あなたのデザイナーや開発者に引き継ぐこともできます。
A/Bテストは実施しますか?
はい、明確な結果が得られるだけの十分なトラフィックがある場合に実施します。当社が仮説と成功指標を定義し、あなたの開発者または当社がバリアントを実装し、結果を一緒に分析します。トラフィックが少ない場合は、通常、モデレーターありのテストの方が質問に対してより速く、より明確に答えを出せます。
セッションの録画や個人データはAIツールでどのように扱われますか?
何かを録画する前に参加者が同意します。どの録画とアナリティクスを使用してよいか合意し、可能な限り個人情報をマスクまたは削除し、あなたが同意するAIツールのみを使用します。処理は当社の2つの開発パッケージのいずれかに従います。すなわち、プライベートにホストされたモデル上で行う プライベート/ローカルAIエンジニアリング、または合意済みのアカウントおよび保持設定のもとで商用プロバイダーを利用する Claude Code/OpenAI Codex エンジニアリング です。
関連サービス
UXリサーチ
デザインや構築の前に、ユーザーが何を必要としているかを知りましょう。実際のユーザーにインタビューし、御社が共有してくださる分析とサポートのデータを確認し、その証拠を明確な優先順位へと変えます。...
詳しく見る
インラクションデザイン
すべてのアクションを明確に:ユーザーがタップしたときのフィードバック、待機中の進捗表示、何かが失敗したときのヘルプ。ユーザビリティとアクセシビリティのために設計されたインタラクションとモーション。...
詳しく見る
Figma & ビジュアルデザイン
Figma でデザインされた、ウェブとモバイル向けの明快で一貫したインターフェース。すべての主要画面、状態、ブレークポイントを網羅し、開発者がそこからビルドできるファイルで提供します。...
詳しく見る
ユーザーがどこでつまずくかを突き止める
何を学びたいか、何がテストの準備ができているかをお聞かせください。単独で実施する調査、またはデザインや開発と並行して実施する調査を計画します。