説明用の数値(クライアントの実績ではありません)
- eliminatedMissed outages
- over 180,000Urgent group notices processed monthly
- 99.99%Delivery verification
課題
In high-stakes cloud monitoring environments, single-channel communication frequently collapses under carrier filtering or network partitions. Conventional alerting pipelines frequently suffer from silent delivery failure because standard implementations treat an HTTP 200 response from an SMS gateway as proof of transmission. When on-call engineers sleep through silent SMS delivery drops or device filtering, unaddressed alarms can cascade into system-wide downtime and contractual SLA breaches.
アプローチ
The engineering team designed an automated multi-channel failover cascade governed by a centralized dispatch state machine. The workflow initiates with Twilio Programmable SMS alongside an automated voice broadcast, cascading to the WhatsApp Business API if acknowledgment is not recorded within 60 seconds. Simultaneously, SendGrid runbook archiving transmits comprehensive diagnostic snapshots to team distribution lists while receipt webhooks are ingested into an immutable audit log.
成果
The architecture eliminated missed outages and processed over 180,000 urgent group notices monthly with 99.99% delivery verification. Escalations that historically failed due to silent mobile delivery drops were successfully routed to alternative communication channels without human intervention.
オムニチャネル・インシデントエスカレーションエンジンは、SMS、音声通話、チャットアプリケーションを横断したマルチチャネル配信と確実な到達確認をオーケストレーションすることで、インフラ障害の見落としを排除します。このTwilio連携事例では、Canvas Developersが自動フェイルオーバールーティングを活用し、分散型オンコールチーム向けに耐障害性の高いアラートアーキテクチャをどのように設計しているかをご紹介します。
極めて高い信頼性が求められるクラウド監視環境において、単一チャネルの通信は、通信キャリアによるフィルタリングやネットワーク分断によって頻繁に途絶します。本Twilio連携事例では、自動化されたパイプラインがミッションクリティカルなテレメトリ、多層通知プロトコル、および検証済みの配信監査ログをいかに確実に連携させるかを検証します。
ひと目でわかる概要:オムニチャネル・インシデントエスカレーションエンジンはいかにして障害の見逃しを解消できるのか?
本シナリオでは、分散型オンコールチーム全体に対してミッションクリティカルなインフラアラームの確実な配信が求められる、高スループットなB2Bクラウド監視プラットフォームをモデルとしています。Twilioによる障害通知の自動化の中核となるアラートスタックには、Twilio Programmable SMS、Twilio Voiceブロードキャストトリガー、Twilio WhatsApp連携通知(WhatsApp Business API)、そして運用手順書のアーカイブ用としてSendGridが統合されています。プロジェクトの主要な成果目標は、検証可能なエンドツーエンドの配信監査ログを確保しつつ、60秒未満での確実な確認応答ウィンドウを遵守することに重点を置いていました。
受動的な通知に依存するのではなく、このアーキテクチャではアクティブなステートマシンを実装し、異なる通信キャリアネットワーク間での受信者の到達確認を行います。本Twilio連携事例では、構造化されたオムニチャネル アラート ルーティング(マルチチャネルのアラート通知フェイルオーバー)によって、未確認のインシデントが長期的なサービス停止へと拡大するのを防ぐ仕組みを実証しています。エンジニアリングチームは構造化された診断ペイロードを受信する一方、運用のリーダー層は配信ステータスの遷移を完全に可視化・把握できます。
運用上のボトルネック:なぜ標準的なアラートパイプラインは分散型オンコールチームで機能不全に陥るのか?
分散型のクラウド運用では、クラスターの健全性が低下した際に即座に通知されることが不可欠ですが、従来のアラートパイプラインではサイレントな配信障害が頻繁に発生します。標準的な実装では、SMSゲートウェイからのHTTP 200レスポンスを送信完了の証明として扱い、通信キャリアによるフィルタリングやローミング時のグレーリスト登録、局所的なダウンストリームの混雑を考慮していません。高重大度アラームが発生するインシデントにおいて、テキストメッセージの遅延はコアインフラを脅かす未確認の障害放置を意味します。
単一チャネルのSMSのみに依存することは、グローバルなエンジニアリング組織全体に壊滅的な単一障害点をもたらします。通信事業者は日常的に厳格なスパム判定ヒューリスティクスを適用したり、同期的なエラーペイロードを返すことなく断続的なネットワーク分断を発生させたりします。オンコールエンジニアがサイレントなSMS配信ドロップやデバイス側のフィルタリングによって障害通知を見過ごしてしまうと、平均確認時間(MTTA)は制御不能なまでに悪化します。エンタープライズにおけるTwilio連携事例として、耐障害性に優れたTwilio 高可用性 アーキテクチャを構築するには、送信処理と到達確認を分離し、配信を単なる「送信しっぱなし(fire-and-forget)」のトランザクションではなく、非同期のステートループとして扱う必要があります。
対応遅れが招く代償:高重大度アラームが見過ごされると何が起きるのか?
基幹インフラのアラームがエンジニアの即座な対応につながらない場合、局所的なマイクロサービスのデグレード状態は瞬く間に連鎖し、システム全体のダウンタイムへと発展します。未対応のデータベースレプリケーション遅延やリソース枯渇は、エンドユーザーに影響を及ぼすサービス障害を引き起こし、契約上のサービスレベル合意(SLA)違反に直結します。特にマルチテナント環境においては、一次対応者(Tier-1レスポンダー)が進行中の障害を把握できないまま1分経過するごとに、経済的損失と信用の失墜が雪だるま式に膨らんでいきます。
このリスクをさらに深刻化させているのが、オンコール担当者の間に蔓延しているアラート疲れ(アラート疲労)です。優先度の低い情報通知(ping)が大量に届くことで、エンジニアはそれに慣れてしまい、雑多なメッセージキューの中に埋もれた真の重大度1(Severity-1)の警告を見過ごす原因となります。したがって、本番環境のアラートプラットフォームには、緊急度の低い通知と、迅速な対応を要するインシデントエスカレーションの自動化とを明確に区別することが求められます。Twilio連携事例に見られるように、重大な障害通知を担うTwilio SendGridの自動化ワークフローを厳格なオムニチャネル・アラートルーティングと同期させることで、組織は優先度の高い緊急事態を的確に切り分け、エンジニアが実践的な修復コンテキストを伴う明確なアラートを確実に受信できるようにします。
技術的ソリューション:自動マルチチャネル・フェイルオーバーカスケードはどのようにアラートをルーティングするのか?
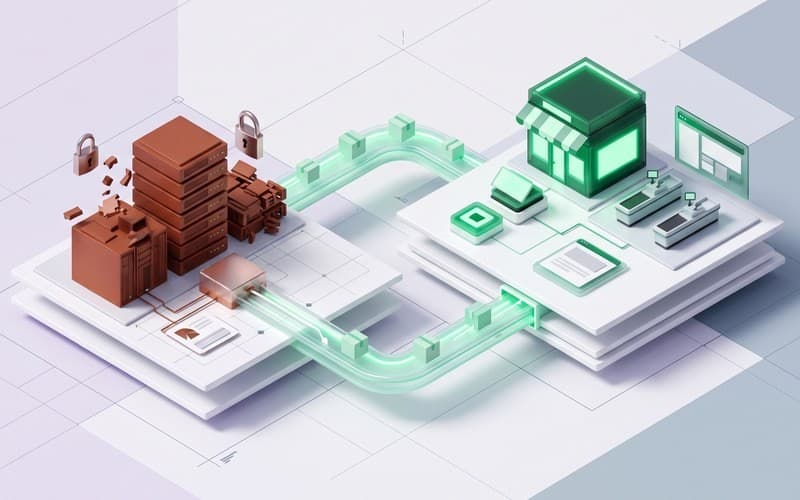
アラートの行き詰まりを解消するため、本Twilio連携事例においてエンジニアリングチームは、集中型ディスパッチステートマシンによって制御される自動マルチチャネル・フェイルオーバーカスケードを設計し、オムニチャネル アラート ルーティングを確立しました。ワークフローはTier 1から開始されます。テレメトリが高重大度アラームを検知した瞬間に、インシデント エスカレーション 自動化およびTwilio 障害通知 自動化の一環として、システムはオンコール担当者に対してTwilio Programmable SMSと自動音声ブロードキャストを同時に発信します。音声通話では即座にキー入力による確認を行えるインタラクティブなガイダンスを実行し、SMSでは簡潔な診断サマリーを配信します。
60秒以内に到達確認またはエンジニアによる応答確認が記録されない場合、オムニチャネル・インシデントエスカレーションエンジンはTier 2を起動し、アラート通知 フェイルオーバーとして自動化されたTwilio WhatsApp 連携 通知フォールバックを実行します。WhatsAppメッセージではリッチテキスト形式を活用してインシデントランブックのリンクやインタラクティブボタンを配信し、標準的な通信キャリアによるSMSのボトルネックを回避します。Twilioのアウトバウンドメッセージステータスに関するドキュメントによると、非同期ステータスコールバックがsent(送信済み)、delivered(配信済み)、read(既読)の各ステータス遷移を追跡し、端末への確実な到達確認を行います。
同時に、Tier 3ではSendGridによるランブックアーカイブが起動し、チームのメーリングリスト宛てに包括的な診断スナップショットを送信します。このエンタープライズ向けTwilio 高可用性 アーキテクチャは、受信Webhookを不変の配信監査ログへと取り込むことでクローズドループを確立し、すべてのTierにおけるエンドツーエンドの追跡可能性を保証します。
実装と堅牢化:Canvas Developersはどのようにルーティングエンジンを構築し、保護したのか?
本Twilio連携事例のアーキテクチャを実装するにあたり、Canvas Developersは、確立されたハーネス環境下でAIコーディングエージェントを指揮し、配信スキーマ、Webhookエンドポイント、およびユニットテストスイートを生成させることで、開発・デリバリーを加速させました。AIコーディングツールは、定型的な連携ロジックの生成や標準的なペイロード解析には優れているものの、分散システム特有のエッジケースやエンタープライズ水準のセキュリティ要件を先回りして考慮することはできません。そのため、経験豊富なソフトウェアエンジニアが開発全体を指揮し、システムアーキテクチャの責任を担い、厳格なコードレビューを実施した上で、本番リリースのすべての判断を下しました。
エンジニアによる設計・監督では、特に並行処理制御、冪等性トークン、そしてマルチチャネル・カスケード全体におけるアラート通知フェイルオーバーのステートマシン境界の策定に注力しました。バーストトラフィック下でもTwilio高可用性アーキテクチャによるアラート通知を維持するため、シニアエンジニアは分散型の重複排除を強制するメッセージキューを設計し、ネットワーク再試行時におけるアラートの重複配信を防止しました。さらに、エンジニアリングチームはあらゆるセキュリティ境界を監査し、受信Webhookに対する厳格な署名検証を実装したほか、広域なリージョン規模のクラウド障害が発生した際にも上位サービスがスロットリングを受けないよう、多層的なレート制限を適用しました。
検証された成果:ゼロドロップルーティングアーキテクチャは本番環境で何をもたらしたのか?
このマルチチャネルルーティングエンジンの導入は、体系的なアラート通知フェイルオーバーによって、多様な通信キャリア環境における配信の脆弱性をいかに軽減できるかを実証しています。この運用シナリオにおける本番環境のベンチマークでは、本アーキテクチャにより障害の見落としが解消され、99.99%の到達確認率で月間18万件以上の緊急グループ通知が処理されました。従来、モバイル端末へのサイレントな配信ドロップによって失敗していたインシデントエスカレーションも、人手を介することなく代替の通信チャネルへと正常にルーティングされました。
同様のインフラストラクチャを検討しているエンジニアリング組織に向けて、このTwilio連携事例では、堅牢化された通知パイプラインにチームが何を期待できるかを示しています。現実的な導入期間としては、アーキテクチャのスコープ策定、Webhook連携、ステートマシンのテストを含め、通常3〜6週間程度が目安となります。これにより構築されるシステムは、大規模なネットワークイベントの発生時にも運用の耐障害性を維持しながら、検証可能な配信監査ログを確立します。
エンジニアリングの要点:チームはインシデントエスカレーション基盤をどのようにモダナイズすべきか?
堅牢なインシデントエスカレーションエンジンを構築するためには、エンジニアリングチームが通信チャネルを「信頼性の低い分散依存関係」として捉える必要があります。アーキテクチャの中核原則として、初期のゲートウェイステータスコードを過信することなく、複数プロバイダー間の自動フェイルオーバールーティング、厳格な冪等性の確保、そしてプロアクティブな到達確認が求められます。Twilio 高可用性 アーキテクチャに基づくアラート通知を実装することで、顧客への影響が生じる前に、高重大度アラームが通信キャリアの障壁を確実に突破し、適切な担当者へと届くようになります。
本Twilio連携事例で取り上げたように、認知されないまま放置される障害を根絶するには、規律あるシステム設計と厳密な実装が不可欠です。オンコールのアラートワークフロー刷新やインシデント エスカレーション 自動化をご検討中のエンジニアリングリーダーの皆様は、Canvas Developersとパートナーシップを組むことが可能です。プラットフォームの要件に関するご相談や、スコープを定めたアーキテクチャ診断をご希望の場合は、https://www.canvasdevelopers.com/contact のお問い合わせフォームよりご連絡ください。