Cifras ilustrativas (no son resultados de clientes)
- eliminatedMissed outages
- over 180,000Urgent group notices processed monthly
- 99.99%Delivery verification
El problema
In high-stakes cloud monitoring environments, single-channel communication frequently collapses under carrier filtering or network partitions. Conventional alerting pipelines frequently suffer from silent delivery failure because standard implementations treat an HTTP 200 response from an SMS gateway as proof of transmission. When on-call engineers sleep through silent SMS delivery drops or device filtering, unaddressed alarms can cascade into system-wide downtime and contractual SLA breaches.
Enfoque
The engineering team designed an automated multi-channel failover cascade governed by a centralized dispatch state machine. The workflow initiates with Twilio Programmable SMS alongside an automated voice broadcast, cascading to the WhatsApp Business API if acknowledgment is not recorded within 60 seconds. Simultaneously, SendGrid runbook archiving transmits comprehensive diagnostic snapshots to team distribution lists while receipt webhooks are ingested into an immutable audit log.
Resultado
The architecture eliminated missed outages and processed over 180,000 urgent group notices monthly with 99.99% delivery verification. Escalations that historically failed due to silent mobile delivery drops were successfully routed to alternative communication channels without human intervention.
Un motor de escalamiento de incidentes omnicanal elimina las interrupciones de servicio no detectadas en la infraestructura al orquestar envíos multicanal a través de SMS, llamadas de voz y aplicaciones de chat con verificación determinista de recepción. Este caso de estudio de integración con Twilio demuestra cómo Canvas Developers diseña arquitecturas de alertas Twilio resilientes para equipos de ingeniería de guardia distribuidos mediante un enrutamiento con failover automatizado.
En entornos de monitoreo en la nube de alta exigencia, la comunicación por un solo canal suele colapsar debido al filtrado de operadoras o a particiones de red. Este caso de estudio de integración con Twilio analiza cómo una canalización automatizada conecta de manera confiable la telemetría de misión crítica, los protocolos de notificación multinivel y pistas de auditoría de entrega verificadas.
Resumen de un vistazo: ¿cómo puede un motor de escalamiento de incidentes omnicanal eliminar las interrupciones de servicio desatendidas?
Este escenario ilustrativo modela una plataforma de monitoreo en la nube B2B de alto rendimiento que requiere entrega garantizada para alarmas de infraestructura de misión crítica entre equipos de ingeniería de guardia distribuidos. El núcleo de la arquitectura de alertas Twilio integra Twilio Programmable SMS, disparadores de difusión de Twilio Voice, la WhatsApp Business API y SendGrid para el archivado de runbooks operativos. Los entregables clave del proyecto se centraron en aplicar una ventana determinista de confirmación inferior a 60 segundos, junto con pistas de auditoría de entrega verificables de extremo a extremo.
En lugar de depender de notificaciones pasivas, la arquitectura implementa una máquina de estados activa que valida la recepción del destinatario a través de distintas redes de operadoras. Este caso de estudio de integración Twilio demuestra cómo las cascadas multicanal estructuradas evitan que los incidentes no confirmados escalen a interrupciones de servicio prolongadas. Los equipos de ingeniería reciben cargas útiles de diagnóstico estructuradas, mientras que los responsables de operaciones mantienen una visibilidad total sobre las transiciones de envío.
El cuello de botella operativo: ¿por qué los flujos de alertas estándar les fallan a los equipos de ingeniería de guardia distribuidos?
Las operaciones distribuidas en la nube dependen de una notificación inmediata cuando el estado del clúster se degrada; sin embargo, los flujos convencionales de alertas sufren con frecuencia fallas silenciosas en la entrega. Las implementaciones estándar tratan una respuesta HTTP 200 de una pasarela de SMS como prueba de transmisión, ignorando el filtrado de operadoras, las listas grises en roaming y la congestión localizada downstream. En incidentes de alta gravedad, un mensaje de texto demorado representa una interrupción de servicio no reconocida que compromete la infraestructura central.
Depender exclusivamente de SMS monocanal introduce puntos únicos de falla catastróficos en los equipos globales de ingeniería. Los proveedores de telecomunicaciones aplican habitualmente heurísticas de spam agresivas o sufren particiones de red intermitentes sin devolver cargas útiles de error sincrónicas. Cuando los ingenieros de guardia siguen durmiendo ante pérdidas silenciosas en la entrega de SMS o el filtrado silencioso en los dispositivos, el tiempo medio de confirmación (MTTA) se dispara sin control. Construir una arquitectura de alertas Twilio empresarial y resiliente exige desacoplar la transmisión de la verificación de entrega, tratando la entrega como un bucle de estados asíncrono en lugar de una transacción fire-and-forget.
El costo del fallo: ¿qué sucede cuando no se reconocen las alarmas de alta gravedad?
Cuando las alarmas de infraestructura crítica no logran activar una respuesta inmediata por parte de los ingenieros, los estados degradados en microservicios aislados se propagan rápidamente en cascada hasta provocar un tiempo de inactividad generalizado en el sistema. El retraso no atendido en la replicación de bases de datos o el agotamiento de recursos provocan interrupciones de servicio de cara al cliente, lo que incumple directamente los acuerdos de nivel de servicio contractuales (SLA). En entornos multi-tenant, el impacto financiero y reputacional se agrava con cada minuto que los equipos de respuesta de nivel 1 desconocen una interrupción activa.
A este riesgo se suma la fatiga por alertas generalizada en los turnos de guardia. Los ingenieros, abrumados por avisos informativos de baja prioridad, desarrollan habituación, lo que permite que advertencias auténticas de gravedad 1 pasen desapercibidas en colas de mensajes saturadas. Por lo tanto, una plataforma de alertas en producción debe distinguir las notificaciones de baja urgencia de un escalamiento operativo accionable. Al sincronizar los flujos de trabajo de notificaciones críticas Twilio y SendGrid con un estricto enrutamiento omnicanal, las organizaciones aíslan las emergencias de alta prioridad, garantizando que los ingenieros reciban alertas inequívocas acompañadas de un contexto de remediación accionable.
La solución técnica: ¿cómo enruta las alertas una cascada automatizada de failover multicanal?
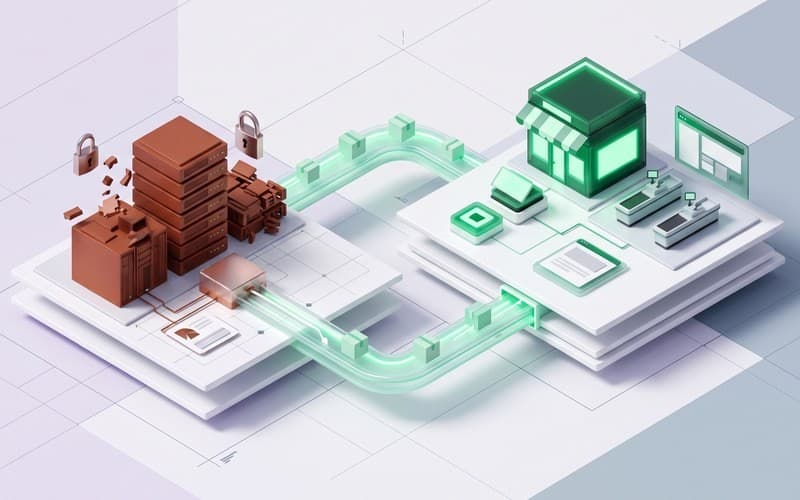
Para eliminar los puntos muertos en las alertas y garantizar un enrutamiento de alertas de alta disponibilidad, el equipo de ingeniería diseñó una cascada automatizada de enrutamiento con failover multicanal gobernada por una máquina de estados centralizada para el despacho. El flujo de trabajo se inicia en el Nivel 1: en el instante en que la telemetría detecta una alarma de alta gravedad, el sistema envía notificaciones críticas Twilio mediante Twilio Programmable SMS junto con una difusión de voz automatizada a los equipos de ingeniería de guardia. La llamada de voz ejecuta indicaciones interactivas para una confirmación inmediata por pulsación de teclas, mientras que el SMS ofrece resúmenes de diagnóstico concisos.
Si la confirmación de recepción o el reconocimiento del ingeniero no se registran en un plazo de 60 segundos, el motor de escalamiento de incidentes omnicanal activa el Nivel 2: una integración automatizada de failover SMS WhatsApp Twilio. Los mensajes de WhatsApp aprovechan el formato enriquecido para entregar enlaces a runbooks de incidentes y botones interactivos, evitando los cuellos de botella habituales del SMS de las operadoras. Según la documentación de Twilio sobre el estado de los mensajes salientes, los callbacks de estado asíncronos rastrean las transiciones entre los estados de enviado, entregado y leído para verificar la recepción real en el dispositivo.
De forma simultánea, el Nivel 3 activa el archivado de runbooks en SendGrid para transmitir instantáneas de diagnóstico completas a las listas de distribución del equipo. Esta arquitectura de alertas Twilio empresarial cierra el ciclo al incorporar los webhooks de recepción en un registro de auditoría inmutable, lo que garantiza pistas de auditoría de entrega y una trazabilidad de extremo a extremo en cada nivel.
Implementación y blindaje: ¿cómo construyó y aseguró Canvas Developers el motor de enrutamiento?
Al ejecutar esta arquitectura de alertas Twilio, Canvas Developers aceleró la entrega al dirigir agentes de codificación con IA dentro de un entorno de ejecución establecido para generar esquemas de envío, endpoints de webhooks y suites de pruebas unitarias. Si bien las herramientas de codificación con IA destacan en la generación de lógica de integración estándar y en el análisis básico de payloads, no pueden anticipar los casos extremos propios de los sistemas distribuidos ni los requisitos de seguridad empresarial. Ingenieros de software experimentados dirigieron todo el desarrollo, asumieron la responsabilidad de la arquitectura del sistema, realizaron revisiones de código rigurosas y tomaron todas las decisiones relativas al lanzamiento a producción.
La supervisión de ingeniería humana se centró específicamente en la concurrencia, los tokens de idempotencia y los límites de la máquina de estados para el enrutamiento con failover a lo largo de la cascada omnicanal. Para mantener un enrutamiento de alertas de alta disponibilidad con Twilio ante ráfagas de tráfico, los ingenieros sénior diseñaron una cola de mensajes que aplica la deduplicación distribuida, lo que evita el envío redundante de alertas durante los reintentos de red. Asimismo, el equipo de ingeniería auditó todos los perímetros de seguridad, implementando una estricta verificación de firmas para los webhooks entrantes y aplicando niveles de limitación de tasa (rate limiting) para proteger los servicios ascendentes frente al estrangulamiento durante incidentes regionales generalizados en la nube.
Resultados verificados: ¿qué aportó en producción la arquitectura de enrutamiento sin pérdida de alertas?
La implementación de este motor de enrutamiento multicanal demuestra cómo un failover estructurado mitiga la vulnerabilidad de entrega en entornos heterogéneos de operadoras. En las pruebas de rendimiento en producción para este escenario operativo, la arquitectura eliminó las interrupciones de servicio no detectadas y procesó más de 180.000 notificaciones críticas grupales al mes con una verificación de entrega del 99,99 %. Los escalamientos de incidentes que históricamente fallaban debido a pérdidas silenciosas en la entrega móvil se enrutaron con éxito hacia canales de comunicación alternativos sin intervención humana.
Para las organizaciones de ingeniería que evalúan una infraestructura similar, este caso de estudio de integración de Twilio detalla lo que los equipos pueden esperar de una canalización reforzada para notificaciones críticas. Los plazos de implementación realistas suelen oscilar entre tres y seis semanas para definir el alcance de la arquitectura de alertas, la integración de webhooks y las pruebas de la máquina de estados. El sistema resultante establece un registro de auditoría verificable mientras mantiene la resiliencia operativa durante eventos de red a gran escala.
Conclusiones de ingeniería: ¿cómo deberían los equipos modernizar su infraestructura de escalamiento de incidentes?
Construir un motor de escalamiento de incidentes resiliente exige que los equipos de ingeniería traten los canales de comunicación como dependencias distribuidas no confiables. Los principios arquitectónicos fundamentales exigen un failover multiproveedor automatizado, la aplicación estricta de la idempotencia y una verificación proactiva de la recepción, en lugar de confiar en los códigos de estado iniciales de las pasarelas. Implementar una arquitectura de alertas Twilio con enrutamiento de alertas de alta disponibilidad garantiza que las notificaciones críticas superen de manera confiable las barreras de las operadoras para llegar al responsable adecuado antes de que se produzca un impacto en los clientes.
Como se destaca en este caso de estudio de integración Twilio, eliminar las interrupciones de servicio no reconocidas requiere un diseño de sistemas disciplinado junto con una implementación rigurosa. Los líderes de ingeniería que buscan modernizar los flujos de trabajo de alertas para equipos de ingeniería de guardia pueden asociarse con Canvas Developers. Para conversar sobre los requisitos de su plataforma o solicitar una evaluación de arquitectura acotada, envíe una consulta a través del formulario de contacto en https://www.canvasdevelopers.com/contact.