Beispielzahlen (keine Kundenergebnisse)
- eliminatedMissed outages
- over 180,000Urgent group notices processed monthly
- 99.99%Delivery verification
Das Problem
In high-stakes cloud monitoring environments, single-channel communication frequently collapses under carrier filtering or network partitions. Conventional alerting pipelines frequently suffer from silent delivery failure because standard implementations treat an HTTP 200 response from an SMS gateway as proof of transmission. When on-call engineers sleep through silent SMS delivery drops or device filtering, unaddressed alarms can cascade into system-wide downtime and contractual SLA breaches.
Ansatz
The engineering team designed an automated multi-channel failover cascade governed by a centralized dispatch state machine. The workflow initiates with Twilio Programmable SMS alongside an automated voice broadcast, cascading to the WhatsApp Business API if acknowledgment is not recorded within 60 seconds. Simultaneously, SendGrid runbook archiving transmits comprehensive diagnostic snapshots to team distribution lists while receipt webhooks are ingested into an immutable audit log.
Ergebnis
The architecture eliminated missed outages and processed over 180,000 urgent group notices monthly with 99.99% delivery verification. Escalations that historically failed due to silent mobile delivery drops were successfully routed to alternative communication channels without human intervention.
Eine Omnichannel-Incident-Eskalations-Engine verhindert unbemerkte Infrastruktur-Systemausfälle, indem sie den Multi-Channel-Versand über SMS, Sprachanrufe und Chat-Anwendungen mit deterministischer Empfangsverifikation orchestriert. Diese Twilio Integration Case Study veranschaulicht, wie Canvas Developers mithilfe von automatisiertem Failover-Routing robuste Twilio Alerting Architekturen für verteilte On-Call-Engineering-Teams konzipiert.
In geschäftskritischen Cloud-Monitoring-Umgebungen scheitert einkanalige Kommunikation häufig an Netzbetreiber-Filterung oder Netzwerk-Partitionierungen. Diese Twilio Integration Case Study untersucht, wie eine automatisierte Pipeline geschäftskritische Telemetriedaten, mehrstufige Benachrichtigungsprotokolle und verifizierte Zustellungs-Audit-Trails zuverlässig miteinander verbindet.
Zusammenfassung auf einen Blick: Wie kann eine Omnichannel-Incident-Eskalations-Engine unbemerkte Systemausfälle verhindern?
Dieses anschauliche Szenario modelliert eine durchsatzstarke B2B-Cloud-Monitoring-Plattform, die eine garantierte Zustellung geschäftskritischer Infrastruktur-Alarme an verteilte On-Call-Engineering-Teams erfordert. Die zentrale Twilio Alerting Architektur integriert Twilio Programmable SMS, Twilio Voice Broadcast-Trigger, die WhatsApp Business API und SendGrid für die operative Runbook-Archivierung. Im Fokus der zentralen Projektergebnisse stand die Durchsetzung eines deterministischen Bestätigungsfensters von unter 60 Sekunden sowie verifizierbarer End-to-End-Zustellungs-Audit-Trails.
Statt sich auf passive Benachrichtigungen zu verlassen, implementiert die Architektur eine aktive State Machine, welche die Empfangsverifikation beim Empfänger über unterschiedliche Netzbetreiber hinweg sicherstellt. Diese Twilio Integration Case Study zeigt, wie strukturierte Multi-Channel-Kaskaden verhindern, dass unbestätigte Incidents zu längeren Serviceunterbrechungen eskalieren. Engineering-Teams erhalten strukturierte Diagnose-Payloads, während Operations-Verantwortliche die vollständige Transparenz über sämtliche Dispatch-Übergänge behalten.
Der operative Engpass: Warum Standard-Alerting-Pipelines bei verteilten On-Call-Teams versagen
Verteilte Cloud-Operations sind auf sofortige Benachrichtigungen angewiesen, sobald sich der Cluster-Zustand verschlechtert – dennoch leiden herkömmliche Alerting-Pipelines häufig unter lautlosen Zustellausfällen. Standardimplementierungen werten eine HTTP-200-Antwort eines SMS-Gateways als Übertragungsnachweis und ignorieren Netzbetreiber-Filterung, Roaming-Greylisting sowie lokale Überlastungen im Downstream. Bei Incidents mit hohem Schweregrad stellt eine verzögerte SMS einen unbestätigten Systemausfall dar, der die Kerninfrastruktur gefährdet.
Sich ausschließlich auf Single-Channel-SMS zu verlassen, führt zu fatalen Single Points of Failure für globale Engineering-Teams. Telekommunikationsanbieter wenden routinemäßig aggressive Spam-Heuristiken an oder sind von intermittierenden Routing-Partitionen betroffen, ohne synchrone Fehler-Payloads zurückzugeben. Wenn On-Call-Engineers unbemerkte SMS-Zustellausfälle oder lautlose Filterungen auf Endgeräten verschlafen, gerät die Mean Time to Acknowledge (MTTA) außer Kontrolle. Der Aufbau einer resilienten Enterprise Twilio Alerting Architektur erfordert es, die Übertragung von der Empfangsverifikation zu entkoppeln und die Zustellung als asynchrone Zustandsschleife statt als Fire-and-Forget-Transaktion zu behandeln.
Die Kosten des Scheiterns: Was passiert, wenn Alarme hoher Kritikalität unbestätigt bleiben?
Wenn Alarme der kritischen Infrastruktur keine sofortige Reaktion der Engineers auslösen, kaskadieren isolierte Leistungseinbußen einzelner Microservices rasch zu systemweiten Ausfallzeiten. Unbeachtete Datenbank-Replikationsverzögerungen oder Ressourcenengpässe führen zu kundenwirksamen Systemausfällen, die vertragliche Service Level Agreements (SLAs) unmittelbar verletzen. In Multi-Tenant-Umgebungen verstärken sich die finanziellen Folgen und Reputationsschäden mit jeder Minute, in der Tier-1-Responder eine aktive Störung nicht bemerken.
Verstärkt wird dieses Risiko durch eine allgegenwärtige Alert Fatigue in den On-Call-Teams. Engineers, die mit Informationsmeldungen niedriger Priorität überflutet werden, entwickeln einen Gewöhnungseffekt, wodurch echte Severity-1-Warnungen in überfüllten Message-Queues übersehen werden. Eine produktive Alerting-Plattform muss daher Benachrichtigungen geringer Dringlichkeit von handlungsrelevanten operativen Eskalationen unterscheiden. Durch die Synchronisierung von Workflows für die Twilio SendGrid Notfallbenachrichtigung mit striktem Multichannel-Routing isolieren Unternehmen Notfälle hoher Priorität und stellen sicher, dass Engineers eindeutige Alarme zusammen mit handlungsrelevantem Kontext zur Fehlerbehebung erhalten.
Die technische Lösung: Wie leitet eine automatisierte Multi-Channel-Failover-Kaskade Alarme weiter?
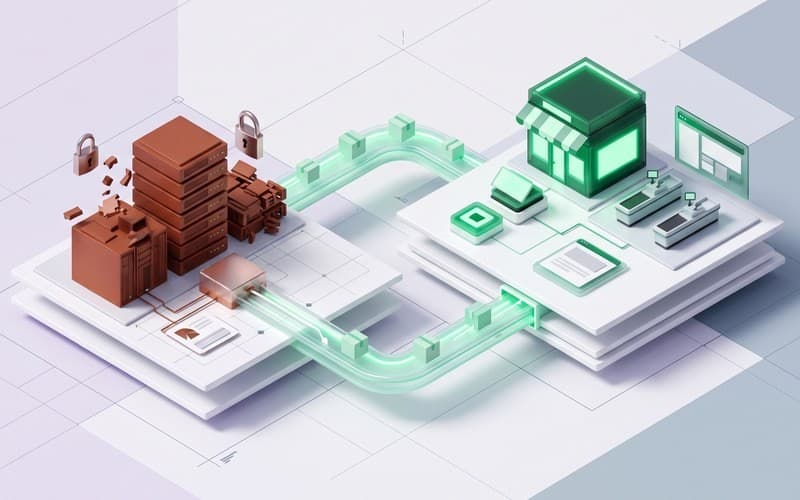
Um Alarmierungs-Sackgassen auszuschließen, konzipierte das Engineering-Team eine automatisierte Multi-Channel-Failover-Kaskade für das Incident Escalation Failover Routing, die über eine zentrale Dispatch-State-Machine gesteuert wird. Der Workflow startet bei Tier 1: Sobald die Telemetrie einen kritischen Alarm meldet, versendet das System eine Twilio Programmable SMS zusammen mit einem automatisierten Voice-Broadcast an das On-Call-Personal. Der Sprachanruf führt interaktive Prompts für eine sofortige Bestätigung per Tastendruck aus, während die SMS prägnante Diagnosezusammenfassungen liefert.
Bleibt eine Empfangsbestätigung oder die Rückmeldung eines Engineers innerhalb von 60 Sekunden aus, löst die Omnichannel-Incident-Eskalations-Engine Tier 2 aus: eine automatisierte Twilio WhatsApp Fallback Integration. WhatsApp-Nachrichten nutzen Rich Formatting, um Links zu Incident-Runbooks sowie interaktive Buttons bereitzustellen, und umgehen so typische Engpässe herkömmlicher Netzbetreiber-SMS. Gemäß Twilios Dokumentation zum Status ausgehender Nachrichten erfassen asynchrone Status-Callbacks die Übergänge zwischen den Statuswerten sent, delivered und read, um die tatsächliche Zustellung auf dem Endgerät zu verifizieren.
Gleichzeitig aktiviert Tier 3 die Twilio SendGrid Notfallbenachrichtigung zur Runbook-Archivierung, um umfassende Diagnose-Snapshots an Team-Verteilerlisten zu übermitteln. Diese Enterprise-Twilio-Alerting-Architektur schließt den Regelkreis, indem sie Empfangs-Webhooks in ein unveränderliches Audit-Log einspeist und so eine lückenlose End-to-End-Rückverfolgbarkeit über alle Tiers hinweg garantiert.
Implementierung & Härtung: Wie hat Canvas Developers die Routing-Engine aufgebaut und abgesichert?
Bei der Umsetzung dieser Architektur beschleunigte Canvas Developers die Bereitstellung, indem KI-Coding-Agenten innerhalb eines etablierten Harness gezielt gesteuert wurden, um Dispatch-Schemas, Webhook-Endpunkte und Unit-Test-Suites zu generieren. Während sich KI-Coding-Tools hervorragend für die Erstellung von Boilerplate-Integrationslogik und das standardmäßige Payload-Parsing eignen, können sie Edge Cases in verteilten Systemen oder Sicherheitsanforderungen auf Enterprise-Ebene nicht vorhersehen. Erfahrene Software-Engineers leiteten die gesamte Entwicklung, verantworteten die Systemarchitektur, führten strenge Code-Reviews durch und trafen sämtliche Entscheidungen zu Produktionsfreigaben.
Die menschliche Engineering-Aufsicht konzentrierte sich gezielt auf Nebenläufigkeit, Idempotenz-Tokens und die Grenzen der Failover-Zustandsautomaten über die Multichannel-Kaskade hinweg. Um die Hochverfügbarkeit beim Twilio-Alerting (High Availability Alerting Twilio) auch bei Lastspitzen aufrechtzuerhalten, entwarfen Senior Engineers eine Message Queue, die eine verteilte Deduplizierung erzwingt und so redundante Alert-Versendungen bei Netzwerk-Wiederholungsversuchen verhindert. Darüber hinaus auditierte das Engineering-Team alle Sicherheitsgrenzen, implementierte eine strikte Signaturverifikation für eingehende Webhooks und setzte abgestufte Rate-Limits durch, um Upstream-Dienste bei großflächigen regionalen Cloud-Vorfällen vor Throttling zu schützen.
Verifizierte Ergebnisse: Was leistete die Zero-Drop-Routing-Architektur im Produktivbetrieb?
Der Einsatz dieser Multi-Channel-Routing-Engine veranschaulicht, wie strukturiertes Failover-Routing Zustellungsrisiken in heterogenen Netzbetreiber-Umgebungen minimiert. In Produktions-Benchmarks für dieses Betriebsszenario verhinderte die Architektur unbemerkte Systemausfälle und verarbeitete monatlich über 180.000 dringende Gruppenbenachrichtigungen mit einer Empfangsverifikation von 99,99 %. Eskalationen, die in der Vergangenheit an unbemerkten mobilen Zustellungsabbrüchen scheiterten, wurden ohne menschliches Eingreifen erfolgreich an alternative Kommunikationskanäle weitergeleitet.
Für Engineering-Organisationen, die eine vergleichbare Infrastruktur evaluieren, skizziert diese Twilio Integration Case Study, was Teams von einer gehärteten Benachrichtigungs-Pipeline erwarten können. Realistische Implementierungszeiträume liegen üblicherweise zwischen drei und sechs Wochen für Architektur-Scoping, Webhook-Integration und State-Machine-Tests. Das resultierende System etabliert ein verifizierbares Audit-Logging und gewährleistet gleichzeitig operative Resilienz bei großflächigen Netzwerkereignissen.
Engineering-Erkenntnisse: Wie sollten Teams ihre Incident-Eskalationsinfrastruktur modernisieren?
Der Aufbau einer resilienten Incident-Eskalations-Engine erfordert von Engineering-Teams, Kommunikationskanäle als unzuverlässige verteilte Abhängigkeiten zu betrachten. Zentrale Architekturprinzipien verlangen ein automatisiertes Multi-Provider-Failover-Routing, die strikte Durchsetzung von Idempotenz und eine proaktive Empfangsverifikation, anstatt sich auf anfängliche Statuscodes der Gateways zu verlassen. Die Implementierung von High Availability Alerting mit Twilio stellt sicher, dass kritische Alarme Netzbetreiber-Barrieren zuverlässig durchdringen und die richtigen Responder erreichen, bevor es zu Auswirkungen auf Kunden kommt.
Wie in dieser Twilio Integration Case Study hervorgehoben wird, erfordert die Beseitigung unbestätigter Systemausfälle ein diszipliniertes Systemdesign gepaart mit einer konsequenten Implementierung. Engineering-Führungskräfte, die ihre On-Call-Alerting-Workflows modernisieren möchten, können mit Canvas Developers zusammenarbeiten. Um Ihre Plattformanforderungen zu besprechen oder ein gezieltes Architektur-Assessment anzufordern, senden Sie eine Anfrage über das Kontaktformular unter https://www.canvasdevelopers.com/contact.