示例数据(并非客户成果)
- eliminatedMissed outages
- over 180,000Urgent group notices processed monthly
- 99.99%Delivery verification
问题
In high-stakes cloud monitoring environments, single-channel communication frequently collapses under carrier filtering or network partitions. Conventional alerting pipelines frequently suffer from silent delivery failure because standard implementations treat an HTTP 200 response from an SMS gateway as proof of transmission. When on-call engineers sleep through silent SMS delivery drops or device filtering, unaddressed alarms can cascade into system-wide downtime and contractual SLA breaches.
方法
The engineering team designed an automated multi-channel failover cascade governed by a centralized dispatch state machine. The workflow initiates with Twilio Programmable SMS alongside an automated voice broadcast, cascading to the WhatsApp Business API if acknowledgment is not recorded within 60 seconds. Simultaneously, SendGrid runbook archiving transmits comprehensive diagnostic snapshots to team distribution lists while receipt webhooks are ingested into an immutable audit log.
成果
The architecture eliminated missed outages and processed over 180,000 urgent group notices monthly with 99.99% delivery verification. Escalations that historically failed due to silent mobile delivery drops were successfully routed to alternative communication channels without human intervention.
多渠道故障升级引擎通过在短信、语音通话与即时通讯应用之间统筹多渠道分发,并结合确定性送达回执验证,彻底杜绝基础设施故障停机的遗漏。本 Twilio 集成案例展示了 Canvas Developers 如何利用自动化故障转移路由,为分布式值班工程团队设计高弹性的告警架构。
在严苛的高风险云监控环境中,单渠道通信常常因运营商过滤拦截或网络分区而失效。本 Twilio 集成案例深入剖析了自动化流水线如何可靠连接关键任务遥测数据、多层级通知协议与经过验证的送达审计追踪。
核心速览:多渠道故障升级引擎如何消除宕机漏报?
本场景模拟了一个高吞吐量 B2B 云监控平台的高可用 Twilio 告警系统,该系统要求面向分布式值班工程团队,确保关键基础设施告警的可靠送达。该多渠道告警通知引擎的核心技术栈集成了 Twilio Programmable SMS、Twilio Voice 广播触发器、Twilio WhatsApp 备用通道集成(基于 WhatsApp Business API),以及用于运维操作手册归档的 Twilio 关键通知与 SendGrid。项目的关键交付成果专注于执行严格的 60 秒内确定性确认窗口,并提供可验证的端到端送达审计追踪。
这一企业级 Twilio 告警架构并没有依赖被动通知,而是实现了一个主动状态机,能够跨不同的运营商网络验证接收者的送达回执。本 Twilio 集成案例展示了结构化的多渠道故障转移级联与故障升级转移路由,如何防止未确认事件恶化为长时间的服务中断。工程团队能够接收结构化的诊断载荷,而运维负责人则对整个调度分派过程保持完全的可视性。
运维瓶颈:为什么标准告警流水线无法保障分布式值班工程团队?
分布式云运维高度依赖集群健康状况恶化时的即时通知,然而常规告警流水线却频频遭遇静默送达失败。标准实现方式通常将短信网关返回的 HTTP 200 响应直接视作发送成功的凭据,忽视了运营商过滤拦截、漫游灰名单机制以及局部的下游网络拥堵。在严重级别极高的故障事件中,一条被延迟的短信就意味着一场未被确认的系统中断,直接危及核心基础设施。
单纯依赖单一短信渠道,会为全球分布的工程团队引入灾难性的单点故障。电信运营商通常会执行严苛的垃圾信息过滤策略,或遭遇间歇性路由分区,且不会返回同步的错误响应载荷。当值班工程师因短信静默丢包或设备端静默拦截而在睡梦中错失告警时,平均确认时间(MTTA)便会彻底失控。构建具备高弹性的企业级 Twilio 告警架构,需要将发送与送达验证彻底解耦,将送达过程视作一个异步状态循环,而非“即发即弃”式的一次性事务。
故障的代价:高严重级别告警未被确认时会发生什么?
当关键基础设施告警未能触发工程师的即时响应时,局部微服务的降级状态会迅速级联演变为全系统停机故障。未得到及时处理的数据库复制延迟或资源耗尽会引发面向客户的业务中断,直接违反合同约定的服务等级协议(SLA)。在多租户环境中,一线响应人员未察觉到当前故障的每一分钟,都会导致财务损失与声誉损害成倍加剧。
值班团队中普遍存在的告警疲劳进一步加剧了这一风险。被大量低优先级信息提示淹没的工程师会逐渐产生心理脱敏,导致真正的一级(Severity-1)严重告警在杂乱的消息队列中被忽视。因此,生产环境告警平台必须将低优先级的普通通知与需要采取行动的运维故障升级明确区分开来。通过将 Twilio 关键通知与 SendGrid 工作流同严格的多渠道路由进行同步,企业能够有效隔离高优先级的紧急事件,确保工程师接收到明确无误的告警以及可供操作的修复上下文。
技术解决方案:自动化多渠道故障转移级联如何路由告警?
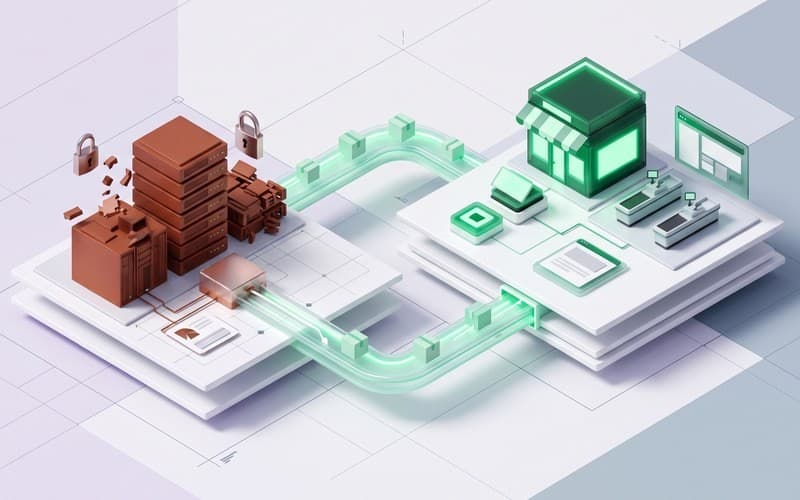
在这一 Twilio 集成案例中,为彻底消除告警死角并实现可靠的故障升级转移路由,工程团队设计了由集中调度状态机控制的自动化多渠道故障转移级联,构建起高可用 Twilio 告警系统。该工作流始于第 1 层级(Tier 1):关键任务遥测数据一旦监测到严重告警,系统便会向分布式值班工程团队同时发送 Twilio Programmable SMS 短信与自动化语音播报。语音呼叫包含交互式提示以实现按键即时确认,短信则同步送达简明的故障诊断摘要。
若在 60 秒内未记录到回执确认或工程师响应,多渠道告警通知引擎将触发第 2 层级(Tier 2):自动化 Twilio WhatsApp 备用通道集成。WhatsApp 消息借助富文本格式提供故障处置手册(Runbook)链接和交互式按钮,有效规避常规运营商短信瓶颈与运营商过滤拦截。根据Twilio 的出向消息状态文档,异步状态回调能够追踪消息在已发送(sent)、已送达(delivered)和已读(read)状态间的流转,以进行确定性送达回执验证,确保消息真实送达终端设备。
与此同时,第 3 层级(Tier 3)激活 Twilio 关键通知与 SendGrid Runbook 归档协同,将详尽的诊断快照发送至团队邮件分发列表。这一企业级 Twilio 告警架构通过将回执 Webhook 汇入不可篡改的送达审计追踪日志实现闭环,确保每个层级都具备端到端的可追溯性。
实施与安全加固:Canvas Developers 如何构建并保障路由引擎的安全?
在该 Twilio 集成案例中落地企业级 Twilio 告警架构时,Canvas Developers 通过在成熟的工程框架下指导 AI 编程智能体生成分发模式(dispatch schemas)、Webhook 端点以及单元测试套件,显著加快了交付进度。尽管 AI 编程工具擅长生成样板化集成逻辑和标准载荷解析,但它们无法预判分布式系统的极端边界情况或企业级安全要求。经验丰富的软件工程师全程主导了所有开发工作,统领系统架构设计,开展严格的代码审查,并统筹做出所有生产环境发布决策。
工程团队的人工把关重点聚焦于并发控制、幂等性令牌,以及跨多渠道故障转移级联的故障升级转移路由状态机边界。为了在突发流量下维持高可用告警,资深工程师为该高可用 Twilio 告警系统设计了强制执行分布式去重的消息队列,以防止在网络重试期间重复派发告警。此外,工程团队全面审计了所有安全边界,针对传入的 Webhook 实施严格的签名验证,并设立分级限流机制,以保护上游服务免在大范围区域性云服务故障期间因请求超限而被限流。
实测成效:零丢失路由架构在生产环境中带来了哪些价值?
部署这一多渠道告警通知引擎,充分印证了结构化故障转移如何有效缓解异构运营商网络中的送达脆弱性。在该业务场景的生产环境基准测试中,该架构彻底消除了故障漏报,每月处理超过 180,000 条紧急群组通知,送达验证率高达 99.99%。以往因移动端静默丢件而导致失败的故障升级流程,如今无需人工干预即可通过故障升级转移路由成功分流至备用通信渠道。
对于正在评估类似基础设施的工程团队而言,本 Twilio 集成案例清晰概述了加固的高可用 Twilio 告警系统通知流水线能为团队带来怎样的预期成效。在实际落地中,涵盖架构范围界定、Webhook 集成和状态机测试的实施周期通常为三到六周。由此构建的系统在建立可验证审计日志的同时,能够在大规模网络事件期间始终保持出色的运维韧性。
工程实践启示:团队应如何推进故障升级基础设施现代化?
构建高韧性的故障升级引擎,要求工程团队将通信渠道视为不可靠的分布式依赖项。核心架构原则要求实现自动化多供应商故障转移、严格的幂等性控制以及主动回执验证,而非直接采信网关返回的初始状态码。部署高可用 Twilio 告警系统,能够确保关键告警穿透运营商过滤拦截壁垒,在影响波及客户之前可靠触达对应的值班响应人员。
正如本篇 Twilio 集成案例所阐述的,彻底消除未确认的故障停机既需要严密的系统设计,也离不开扎实的工程落地。致力于实现值班告警工作流现代化的工程团队负责人,可选择与 Canvas Developers 携手合作。如需探讨您的平台需求或申请针对性的架构评估,欢迎通过联系表单提交咨询:https://www.canvasdevelopers.com/contact。