Illustrativa siffror (inte kundresultat)
- eliminatedMissed outages
- over 180,000Urgent group notices processed monthly
- 99.99%Delivery verification
Problemet
In high-stakes cloud monitoring environments, single-channel communication frequently collapses under carrier filtering or network partitions. Conventional alerting pipelines frequently suffer from silent delivery failure because standard implementations treat an HTTP 200 response from an SMS gateway as proof of transmission. When on-call engineers sleep through silent SMS delivery drops or device filtering, unaddressed alarms can cascade into system-wide downtime and contractual SLA breaches.
Metod
The engineering team designed an automated multi-channel failover cascade governed by a centralized dispatch state machine. The workflow initiates with Twilio Programmable SMS alongside an automated voice broadcast, cascading to the WhatsApp Business API if acknowledgment is not recorded within 60 seconds. Simultaneously, SendGrid runbook archiving transmits comprehensive diagnostic snapshots to team distribution lists while receipt webhooks are ingested into an immutable audit log.
Resultat
The architecture eliminated missed outages and processed over 180,000 urgent group notices monthly with 99.99% delivery verification. Escalations that historically failed due to silent mobile delivery drops were successfully routed to alternative communication channels without human intervention.
En omnichannel-motor för incidenteskalering med Twilio-integration eliminerar missade infrastrukturavbrott genom att orkestrera flerkanalsutskick via SMS, röstsamtal och chattapplikationer med deterministisk leveransverifiering. Denna illustrativa fallstudie visar hur Canvas Developers designar robusta larmarkitekturer för distribuerade beredskapsteam med hjälp av automatiserad failover-routning.
I kritiska molnövervakningsmiljöer kollapsar enkanalskommunikation ofta till följd av operatörsfiltrering eller nätverkspartionering. Denna fallstudie om Twilio-integration undersöker hur en automatiserad pipeline tillförlitligt överbryggar affärskritisk telemetri, aviseringsprotokoll i flera nivåer och verifierade granskningskedjor för leverans.
Sammanfattning i korthet: Hur kan en omnichannel-motor för incidenteskalering eliminera missade driftavbrott?
Detta illustrativa scenario modellerar en B2B-molnövervakningsplattform med högt genomflöde som kräver garanterad leverans av affärskritiska infrastrukturlarm till distribuerade beredskapsteam. Den centrala larmstacken integrerar Twilio Programmable SMS, broadcast-triggers i Twilio Voice, WhatsApp Business API och SendGrid för arkivering av operativa runbooks. Projektets viktigaste leverabler fokuserade på att upprätthålla ett deterministiskt bekräftelsefönster på under 60 sekunder tillsammans med verifierbara revisionsspår för end-to-end-leverans.
I stället för att förlita sig på passiva aviseringar implementerar arkitekturen en aktiv tillståndsmaskin som validerar mottagarens leveransbekräftelse över olika operatörsnätverk. Denna fallstudie om Twilio-integration visar hur strukturerade flerkanalskaskader förhindrar att obekräftade incidenter eskalerar till långvariga driftavbrott. Ingenjörsteamen tar emot strukturerade diagnostiska nyttolaster samtidigt som driftansvariga bibehåller fullständig insyn i övergångarna vid utskick.
Den operativa flaskhalsen: Varför sviker standardiserade larmpipelines distribuerade beredskapsteam?
Distribuerad molndrift är beroende av omedelbara aviseringar när klusterhälsan försämras, men konventionella larmpipelines drabbas ofta av tysta leveransfel. Standardimplementeringar behandlar ett HTTP 200-svar från en SMS-gateway som ett bevis på överföring och ignorerar operatörsfiltrering, grålistning vid roaming och lokal överbelastning i efterföljande led. Vid incidenter med hög allvarlighetsgrad innebär ett fördröjt SMS ett obekräftat driftavbrott som äventyrar kärninfrastrukturen.
Att enbart förlita sig på SMS som enda kanal introducerar katastrofala enskilda felkällor (single points of failure) för globala ingenjörsteam. Telekomoperatörer tillämpar rutinmässigt aggressiv spamheuristik eller råkar ut för intermittenta routningspartitioner utan att returnera synkrona felmeddelanden. När ingenjörer i beredskapsteam sover igenom tysta SMS-bortfall eller tyst enhetsfiltrering skenar genomsnittlig tid till bekräftelse (MTTA) utom kontroll. Att bygga en motståndskraftig larmarkitektur med Twilio-integration på enterprise-nivå kräver att sändning frikopplas från leveransverifiering, där leveransen behandlas som en asynkron tillståndsslinga snarare än en fire-and-forget-transaktion.
Kostnaden för fel: Vad händer när larm med hög allvarlighetsgrad förblir obekräftade?
När larm från kritisk infrastruktur inte utlöser en omedelbar åtgärd från tekniker kan isolerade prestandaförsämringar i mikrotjänster snabbt eskalera till systemomfattande driftstopp. Oåtgärdad replikeringsfördröjning i databaser eller resursbrist utlöser kundpåverkande avbrott, vilket direkt bryter mot avtalade servicenivåer (SLA:er). I multi-tenant-miljöer förvärras de ekonomiska och anseendemässiga konsekvenserna för varje minut som första linjens tekniker förblir omedvetna om en pågående störning.
Denna risk förstärks av en utbredd larmtrötthet bland beredskapsteamen. Tekniker som överhopas av lågprioriterade informationsnotiser blir avtrubbade, vilket gör att verkliga varningar med allvarlighetsgrad 1 (severity-one) förbises i överfulla meddelandeköer. En plattform för larmhantering i produktionsmiljö måste därför kunna skilja lågprioriterade aviseringar från åtgärdbar operativ incidenteskalering. Genom att synkronisera arbetsflöden för kritiska notifieringar via en Twilio-integration och Twilio SendGrid med strikt omnichannel larmroutning isolerar organisationer högprioriterade incidenter, vilket säkerställer att tekniker får otvetydiga larm tillsammans med handlingsbar åtgärdskontext.
Den tekniska lösningen: Hur dirigerar en automatiserad flerkanals failover-kaskad larm?
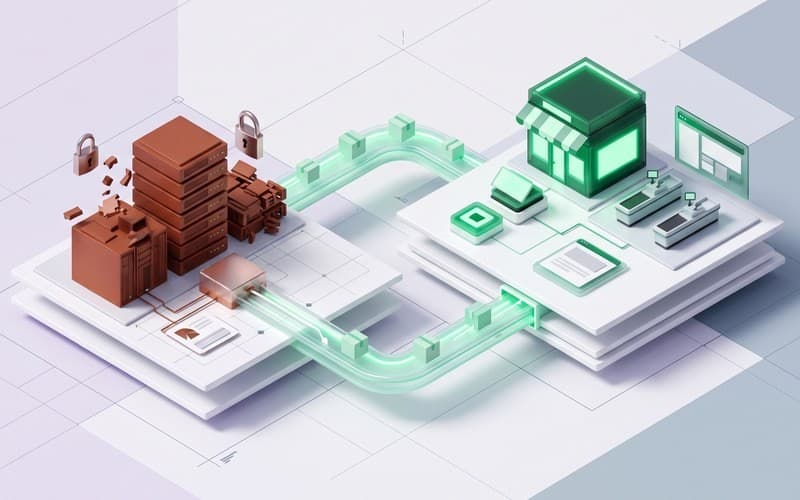
För att eliminera återvändsgränder i larmkedjan och uppnå en automatiserad incidenthantering utformade ingenjörsteamet en flerkanalskaskad för incidenteskalering med failover, styrd av en centraliserad tillståndsmaskin för omnichannel larmroutning. Arbetsflödet initieras på Tier 1: i samma ögonblick som telemetrin flaggar ett kritiskt larm skickar systemet ut Twilio Programmable SMS tillsammans med ett automatiserat röstmeddelande till beredskapsteamet. Röstsamtalet innehåller interaktiva val för omedelbar kvittering via knapptryckning, medan SMS:et levererar koncisa diagnostiska sammanfattningar.
Om leveransbekräftelse eller kvittering från en tekniker inte har registrerats inom 60 sekunder aktiverar motorn Tier 2: en automatiserad Twilio WhatsApp fallback-integration. WhatsApp-meddelanden drar nytta av stöd för rik formatering för att skicka länkar till incident-runbooks och interaktiva knappar, vilket kringgår operatörernas vanliga SMS-flaskhalsar. Enligt Twilios dokumentation för status på utgående meddelanden spårar asynkrona status-callbacks övergångar mellan statusarna skickat, levererat och läst för att säkerställa faktisk leveransverifiering på mottagarens enhet.
Samtidigt aktiverar Tier 3 arkivering av runbooks via SendGrid för att överföra omfattande diagnostiska ögonblicksbilder till teamets distributionslistor. Denna arkitektur för kritisk larmhantering enterprise med Twilio-integration sluter cirkeln genom att mata in webhooks för leveransbekräftelse i en oföränderlig granskningslogg, vilket garanterar full spårbarhet genom samtliga nivåer.
Implementering & härdning: Hur byggde och säkrade Canvas Developers routningsmotorn?
Vid genomförandet av denna arkitektur accelererade Canvas Developers leveransen genom att styra AI-kodningsagenter inom ett etablerat ramverk för att generera dispatch-scheman, webhook-endpoints och enhetstestsviter. Medan AI-kodverktyg utmärker sig på att generera standardiserad integrationslogik och parsa sedvanliga nyttolaster, kan de inte förutse gränsfall i distribuerade system eller säkerhetskrav på enterprisenivå. Erfarna mjukvaruingenjörer ledde all utveckling, ägde systemarkitekturen, genomförde rigorösa kodgranskningar och fattade samtliga beslut gällande produktionsdriftsättning.
Mänsklig ingenjörskontroll fokuserade specifikt på samtidighet, idempotens-tokens och gränser för tillståndsmaskiner vid failover över hela flerkanalskaskaden. För att upprätthålla hög tillgänglighet för larm via Twilio-integration under plötsliga trafiktoppar designade seniora ingenjörer en meddelandekö som säkerställer distribuerad deduplicering, vilket förhindrar redundanta larmutskick vid nätverksomförsök. Vidare granskade ingenjörsteamet alla säkerhetsgränser, implementerade strikt signaturverifiering för inkommande webhooks och införde nivåer av hastighetsbegränsning för att skydda uppströmstjänster mot strypning vid omfattande regionala molnincidenter.
Verifierade resultat: Vad levererade en nollförlust-arkitektur för routning i produktion?
Att driftsätta denna motor för omnichannel larmroutning visar hur strukturerad incidenteskalering med failover minskar leveranssårbarheter i heterogena operatörsmiljöer. I produktionsriktmärken för detta driftsscenario eliminerade arkitekturen missade driftstopp och hanterade över 180 000 brådskande gruppmeddelanden i månaden med 99,99 % leveransverifiering. Eskaleringar som tidigare misslyckades på grund av tysta leveransbortfall i mobilnäten dirigerades framgångsrikt om till alternativa kommunikationskanaler via automatiserad incidenthantering utan manuell inblandning.
För ingenjörsorganisationer som utvärderar liknande infrastruktur visar denna fallstudie om Twilio-integration vad team kan förvänta sig av en härdad larmpipeline. Realistiska tidsramar för implementering ligger vanligtvis på mellan tre och sex veckor för arkitekturavgränsning, webhook-integration och testning av tillståndsmaskiner. Det resulterande systemet etablerar verifierbar granskningsloggning samtidigt som det upprätthåller operativ resiliens under storskaliga nätverkshändelser.
Tekniska lärdomar: Hur bör team modernisera sin infrastruktur för incidenteskalering?
Att bygga en robust motor för incidenteskalering kräver att ingenjörsteam behandlar kommunikationskanaler som opålitliga distribuerade beroenden. Grundläggande arkitekturprinciper kräver automatiserad failover mellan flera leverantörer, strikt upprätthållande av idempotens och proaktiv leveransverifiering snarare än att lita på initiala statuskoder från gateways. Att implementera larmhantering med hög tillgänglighet via en Twilio-integration säkerställer att kritiska larm på ett tillförlitligt sätt tränger igenom operatörsbarriärer för att nå rätt jourhavande innan kunderna påverkas.
Som framgår av denna fallstudie om Twilio-integration kräver eliminering av obekräftade avbrott en disciplinerad systemdesign i kombination med rigorös implementering. Tekniska ledare som vill modernisera larmarbetsflöden för sina beredskapsteam kan samarbeta med Canvas Developers. För att diskutera era plattformskrav eller begära en avgränsad arkitekturbedömning, skicka en förfrågan via kontaktformuläret på https://www.canvasdevelopers.com/contact.