Dati illustrativi (non risultati di clienti)
- eliminatedMissed outages
- over 180,000Urgent group notices processed monthly
- 99.99%Delivery verification
Il problema
In high-stakes cloud monitoring environments, single-channel communication frequently collapses under carrier filtering or network partitions. Conventional alerting pipelines frequently suffer from silent delivery failure because standard implementations treat an HTTP 200 response from an SMS gateway as proof of transmission. When on-call engineers sleep through silent SMS delivery drops or device filtering, unaddressed alarms can cascade into system-wide downtime and contractual SLA breaches.
Approccio
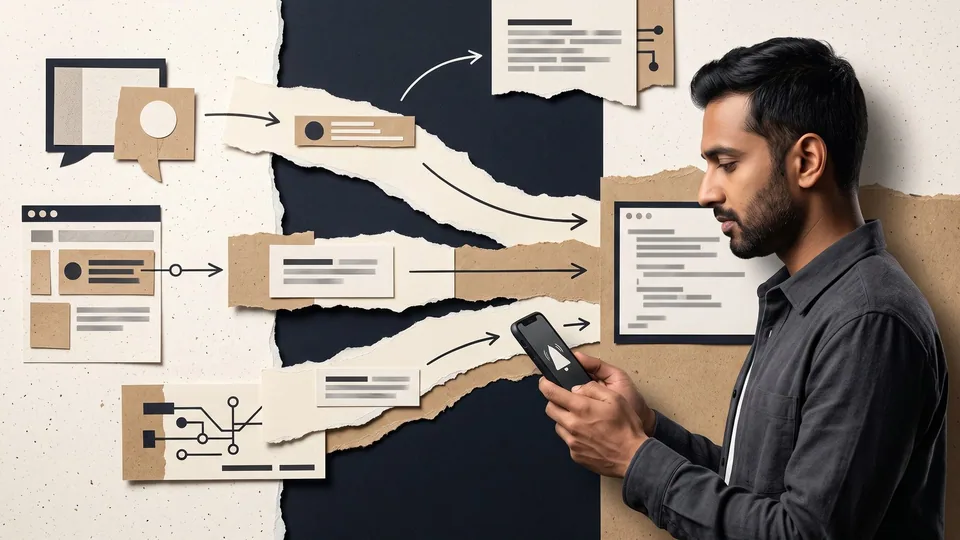
The engineering team designed an automated multi-channel failover cascade governed by a centralized dispatch state machine. The workflow initiates with Twilio Programmable SMS alongside an automated voice broadcast, cascading to the WhatsApp Business API if acknowledgment is not recorded within 60 seconds. Simultaneously, SendGrid runbook archiving transmits comprehensive diagnostic snapshots to team distribution lists while receipt webhooks are ingested into an immutable audit log.
Risultato
The architecture eliminated missed outages and processed over 180,000 urgent group notices monthly with 99.99% delivery verification. Escalations that historically failed due to silent mobile delivery drops were successfully routed to alternative communication channels without human intervention.
Un motore per l'escalation degli incidenti con alerting multicanale elimina il rischio di disservizi infrastrutturali non rilevati, orchestrando l'inoltro multicanale attraverso SMS, chiamate vocali e applicazioni di messaggistica con verifica deterministica della ricezione. Questo case study integrazione Twilio dimostra come Canvas Developers progetta un'architettura alerting Twilio resiliente per team on-call distribuiti mediante il routing di failover automatizzato.
Nei contesti di monitoraggio cloud ad alta criticità, la comunicazione a canale singolo fallisce frequentemente a causa del filtraggio degli operatori o di partizioni di rete. Questo case study sull'integrazione di Twilio esamina come una pipeline automatizzata colleghi in modo affidabile telemetria mission-critical, protocolli di notifica multilivello e una traccia di audit delle consegne verificate.
Sintesi in breve: come può un motore di escalation multicanale eliminare i disservizi non gestiti?
Questo scenario illustrativo modella una piattaforma di monitoraggio cloud B2B ad alto throughput che richiede la consegna garantita per gli allarmi di infrastruttura mission-critical destinati a team on-call distribuiti. L'architettura alerting Twilio principale integra Twilio Programmable SMS, trigger di trasmissione Twilio Voice, l'API WhatsApp Business e SendGrid per l'archiviazione dei runbook operativi. I deliverable chiave del progetto si sono concentrati sull'applicazione di una finestra deterministica di presa in carico inferiore a 60 secondi, affiancata da una traccia di audit verificabile ed end-to-end sulla consegna.
Invece di affidarsi a notifiche passive, l'architettura implementa una macchina a stati attiva che convalida l'avvenuta ricezione da parte del destinatario attraverso reti di operatori eterogenee. Questo case study integrazione Twilio dimostra come cascate multicanale strutturate evitino l'escalation degli incidenti non presi in carico in prolungate interruzioni del servizio. I team di ingegneria ricevono payload diagnostici strutturati, mentre i responsabili delle operations mantengono la piena visibilità sulle transizioni di invio.
Il collo di bottiglia operativo: perché le pipeline di alerting standard falliscono con i team on-call distribuiti?
Le operations cloud distribuite dipendono da notifiche immediate quando lo stato di salute dei cluster si degrada, eppure le pipeline di alerting convenzionali soffrono frequentemente di mancati recapiti silenti. Le implementazioni standard considerano una risposta HTTP 200 da parte di un gateway SMS come prova di trasmissione, ignorando il filtraggio degli operatori, il greylisting in roaming e le congestioni downstream localizzate. Negli incidenti ad alta gravità, un SMS in ritardo rappresenta un disservizio non preso in carico che compromette l'infrastruttura critica.
Affidarsi esclusivamente a un canale SMS singolo introduce catastrofici single point of failure tra i team di ingegneria globali. Gli operatori di telecomunicazioni applicano regolarmente euristiche antispam aggressive o riscontrano partizioni di rete intermittenti a livello di routing senza restituire payload di errore sincroni. Quando gli ingegneri on-call non vengono svegliati a causa di mancati recapiti SMS silenti o del filtraggio silente dei dispositivi, il mean time to acknowledge (MTTA) va fuori controllo. Costruire un'architettura alerting Twilio enterprise resiliente richiede di disaccoppiare la trasmissione dalla verifica del recapito, trattando la consegna come un ciclo di stato asincrono anziché come una transazione fire-and-forget.
Il costo del fallimento: cosa accade quando gli allarmi ad alta gravità non vengono presi in carico?
Quando gli allarmi dell'infrastruttura critica non innescano una risposta immediata da parte degli ingegneri, lo stato di degrado di un microservizio isolato può rapidamente propagarsi a cascata in un downtime dell'intero sistema. Il ritardo di replica del database non gestito o l'esaurimento delle risorse provocano disservizi con impatto diretto sui clienti, violando gli accordi contrattuali sul livello del servizio (SLA). Negli ambienti multi-tenant, le ricadute economiche e reputazionali si aggravano per ogni minuto in cui i responder tier-1 restano all'oscuro di un'interruzione in corso.
Ad aggravare questo rischio si aggiunge la diffusa alert fatigue tra i team on-call. Gli ingegneri sommersi da notifiche informative a bassa priorità sviluppano una progressiva assuefazione, facendo sì che autentici allarmi severity-one passino inosservati in code di messaggi intasate. Una piattaforma di alerting in produzione deve quindi saper distinguere le notifiche a bassa urgenza da un'escalation degli incidenti operativa e azionabile. Sincronizzando i flussi di notifiche critiche Twilio SendGrid con un rigoroso routing multicanale, le organizzazioni isolano le emergenze ad alta priorità, garantendo che gli ingegneri ricevano alert inequivocabili accompagnati dal contesto necessario per una rapida remediation.
La soluzione tecnica: come instrada gli alert una cascata automatizzata di routing di failover multicanale?
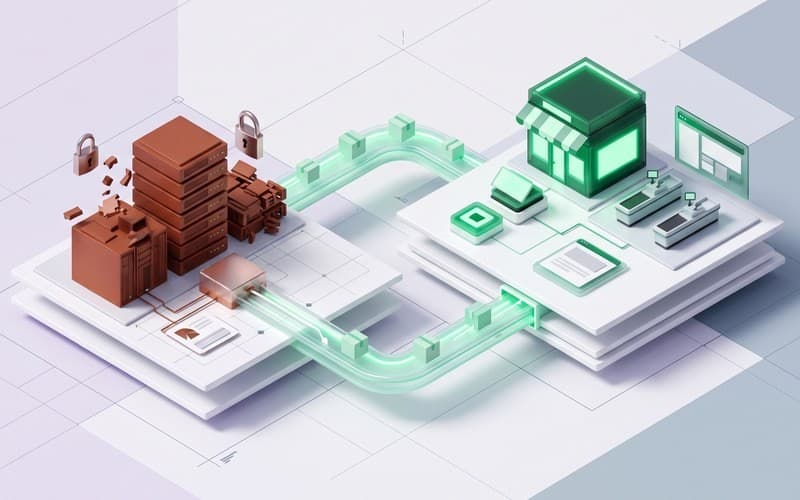
Per eliminare i vicoli ciechi nell'alerting, il team di ingegneria ha progettato una cascata automatizzata di routing di failover multicanale governata da una macchina a stati di dispatch centralizzata. Il workflow si avvia al Tier 1: non appena la telemetria segnala un allarme critico, il sistema invia notifiche tramite Twilio Programmable SMS insieme a una trasmissione vocale automatizzata al personale dei team on-call. La chiamata vocale riproduce prompt interattivi per la conferma immediata tramite pressione dei tasti, mentre l'SMS fornisce riepiloghi diagnostici sintetici.
Se la conferma di ricezione o la presa in carico da parte dell'ingegnere non viene registrata entro 60 secondi, il motore attiva il Tier 2: un'integrazione automatizzata di fallback SMS WhatsApp Twilio. I messaggi WhatsApp sfruttano la formattazione avanzata per recapitare pulsanti interattivi e link ai runbook per l'escalation degli incidenti, aggirando i consueti colli di bottiglia degli operatori SMS. Secondo la documentazione di Twilio sullo stato dei messaggi in uscita, i callback di stato asincroni tracciano le transizioni attraverso gli stati sent, delivered e read per verificare l'effettiva ricezione sul dispositivo.
Contemporaneamente, il Tier 3 attiva l'archiviazione dei runbook con SendGrid per trasmettere snapshot diagnostici completi alle liste di distribuzione del team. Questa architettura alerting Twilio di livello enterprise chiude il cerchio acquisendo i webhook di ricezione in una traccia di audit immutabile, garantendo la tracciabilità end-to-end a ogni livello.
Implementazione & Hardening: come Canvas Developers ha sviluppato e protetto il motore di routing?
Nel realizzare questa architettura di alerting Twilio, Canvas Developers ha accelerato i tempi di rilascio guidando agenti AI di coding all'interno di un harness strutturato per generare schemi di dispatch, endpoint webhook e suite di unit test. Sebbene gli strumenti di coding AI eccellano nella generazione della logica di integrazione boilerplate e nel parsing standard dei payload, non possono prevedere i casi limite dei sistemi distribuiti né i requisiti di sicurezza enterprise. Software engineer esperti hanno guidato l'intero sviluppo, presidiato l'architettura di sistema, condotto rigorose code review e preso tutte le decisioni relative ai rilasci in produzione.
La supervisione ingegneristica umana si è concentrata in modo specifico su concorrenza, token di idempotenza e limiti della macchina a stati per il routing di failover lungo la cascata multicanale. Per mantenere un alerting ad alta affidabilità Twilio anche in presenza di picchi di traffico, i senior engineer hanno progettato una coda di messaggi che applica la deduplicazione distribuita, impedendo l'invio di alert ridondanti durante i retry di rete. Inoltre, il team di ingegneria ha sottoposto ad audit tutti i perimetri di sicurezza, implementando una rigorosa verifica delle firme per i webhook in ingresso e applicando livelli di rate limiting per proteggere i servizi upstream dal throttling durante disservizi cloud regionali su larga scala.
Risultati verificati: cosa ha garantito in produzione l'architettura di routing zero-drop?
L'adozione di questo motore di routing multicanale dimostra come un routing di failover strutturato mitighi la vulnerabilità di recapito tra ambienti eterogenei di operatori telefonici. Nei benchmark di produzione relativi a questo scenario operativo, l'architettura ha eliminato i disservizi non rilevati ed elaborato oltre 180.000 notifiche urgenti di gruppo al mese, con una verifica di recapito del 99,99%. I processi di escalation degli incidenti che in precedenza fallivano a causa della perdita silenziosa dei messaggi su rete mobile sono stati instradati con successo verso canali di comunicazione alternativi, senza alcun intervento umano.
Per le organizzazioni di ingegneria che valutano un'infrastruttura analoga, questo case study integrazione Twilio illustra cosa possono attendersi i team da una pipeline di notifiche rinforzata. Le tempistiche realistiche di implementazione variano in genere da tre a sei settimane per la definizione dell'architettura, l'integrazione dei webhook e i test delle macchine a stati. Il sistema risultante stabilisce una traccia di audit verificabile, mantenendo al contempo la resilienza operativa durante eventi di rete su larga scala.
Considerazioni ingegneristiche: come dovrebbero i team modernizzare la propria infrastruttura di escalation degli incidenti?
Costruire un motore di escalation degli incidenti resiliente richiede che i team di ingegneria trattino i canali di comunicazione come dipendenze distribuite inaffidabili. I principi architetturali fondamentali esigono un failover multi-provider automatizzato, una rigorosa applicazione dell'idempotenza e la verifica proattiva della ricezione, invece di fare affidamento sui codici di stato iniziali del gateway. L'implementazione di un alerting ad alta affidabilità Twilio assicura che gli allarmi critici superino in modo affidabile le barriere degli operatori per raggiungere il responder designato prima che si verifichi un impatto sui clienti.
Come evidenziato in questo case study di integrazione Twilio, eliminare i disservizi non presi in carico richiede una progettazione di sistema disciplinata unita a un'implementazione rigorosa. I responsabili di ingegneria che desiderano modernizzare i flussi di lavoro di alerting per i team on-call possono collaborare con Canvas Developers. Per discutere i requisiti della vostra piattaforma o richiedere una valutazione architetturale mirata, inviate una richiesta tramite il modulo di contatto all'indirizzo https://www.canvasdevelopers.com/contact.