예시 수치(고객 성과 아님)
- eliminatedMissed outages
- over 180,000Urgent group notices processed monthly
- 99.99%Delivery verification
문제
In high-stakes cloud monitoring environments, single-channel communication frequently collapses under carrier filtering or network partitions. Conventional alerting pipelines frequently suffer from silent delivery failure because standard implementations treat an HTTP 200 response from an SMS gateway as proof of transmission. When on-call engineers sleep through silent SMS delivery drops or device filtering, unaddressed alarms can cascade into system-wide downtime and contractual SLA breaches.
접근 방식
The engineering team designed an automated multi-channel failover cascade governed by a centralized dispatch state machine. The workflow initiates with Twilio Programmable SMS alongside an automated voice broadcast, cascading to the WhatsApp Business API if acknowledgment is not recorded within 60 seconds. Simultaneously, SendGrid runbook archiving transmits comprehensive diagnostic snapshots to team distribution lists while receipt webhooks are ingested into an immutable audit log.
성과
The architecture eliminated missed outages and processed over 180,000 urgent group notices monthly with 99.99% delivery verification. Escalations that historically failed due to silent mobile delivery drops were successfully routed to alternative communication channels without human intervention.
옴니채널 인시던트 에스컬레이션 엔진은 SMS, 음성 통화, 채팅 애플리케이션 전반에 걸친 다채널 발송을 체계적으로 조율하고 결정론적 수신 확인을 통해 인프라 장애 누락을 방지합니다. 이번 Twilio 연동 사례에서는 Canvas Developers가 자동화된 페일오버 라우팅을 활용해 분산된 온콜 엔지니어링 팀을 위한 복원력 있는 Twilio 알림 아키텍처를 어떻게 설계하는지 보여줍니다.
안정성이 매우 중요한 클라우드 모니터링 환경에서는 통신사 필터링이나 네트워크 파티션으로 인해 단일 채널 통신이 실패하는 경우가 빈번합니다. 본 Twilio 연동 사례에서는 자동화된 고가용성 알림 파이프라인이 미션 크리티컬 텔레메트리, 다계층 알림 프로토콜, 검증된 전송 감사 추적을 어떻게 안정적으로 연계하는지 살펴봅니다.
한눈에 보는 요약: 옴니채널 에스컬레이션 엔진은 어떻게 서비스 장애 누락을 방지할 수 있을까요?
본 시나리오는 분산된 온콜 엔지니어링 팀 전반에서 미션 크리티컬 인프라 알람의 전송을 보장해야 하는 고처리량 B2B 클라우드 모니터링 플랫폼을 모델링합니다. 핵심 고가용성 알림 파이프라인은 Twilio Programmable SMS, Twilio Voice 브로드캐스트 트리거, WhatsApp Business API, 그리고 운영 런북 아카이빙을 위한 SendGrid를 통합합니다. 주요 프로젝트 과제는 검증 가능한 엔드투엔드 전송 감사 추적과 함께 60초 미만의 확정적인 인지 시간을 보장하는 데 중점을 두었습니다.
수동적인 알림에 의존하는 대신, 해당 Twilio 알림 아키텍처는 이기종 통신사 네트워크 전반에서 수신자의 수신 확인을 검증하는 능동적 상태 머신을 구현합니다. 본 Twilio 연동 사례는 구조화된 다채널 인시던트 에스컬레이션 라우팅을 통해 확인되지 않은 인시던트가 장기적인 서비스 중단으로 확대되는 것을 방지하는 방법을 보여줍니다. 엔지니어링 팀은 구조화된 진단 페이로드를 수신하고, 운영 리더는 발송 전환 과정 전반에 대한 완벽한 가시성을 유지합니다.
운영상의 병목 현상: 분산 온콜 엔지니어링 팀에서 표준 알림 파이프라인이 실패하는 이유
클러스터 상태가 저하될 때 분산 클라우드 운영 환경은 즉각적인 알림에 의존하지만, 기존 알림 파이프라인은 조용한 전송 실패(silent delivery failure)를 빈번하게 겪습니다. 표준 구현 방식에서는 SMS 게이트웨이의 HTTP 200 응답을 전송 완료의 증거로 간주하여, 통신사 필터링, 로밍 그레이리스팅(roaming greylisting), 국지적 다운스트림 혼잡 등을 무시합니다. 심각도가 높은 인시던트 발생 시, 지연된 문자 메시지는 핵심 인프라를 위협하는 미인지 장애로 이어집니다.
단일 채널 SMS에만 전적으로 의존하는 방식은 글로벌 엔지니어링 조직 전반에 치명적인 단일 장애점(SPOF)을 초래합니다. 통신사는 동기식 오류 페이로드를 반환하지 않은 채 일상적으로 공격적인 스팸 휴리스틱을 적용하거나 간헐적인 라우팅 파티션 문제를 겪곤 합니다. 온콜 엔지니어가 조용한 SMS 전송 누락이나 기기의 무음 필터링으로 인해 알림을 놓치고 잠들 경우, 평균 인지 시간(MTTA)은 걷잡을 수 없이 치솟습니다. 실제 Twilio 연동 사례에서 복원력 있는 엔터프라이즈 Twilio 알림 아키텍처를 구축하려면 전송과 수신 확인을 분리하고, 전송을 단순 발송(fire-and-forget) 트랜잭션이 아닌 비동기 상태 루프로 처리해야 합니다.
대응 실패의 대가: 심각도 높은 알림을 인지하지 못하면 어떤 일이 일어날까요?
핵심 인프라 알림이 엔지니어의 즉각적인 대응으로 이어지지 못하면, 개별 마이크로서비스의 국소적인 성능 저하가 순식간에 연쇄 확산되어 시스템 전반의 다운타임으로 이어집니다. 해결되지 않은 데이터베이스 복제 지연이나 리소스 고갈은 고객에게 직접적인 영향을 미치는 서비스 장애를 유발하여, 계약상 체결된 서비스 수준 협약(SLA)을 직접적으로 위반하게 됩니다. 특히 멀티테넌트 환경에서는 1차 대응 담당자가 발생한 장애를 인지하지 못하는 매 1분이 지날수록 재정적 손실과 대외적 평판 실추가 눈덩이처럼 불어납니다.
이러한 위험을 더욱 가중하는 요인은 온콜 엔지니어링 담당자들 사이에 만연한 알림 피로입니다. 우선순위가 낮은 단순 정보성 알림에 끊임없이 노출된 엔지니어들은 알림에 만성화되기 쉬우며, 이로 인해 복잡한 메시지 큐 속에서 실제 심각도 1(Severity-1) 수준의 긴급 경고를 놓치게 됩니다. 따라서 프로덕션 환경의 고가용성 알림 파이프라인은 긴급도가 낮은 알림과 즉각 조치가 필요한 운영상의 인시던트 에스컬레이션을 명확히 구분해야 합니다. 실제 Twilio 연동 사례에서와 같이, 엄격한 다중 채널 인시던트 에스컬레이션 라우팅과 Twilio SendGrid 긴급 알림 워크플로를 동기화함으로써 조직은 우선순위가 높은 비상 상황을 효과적으로 격리하고, 엔지니어가 실행 가능한 조치 컨텍스트가 포함된 명확한 알림을 확실하게 수신하도록 지원합니다.
기술적 솔루션: 자동화된 다중 채널 페일오버 캐스케이드는 알림을 어떻게 라우팅할까요?
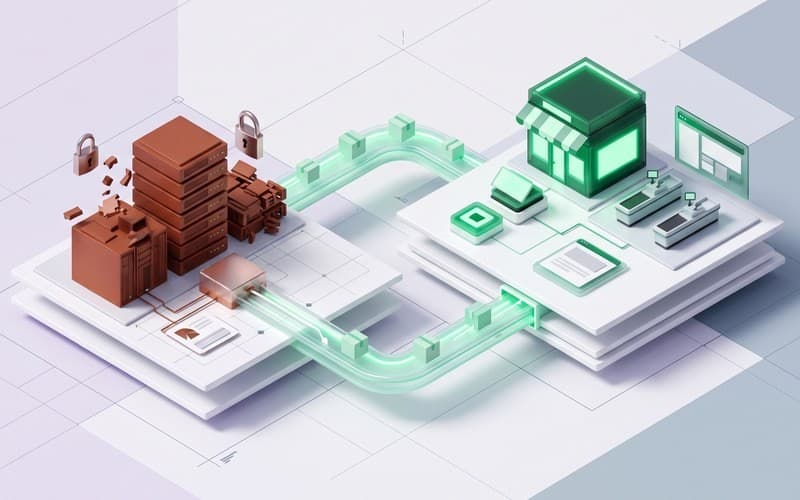
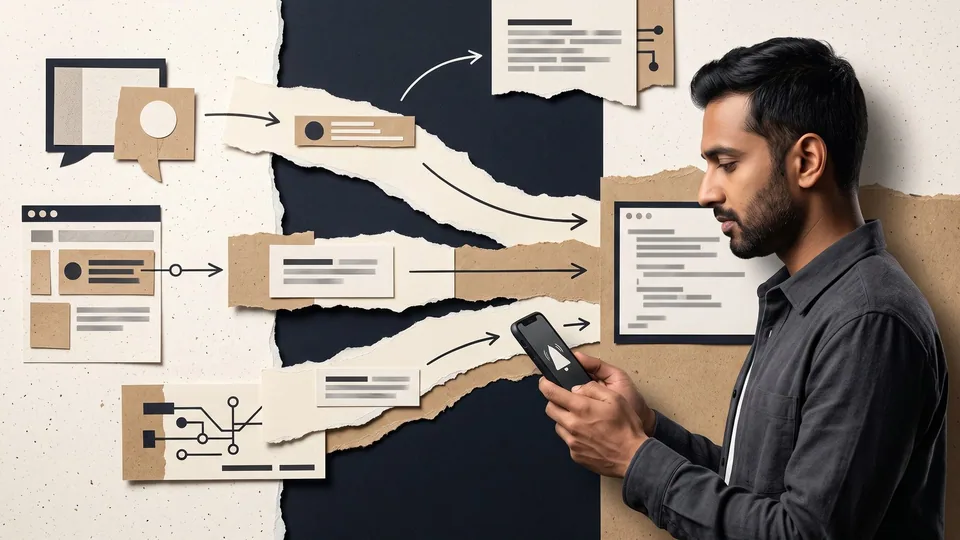
알림 사각지대를 완전히 해소하기 위해, 이번 Twilio 연동 사례에서 엔지니어링 팀은 중앙 집중식 디스패치 상태 머신으로 제어되는 고가용성 알림 파이프라인 기반의 자동화된 다중 채널 페일오버 캐스케이드를 설계했습니다. 인시던트 에스컬레이션 라우팅 워크플로는 Tier 1에서 시작됩니다. 원격 측정(telemetry) 데이터가 심각한 경보를 감지하는 즉시 시스템은 온콜 엔지니어링 담당자에게 Twilio Programmable SMS와 자동 음성 통화를 동시에 발송합니다. 음성 통화는 즉각적인 키패드 입력 확인(keypress acknowledgment)을 위한 대화형 안내를 실행하고, SMS는 간결한 진단 요약 정보를 전달합니다.
60초 이내에 수신 확인이나 엔지니어의 확인 응답이 기록되지 않으면, 엔진은 Tier 2를 실행하여 자동화된 Twilio WhatsApp 대체 발송 연동을 트리거합니다. WhatsApp 메시지는 서식 있는 텍스트(rich formatting)를 활용해 인시던트 런북 링크와 대화형 버튼을 함께 전달함으로써 일반적인 통신사 SMS의 병목 현상과 통신사 필터링을 우회합니다. Twilio의 아웃바운드 메시지 상태 문서에 따르면, 비동기 상태 콜백(status callback)이 발송(sent), 전달(delivered), 읽음(read) 상태 간의 전환을 추적하여 실제 단말기 도달 여부를 확인하는 수신 확인을 수행합니다.
이와 동시에 Tier 3에서는 Twilio SendGrid 긴급 알림 및 런북 아카이빙을 활성화하여 팀 배포 목록에 종합적인 진단 스냅샷을 전송합니다. 이러한 엔터프라이즈 Twilio 알림 아키텍처는 수신 웹훅을 불변의 전송 감사 추적 로그로 수집하여 대응 프로세스를 완결하며, 모든 계층에서 완벽한 엔드투엔드 추적성을 보장합니다.
구현 및 보안 강화: Canvas Developers는 라우팅 엔진을 어떻게 구축하고 보안을 확보했는가?
이번 Twilio 연동 사례의 아키텍처를 구현하면서, Canvas Developers는 사전에 정립된 하네스 내에서 AI 코딩 에이전트를 지휘하여 발송 스키마, 웹훅 엔드포인트 및 단위 테스트 스위트를 생성함으로써 딜리버리를 가속화했습니다. AI 코딩 도구는 보일러플레이트 연동 로직과 표준 페이로드 파싱을 생성하는 데 탁월하지만, 분산 시스템의 예외적인 엣지 케이스나 엔터프라이즈 보안 요구사항까지 예측할 수는 없습니다. 이에 숙련된 소프트웨어 엔지니어들이 전체 개발을 직접 지휘하고, 시스템 아키텍처를 주도적으로 책임졌으며, 엄격한 코드 리뷰를 진행하고 프로덕션 배포에 관한 모든 결정을 내렸습니다.
엔지니어링 팀의 전문적인 관리 감독은 특히 멀티채널 캐스케이드 전반의 동시성 제어, 멱등성 토큰, 그리고 페일오버 라우팅 상태 머신 경계에 집중되었습니다. 트래픽이 폭증하는 상황에서도 고가용성 알림 파이프라인을 기반으로 Twilio 알림 아키텍처의 고가용성을 유지하기 위해, 시니어 엔지니어들은 분산 중복 제거를 적용한 메시지 큐를 설계하여 네트워크 재시도 시 중복 알림이 발송되는 것을 방지했습니다. 아울러 엔지니어링 팀은 모든 보안 경계를 면밀히 점검하여 수신 웹훅에 대한 엄격한 서명 검증을 구현하고, 광범위한 리전 클라우드 인시던트 발생 시에도 업스트림 서비스가 스로틀링되지 않도록 보호하는 단계별 속도 제한(rate limiting) 계층을 적용했습니다.
검증된 성과: 프로덕션 환경에서 무유실 라우팅 아키텍처가 달성한 성과는 무엇인가?
이러한 다중 채널 라우팅 엔진의 도입은 이기종 통신사 환경 전반에서 체계적인 페일오버를 통해 전송 취약성을 어떻게 완화하는지 보여줍니다. 해당 운영 시나리오에 대한 프로덕션 벤치마크에서, 이 아키텍처는 장애 알림 누락을 원천 차단하고 99.99%의 수신 확인율로 매달 180,000건 이상의 긴급 그룹 공지를 성공적으로 처리했습니다. 과거 모바일 전송의 소리 없는 유실로 인해 실패하곤 했던 인시던트 에스컬레이션 라우팅은 담당자의 수작업 개입 없이 대체 커뮤니케이션 채널로 원활하게 연결되었습니다.
유사한 인프라 도입을 검토 중인 엔지니어링 조직에게, 이번 Twilio 연동 사례는 안정성이 검증된 고가용성 알림 파이프라인을 통해 기대할 수 있는 구체적인 가치를 제시합니다. 현실적인 구현 일정은 아키텍처 범위 정의, 웹훅 연동, 상태 머신 테스트를 포함해 일반적으로 3주에서 6주 정도 소요됩니다. 이를 통해 구축된 시스템은 대규모 네트워크 이벤트가 발생하더라도 운영 복원력을 견고히 유지하면서 신뢰할 수 있는 전송 감사 추적 체계를 확립합니다.
엔지니어링 시사점: 팀은 인시던트 에스컬레이션 인프라를 어떻게 현대화해야 할까요?
복원력 있는 인시던트 에스컬레이션 엔진을 구축하려면 엔지니어링 팀이 통신 채널을 신뢰할 수 없는 분산 의존성으로 간주해야 합니다. 핵심 아키텍처 원칙에 따르면 초기 게이트웨이 상태 코드만 신뢰하기보다는 자동화된 멀티 프로바이더 페일오버 라우팅, 엄격한 멱등성 보장, 선제적인 수신 확인이 필수적으로 요구됩니다. 고가용성 Twilio 알림 파이프라인을 구축하면 고객 피해가 발생하기 전에 핵심 경보가 통신사 필터링 장벽을 안정적으로 통과하여 적절한 담당자에게 도달하도록 보장할 수 있습니다.
이번 Twilio 연동 사례에서 강조되었듯이, 인지되지 않은 서비스 장애를 방지하려면 체계적인 시스템 설계와 철저한 구현이 함께 이루어져야 합니다. 온콜 알림 워크플로를 현대화하고자 하는 엔지니어링 리더라면 Canvas Developers와 협력하실 수 있습니다. 귀사의 플랫폼 요구사항을 논의하거나 범위가 지정된 아키텍처 진단을 요청하시려면 https://www.canvasdevelopers.com/contact의 문의 양식을 통해 문의해 주시기 바랍니다.