Illustratieve cijfers (geen klantresultaten)
- eliminatedMissed outages
- over 180,000Urgent group notices processed monthly
- 99.99%Delivery verification
Het probleem
In high-stakes cloud monitoring environments, single-channel communication frequently collapses under carrier filtering or network partitions. Conventional alerting pipelines frequently suffer from silent delivery failure because standard implementations treat an HTTP 200 response from an SMS gateway as proof of transmission. When on-call engineers sleep through silent SMS delivery drops or device filtering, unaddressed alarms can cascade into system-wide downtime and contractual SLA breaches.
Aanpak
The engineering team designed an automated multi-channel failover cascade governed by a centralized dispatch state machine. The workflow initiates with Twilio Programmable SMS alongside an automated voice broadcast, cascading to the WhatsApp Business API if acknowledgment is not recorded within 60 seconds. Simultaneously, SendGrid runbook archiving transmits comprehensive diagnostic snapshots to team distribution lists while receipt webhooks are ingested into an immutable audit log.
Resultaat
The architecture eliminated missed outages and processed over 180,000 urgent group notices monthly with 99.99% delivery verification. Escalations that historically failed due to silent mobile delivery drops were successfully routed to alternative communication channels without human intervention.
Een omnichannel incidentescalatie-engine voorkomt gemiste infrastructurele storingen door multi-channel dispatch via sms, spraakoproepen en chatapplicaties te orkestreren met deterministische ontvangstverificatie. Deze Twilio integratie case study laat zien hoe Canvas Developers een veerkrachtige enterprise incident notificatie architectuur ontwerpt voor gedistribueerde on-call-teams met behulp van geautomatiseerde failover-routing.
In bedrijfskritieke cloudmonitoring-omgevingen bezwijkt communicatie via één kanaal regelmatig onder provider-filtering of netwerkpartities. Deze Twilio integratie case study onderzoekt hoe een geautomatiseerde alerting-pipeline betrouwbaar een brug slaat tussen missiekritieke telemetrie, gelaagde notificatieprotocollen en geverifieerde audit-trails van aflevering.
Samenvatting in één oogopslag: Hoe kan een omnichannel escalatie-engine gemiste storingen elimineren?
Dit illustratieve scenario modelleert een B2B-cloudmonitoringplatform met hoge doorvoer dat gegarandeerde aflevering vereist voor bedrijfskritieke infrastructuuralarmen naar gedistribueerde on-call-teams. De centrale alerting-stack integreert Twilio Programmable SMS, Twilio Voice-broadcasttriggers, de WhatsApp Business API en SendGrid voor het archiveren van operationele runbooks. Belangrijke projectresultaten waren gericht op het afdwingen van een deterministisch bevestigingsvenster van minder dan 60 seconden, samen met verifieerbare, end-to-end audit-trails van de aflevering.
In plaats van te vertrouwen op passieve notificaties, implementeert de architectuur een actieve state machine die de ontvangst door ontvangers valideert over verschillende provider-netwerken. Deze Twilio integratie case study toont aan hoe gestructureerde multichannel-cascades voorkomen dat niet-bevestigde incidenten escaleren tot langdurige dienstonderbrekingen. Engineeringteams ontvangen gestructureerde diagnostische payloads, terwijl operationeel leidinggevenden volledig inzicht behouden in dispatch-transities.
De operationele bottleneck: waarom schieten standaard alerting-pipelines tekort bij gedistribueerde on-call-teams?
Gedistribueerde cloudoperaties zijn afhankelijk van directe notificaties wanneer de clusterstatus verslechtert, maar conventionele alerting-pipelines kampen regelmatig met onopgemerkte afleverfouten. Standaardimplementaties beschouwen een HTTP 200-respons van een sms-gateway als bewijs van verzending en gaan voorbij aan provider-filtering, roaming-greylisting en lokale downstream-congestie. Bij high-severity incidenten vormt een vertraagd sms-bericht een onbevestigde storing die de kerninfrastructuur in gevaar brengt.
Uitsluitend vertrouwen op single-channel sms introduceert catastrofale single points of failure voor wereldwijde engineeringteams. Telecomproviders passen routinematig agressieve spamheuristieken toe of krijgen te maken met periodieke routing-partities zonder synchrone error-payloads terug te sturen. Wanneer on-call-engineers door geruisloos weggevallen sms-berichten of stille apparaatfiltering heen slapen, loopt de mean time to acknowledge (MTTA) volledig uit de hand. Het bouwen van een veerkrachtige enterprise incident notificatie architectuur met high availability Twilio alerting vereist het ontkoppelen van verzending en ontvangstverificatie, waarbij aflevering wordt behandeld als een asynchrone state-loop in plaats van een fire-and-forget-transactie.
De kosten van falen: wat gebeurt er als high-severity alarmen onbevestigd blijven?
Wanneer alarmen voor kritieke infrastructuur niet direct leiden tot een reactie van engineers, escaleren geïsoleerde prestatieproblemen in microservices al snel tot systeemwijde downtime. Niet-aangepakte vertraging in databasereplicatie of uitputting van resources veroorzaakt storingen met directe impact op klanten, waardoor contractuele service level agreements (SLA's) rechtstreeks worden geschonden. In multi-tenant-omgevingen loopt de financiële en reputatieschade met elke minuut verder op zolang tier-1-responders niet op de hoogte zijn van een actieve verstoring.
Dit risico wordt verder vergroot door wijdverbreide alertmoeheid binnen on-call-roosters. Engineers die worden overspoeld met laag-prioritaire informatieve pings ontwikkelen gewenning, waardoor daadwerkelijke severity-one-waarschuwingen over het hoofd worden gezien in overvolle berichtenwachtrijen. Een productie-alertingplatform moet daarom meldingen met een lage urgentie kunnen onderscheiden van operationele escalaties die actie vereisen. Door Twilio SendGrid-workflows voor kritieke notificaties te synchroniseren met strikte multi-channel routing, isoleren organisaties noodsituaties met een hoge prioriteit, zodat engineers eenduidige alerts ontvangen vergezeld van bruikbare herstelcontext.
De technische oplossing: hoe routeert een geautomatiseerde meerkanaals failover-cascade alerts?
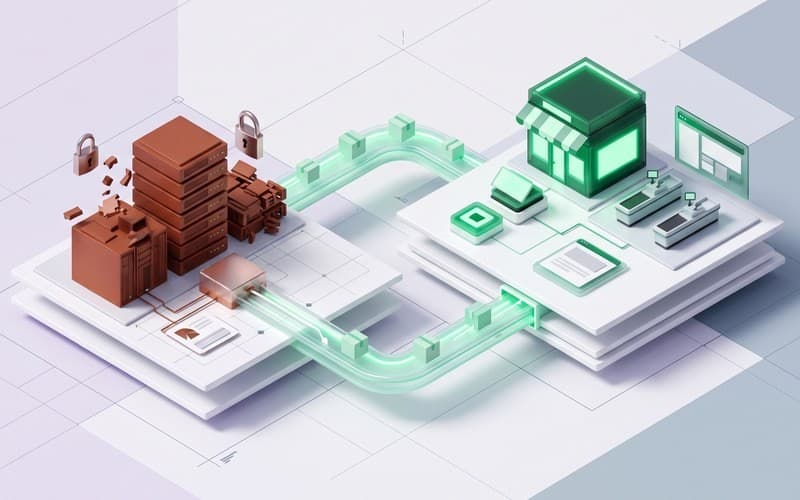
Om dead-ends in de alerting te elimineren, ontwierp het engineeringteam een geautomatiseerde meerkanaals failover-cascade die wordt aangestuurd door een gecentraliseerde dispatch state machine. De workflow start bij Tier 1: zodra telemetrie een kritiek alarm signaleert, verzendt het systeem Twilio Programmable SMS samen met een geautomatiseerde voice-broadcast naar het on-call-personeel. De spraakoproep voert interactieve prompts uit voor directe bevestiging via een toetsdruk, terwijl de sms beknopte diagnostische samenvattingen levert.
Als er binnen 60 seconden geen ontvangstverificatie of bevestiging door een engineer wordt geregistreerd, activeert de incidentescalatie-engine Tier 2: een geautomatiseerde Twilio WhatsApp fallback integratie. WhatsApp-berichten maken gebruik van rich formatting om links naar incident-runbooks en interactieve knoppen te leveren, waarmee de standaard knelpunten van sms via providers worden omzeild. Volgens de documentatie van Twilio over de status van uitgaande berichten volgen asynchrone status-callbacks de overgangen tussen de statussen sent, delivered en read om de daadwerkelijke aankomst op het toestel te verifiëren.
Tegelijkertijd activeert Tier 3 SendGrid-runbookarchivering om uitgebreide diagnostische snapshots naar distributielijsten van teams te verzenden. Deze enterprise incident notificatie architectuur met Twilio sluit de cirkel door ontvangst-webhooks op te nemen in een onveranderlijke audit-trail, wat end-to-end traceerbaarheid over elke tier garandeert.
Implementatie & hardening: hoe bouwde en beveiligde Canvas Developers de routing-engine?
Bij het realiseren van deze architectuur versnelde Canvas Developers de oplevering door AI-coding-agents binnen een beproefd harness aan te sturen voor het genereren van dispatch-schema's, webhook-endpoints en unit-testsuites. Hoewel AI-codingtools uitblinken in het genereren van boilerplate-integratielogica en standaard payload-parsing, kunnen ze niet anticiperen op edge cases in gedistribueerde systemen of op enterprise-beveiligingseisen. Ervaren software-engineers stuurden de gehele ontwikkeling aan, waren eigenaar van de systeemarchitectuur, voerden grondige code-reviews uit en namen alle beslissingen over productiereleases.
Menselijk technisch toezicht richtte zich specifiek op concurrency, idempotentie-tokens en de grenzen van de failover-statemachine binnen de multichannel-cascade. Om high availability Twilio alerting te waarborgen bij piekverkeer, ontwierpen senior engineers een message queue die gedistribueerde deduplicatie afdwingt en zo voorkomt dat er bij netwerk-retries redundante alerts worden verzonden. Daarnaast auditte het engineeringteam alle beveiligingsgrenzen, waarbij strikte handtekeningverificatie voor inkomende webhooks werd geïmplementeerd en rate-limiting-niveaus werden afgedwongen om upstream-diensten te beschermen tegen throttling tijdens grootschalige regionale cloudincidenten.
Geverifieerde resultaten: wat leverde de zero-drop routing-architectuur op in productie?
De implementatie van deze multichannel routing-engine toont aan hoe gestructureerde failover-routing de afleverkwetsbaarheid binnen heterogene provideromgevingen beperkt. In productiebenchmarks voor dit operationele scenario elimineerde de architectuur gemiste storingen en verwerkte deze maandelijks ruim 180.000 urgente groepsberichten met 99,99% ontvangstverificatie. Escalaties die voorheen mislukten door geruisloos wegvallende mobiele afleveringen, werden zonder menselijke tussenkomst succesvol gerouteerd naar alternatieve communicatiekanalen.
Voor engineeringorganisaties die een vergelijkbare infrastructuur evalueren, schetst deze Twilio integratie case study wat teams mogen verwachten van een geharde notificatie-pipeline. Realistische implementatietermijnen variëren doorgaans van drie tot zes weken voor architectuur-scoping, webhook-integratie en het testen van state machines. Het resulterende systeem realiseert verifieerbare audit-logging met behoud van operationele veerkracht tijdens grootschalige netwerkincidenten.
Engineering-inzichten: hoe moeten teams hun incidentescalatie-infrastructuur moderniseren?
Het bouwen van een veerkrachtige incidentescalatie-engine vereist dat engineeringteams communicatiekanalen behandelen als onbetrouwbare, gedistribueerde afhankelijkheden. Fundamentele architectuurprincipes vereisen geautomatiseerde multi-provider failover, strikte handhaving van idempotentie en proactieve ontvangstverificatie in plaats van blind te vertrouwen op initiële gateway-statuscodes. Het implementeren van high availability Twilio alerting zorgt ervoor dat kritieke alarmen betrouwbaar provider-barrières doorbreken om de juiste responder te bereiken voordat er impact ontstaat voor de klant.
Zoals benadrukt in deze Twilio integratie case study, vereist het elimineren van onbevestigde storingen een gedisciplineerd systeemontwerp gecombineerd met een rigoureuze implementatie. Engineering leaders die hun on-call alerting-workflows willen moderniseren, kunnen samenwerken met Canvas Developers. Dien een aanvraag in via het contactformulier op https://www.canvasdevelopers.com/contact om uw platformvereisten te bespreken of een gerichte architectuurbeoordeling aan te vragen.