Chiffres illustratifs (pas des résultats clients)
- eliminatedMissed outages
- over 180,000Urgent group notices processed monthly
- 99.99%Delivery verification
Le problème
In high-stakes cloud monitoring environments, single-channel communication frequently collapses under carrier filtering or network partitions. Conventional alerting pipelines frequently suffer from silent delivery failure because standard implementations treat an HTTP 200 response from an SMS gateway as proof of transmission. When on-call engineers sleep through silent SMS delivery drops or device filtering, unaddressed alarms can cascade into system-wide downtime and contractual SLA breaches.
Approche
The engineering team designed an automated multi-channel failover cascade governed by a centralized dispatch state machine. The workflow initiates with Twilio Programmable SMS alongside an automated voice broadcast, cascading to the WhatsApp Business API if acknowledgment is not recorded within 60 seconds. Simultaneously, SendGrid runbook archiving transmits comprehensive diagnostic snapshots to team distribution lists while receipt webhooks are ingested into an immutable audit log.
Résultat
The architecture eliminated missed outages and processed over 180,000 urgent group notices monthly with 99.99% delivery verification. Escalations that historically failed due to silent mobile delivery drops were successfully routed to alternative communication channels without human intervention.
Un moteur d'escalade d'incidents omnicanal élimine les pannes d'infrastructure non détectées en orchestrant une diffusion multicanale par SMS, appels vocaux et applications de messagerie avec une vérification déterministe de réception. Cette étude de cas intégration Twilio démontre comment Canvas Developers conçoit des architectures d'alerte résilientes pour les équipes d'astreinte distribuées grâce à un routage de secours (failover) automatisé.
Dans les environnements critiques de supervision cloud, la communication monocanal s'effondre fréquemment face au filtrage opérateur ou aux partitions réseau. Cette étude de cas d'intégration Twilio examine comment un pipeline automatisé relie de manière fiable la télémétrie stratégique, les protocoles de notification multiniveaux et les pistes d'audit de distribution vérifiées.
Synthèse en un coup d'œil : comment un moteur d'escalade d'incidents omnicanal peut-il éliminer les pannes manquées ?
Ce scénario illustratif modélise une plateforme de surveillance cloud B2B à haut débit nécessitant une distribution garantie pour les alarmes d'infrastructure critiques destinées à des équipes d'astreinte réparties. Le cœur de la pile d'alertes intègre Twilio Programmable SMS, les déclencheurs de diffusion Twilio Voice, l'API WhatsApp Business et SendGrid pour l'archivage opérationnel des runbooks. Les principaux livrables du projet se sont concentrés sur l'application d'une fenêtre d'acquittement déterministe inférieure à 60 secondes, associée à des pistes d'audit de distribution vérifiables de bout en bout.
Plutôt que de s'appuyer sur des notifications passives, l'architecture d'alertes Twilio met en œuvre une machine à états active qui valide la réception par le destinataire sur des réseaux d'opérateurs hétérogènes. Cette étude de cas intégration Twilio démontre comment des cascades multicanales structurées empêchent les incidents non acquittés d'évoluer en interruptions de service prolongées. Les équipes d'ingénierie reçoivent des payloads de diagnostic structurés, tandis que les responsables opérationnels conservent une visibilité totale sur les transitions d'acheminement.
Le goulot d'étranglement opérationnel : pourquoi les pipelines d'alerte classiques font-ils défaut aux équipes d'astreinte distribuées ?
Les opérations cloud distribuées reposent sur une notification immédiate dès que l'état d'un cluster se dégrade ; pourtant, les pipelines d'alerte conventionnels souffrent fréquemment d'échecs de distribution silencieux. Les implémentations standard considèrent une réponse HTTP 200 émise par une passerelle SMS comme une preuve de transmission, sans tenir compte du filtrage opérateur, du greylisting en itinérance ni de la congestion localisée en aval. Lors d'incidents de criticité élevée, un SMS retardé équivaut à une interruption de service non acquittée qui met en péril l'infrastructure centrale.
Se reposer exclusivement sur le SMS monocanal introduit des points uniques de défaillance critiques au sein des cohortes d'ingénierie réparties dans le monde. Les opérateurs télécoms appliquent couramment des heuristiques anti-spam agressives ou subissent des ruptures de routage intermittentes sans renvoyer de charge utile d'erreur synchrone. Lorsque des ingénieurs d'astreinte ne sont pas alertés en raison de pertes silencieuses de distribution SMS ou d'un filtrage discret au niveau du terminal, le temps moyen d'acquittement (MTTA) dérive de manière incontrôlable. Bâtir une architecture alertes Twilio d'entreprise résiliente exige de découpler la transmission de la vérification de distribution, en gérant cette dernière comme une boucle d'état asynchrone plutôt que comme une transaction sans confirmation (« fire-and-forget »).
Le coût de l'échec : que se passe-t-il lorsque des alarmes de criticité élevée ne sont pas prises en compte ?
Lorsque les alarmes des infrastructures critiques ne déclenchent pas une réaction immédiate des ingénieurs, les états dégradés de microservices isolés se répercutent rapidement en cascade, provoquant une interruption générale du système. Un retard de réplication de base de données non traité ou l'épuisement des ressources engendre des pannes affectant les clients, en violation directe des accords contractuels sur les niveaux de service (SLA). Dans les environnements multi-tenants, les répercussions financières et réputationnelles s'amplifient à chaque minute durant laquelle les intervenants de premier niveau ignorent l'existence d'un incident en cours.
À ce risque s'ajoute une fatigue liée aux alertes omniprésente au sein des équipes d'astreinte. Submergés de notifications informatives de faible priorité, les ingénieurs finissent par s'y accoutumer, laissant ainsi passer inaperçus de véritables avertissements de criticité 1 dans des files d'attente de messages encombrées. Une plateforme d'alerte en production doit donc distinguer les notifications de faible urgence du routage des alertes et de l'escalade d'incidents opérationnels. En synchronisant les flux de notification critique Twilio SendGrid avec un routage multicanal strict, les organisations isolent les urgences de haute priorité, garantissant ainsi que les ingénieurs reçoivent des alertes sans équivoque, accompagnées d'un contexte de remédiation directement exploitable.
La solution technique : comment une cascade de basculement multicanal route-t-elle les alertes ?
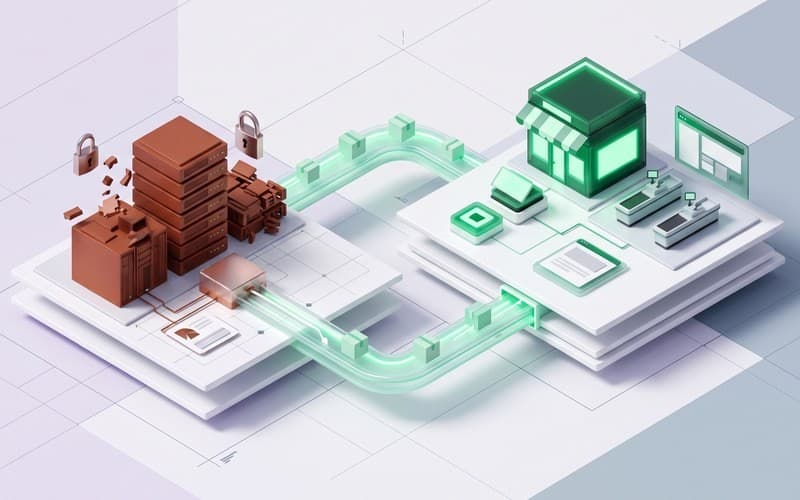
Pour éliminer les impasses d'alerte, l'équipe d'ingénierie a conçu une cascade de basculement multicanal automatisée, pilotée par une machine à états de distribution centralisée. Le flux de travail s'enclenche au palier 1 : dès que la télémétrie signale une alarme de criticité élevée, le système envoie un SMS Twilio Programmable ainsi qu'une diffusion vocale automatisée au personnel d'astreinte. L'appel vocal exécute des invites interactives pour un acquittement immédiat par touche téléphonique, tandis que le SMS transmet des synthèses de diagnostic concises.
Si aucune confirmation de réception ni aucun acquittement de l'ingénieur n'est enregistré dans les 60 secondes, le moteur déclenche le palier 2 : une intégration Twilio WhatsApp fallback automatisée. Les messages WhatsApp exploitent le formatage enrichi pour fournir des liens vers les runbooks d'incidents et des boutons interactifs, contournant ainsi les goulots d'étranglement habituels des SMS opérateurs. Selon la documentation de Twilio sur le statut des messages sortants, des callbacks de statut asynchrones suivent les transitions entre les états sent, delivered et read afin de vérifier la réception effective sur le terminal.
Simultanément, le palier 3 active l'archivage de runbooks SendGrid afin de transmettre des instantanés de diagnostic complets aux listes de diffusion des équipes. Cette architecture d'alertes Twilio d'entreprise boucle la boucle en intégrant les webhooks de réception dans un journal d'audit immuable, garantissant une traçabilité de bout en bout à chaque palier.
Mise en œuvre & durcissement : comment Canvas Developers a conçu et sécurisé le moteur de routage ?
Lors de la mise en œuvre de cette architecture d'alertes Twilio, Canvas Developers a accéléré la livraison en guidant des agents de codage IA au sein d'un cadre établi afin de générer les schémas de distribution, les points de terminaison de webhooks et les suites de tests unitaires. Si les outils de codage par IA excellent dans la génération de logique d'intégration standard (boilerplate) et l'analyse des charges utiles classiques, ils ne peuvent anticiper les cas limites propres aux systèmes distribués ni les exigences de sécurité d'entreprise. Des ingénieurs logiciels expérimentés ont supervisé l'ensemble du développement, assuré la maîtrise de l'architecture système, mené des revues de code rigoureuses et pris toutes les décisions de mise en production.
La supervision technique humaine s'est concentrée spécifiquement sur la concurrence, les jetons d'idempotence et les limites de la machine à états de basculement au sein de la cascade de basculement multicanal. Pour maintenir des alertes haute disponibilité Twilio en cas de pic de trafic, des ingénieurs seniors ont conçu une file d'attente de messages qui applique une déduplication distribuée, empêchant l'envoi d'alertes redondantes lors des nouvelles tentatives réseau. De plus, l'équipe d'ingénierie a audité l'ensemble des périmètres de sécurité, en mettant en œuvre une vérification stricte des signatures pour les webhooks entrants et en appliquant des paliers de limitation de débit afin de protéger les services en amont contre tout bridage lors d'incidents cloud régionaux majeurs.
Résultats vérifiés : qu'a apporté l'architecture de routage sans perte (zero-drop) en production ?
Le déploiement de ce moteur de routage multicanal démontre comment un routage de secours (failover) structuré permet d'atténuer la vulnérabilité de la distribution au sein d'environnements opérateurs hétérogènes. Lors des bancs d'essai en production pour ce scénario opérationnel, l'architecture a éliminé les pannes non signalées et a traité plus de 180 000 notifications de groupe urgentes par mois avec un taux de vérification de distribution de 99,99 %. Les escalades qui échouaient auparavant en raison de pertes silencieuses de distribution mobile ont été acheminées avec succès vers des canaux de communication alternatifs, sans intervention humaine.
Pour les organisations d'ingénierie évaluant une infrastructure similaire, cette étude de cas intégration Twilio détaille ce que les équipes peuvent attendre d'un pipeline de notification renforcé. Les délais de mise en œuvre réalistes s'échelonnent généralement de trois à six semaines pour le cadrage de l'architecture, l'intégration des webhooks et les tests de machines à états. Le système ainsi déployé établit des pistes d'audit vérifiables tout en assurant une résilience opérationnelle lors d'incidents réseau de grande ampleur.
Enseignements pour l'ingénierie : comment les équipes doivent-elles moderniser leur infrastructure d'escalade d'incidents ?
Bâtir un moteur d'escalade d'incidents résilient exige des équipes d'ingénierie qu'elles traitent les canaux de communication comme des dépendances distribuées non fiables. Les principes architecturaux fondamentaux imposent un basculement multi-fournisseur automatisé, une application stricte de l'idempotence et une vérification proactive de la réception plutôt que de se fier aux codes d'état initiaux de la passerelle. La mise en œuvre d'alertes haute disponibilité Twilio garantit que les alarmes critiques franchissent de manière fiable les barrières des opérateurs pour atteindre le bon intervenant avant tout impact client.
Comme le souligne cette étude de cas intégration Twilio, éliminer les pannes non acquittées exige une conception système rigoureuse associée à une implémentation méthodique. Les responsables de l'ingénierie souhaitant moderniser les flux d'alerte des équipes d'astreinte peuvent collaborer avec Canvas Developers. Pour échanger sur les exigences de votre plateforme ou demander une évaluation d'architecture ciblée, soumettez votre demande via le formulaire de contact sur https://www.canvasdevelopers.com/contact.