Números ilustrativos (não são resultados de clientes)
- eliminatedMissed outages
- over 180,000Urgent group notices processed monthly
- 99.99%Delivery verification
O problema
In high-stakes cloud monitoring environments, single-channel communication frequently collapses under carrier filtering or network partitions. Conventional alerting pipelines frequently suffer from silent delivery failure because standard implementations treat an HTTP 200 response from an SMS gateway as proof of transmission. When on-call engineers sleep through silent SMS delivery drops or device filtering, unaddressed alarms can cascade into system-wide downtime and contractual SLA breaches.
Abordagem
The engineering team designed an automated multi-channel failover cascade governed by a centralized dispatch state machine. The workflow initiates with Twilio Programmable SMS alongside an automated voice broadcast, cascading to the WhatsApp Business API if acknowledgment is not recorded within 60 seconds. Simultaneously, SendGrid runbook archiving transmits comprehensive diagnostic snapshots to team distribution lists while receipt webhooks are ingested into an immutable audit log.
Resultado
The architecture eliminated missed outages and processed over 180,000 urgent group notices monthly with 99.99% delivery verification. Escalations that historically failed due to silent mobile delivery drops were successfully routed to alternative communication channels without human intervention.
Um mecanismo de escalonamento de incidentes omnichannel elimina interrupções de infraestrutura não detectadas ao orquestrar disparos multicanal por SMS, chamadas de voz e aplicativos de mensagens com confirmação de recebimento determinística. Este estudo de caso integração Twilio demonstra como a Canvas Developers projeta arquiteturas de alertas resilientes para equipes de plantão (on-call) distribuídas utilizando roteamento automatizado de failover.
Em ambientes críticos de monitoramento em nuvem, a comunicação por canal único frequentemente entra em colapso devido à filtragem de operadora ou a partições de rede. Este estudo de caso de integração com a Twilio analisa como um pipeline automatizado conecta de forma confiável a telemetria de missão crítica, protocolos de notificação em várias camadas e trilhas de auditoria de entrega verificada.
Visão geral: como um mecanismo de escalonamento de incidentes omnichannel pode eliminar interrupções não detectadas?
Este cenário ilustrativo modela uma plataforma de monitoramento em nuvem B2B de alto rendimento, que exige alta disponibilidade de alertas Twilio e entrega garantida para alarmes de alta severidade na infraestrutura de missão crítica entre equipes de plantão (on-call) distribuídas. A pilha central de alertas integra Twilio Programmable SMS, disparadores de transmissão via Twilio Voice, a integração Twilio WhatsApp fallback por meio da WhatsApp Business API e notificações críticas Twilio SendGrid para o arquivamento de runbooks operacionais. As principais entregas do projeto concentraram-se em assegurar uma janela determinística de confirmação inferior a 60 segundos, juntamente com trilhas de auditoria de entrega verificáveis de ponta a ponta.
Em vez de depender de notificações passivas, a arquitetura de alertas Twilio enterprise implementa uma máquina de estados ativa que valida a confirmação de recebimento pelos destinatários em diferentes redes de operadoras. Este estudo de caso integração Twilio demonstra como cascatas de failover multicanal estruturadas atuam no escalonamento de incidentes e failover, evitando que ocorrências não confirmadas evoluam para interrupções prolongadas de serviço. As equipes de engenharia recebem payloads de diagnóstico estruturados, enquanto os líderes de operações mantêm visibilidade total sobre as transições de envio.
O gargalo operacional: por que os pipelines de alerta padrão falham com equipes de plantão (on-call) distribuídas?
Operações distribuídas em nuvem dependem de notificação imediata quando a integridade do cluster se degrada, mas os pipelines convencionais de alertas frequentemente sofrem com falhas silenciosas de entrega. Implementações padrão tratam uma resposta HTTP 200 de um gateway de SMS como prova de transmissão, ignorando a filtragem de operadora, o greylisting em roaming e o congestionamento downstream localizado. Em incidentes de alta severidade, uma mensagem de texto atrasada representa uma interrupção não reconhecida que compromete a infraestrutura central.
Depender exclusivamente de SMS como canal único introduz pontos únicos de falha catastróficos em equipes globais de engenharia. Operadoras de telecomunicações aplicam rotineiramente heurísticas agressivas de spam ou enfrentam particionamentos intermitentes de rotas sem retornar payloads de erro síncronos. Quando engenheiros de plantão (on-call) não acordam devido a falhas silenciosas na entrega de SMS ou à filtragem silenciosa nos dispositivos, o tempo médio de reconhecimento (MTTA) sai de controle. Construir uma arquitetura de alertas Twilio enterprise resiliente exige desacoplar a transmissão da confirmação de recebimento, tratando a entrega como um loop de estado assíncrono em vez de uma transação do tipo fire-and-forget.
O Custo da Falha: O Que Acontece Quando Alarmes de Alta Severidade Não São Reconhecidos?
Quando alarmes de infraestrutura crítica não acionam uma resposta imediata dos engenheiros, estados isolados de degradação em microsserviços evoluem rapidamente em cascata para uma indisponibilidade generalizada do sistema. O atraso não tratado na replicação de bancos de dados ou o esgotamento de recursos provocam interrupções que afetam diretamente os clientes, violando acordos de nível de serviço (SLAs) contratuais. Em ambientes multi-tenant, o impacto financeiro e reputacional se acumula a cada minuto em que as equipes de resposta de nível 1 permanecem sem ciência de uma interrupção ativa.
Agravando esse risco está a fadiga generalizada de alertas entre as equipes de plantão (on-call). Engenheiros sobrecarregados por pings informativos de baixa prioridade desenvolvem habituação, fazendo com que avisos legítimos de severidade 1 passem despercebidos em filas de mensagens saturadas. Portanto, uma plataforma de alertas em produção deve distinguir notificações de baixa urgência de um escalonamento operacional acionável. Ao sincronizar fluxos de trabalho de notificações críticas Twilio SendGrid com um rigoroso roteamento multicanal, as organizações isolam emergências de alta prioridade, garantindo que os engenheiros recebam alertas inequívocos acompanhados de contexto acionável para correção.
A Solução Técnica: Como uma Cascata de Failover Multicanal Automatizada Faz o Roteamento de Alertas?
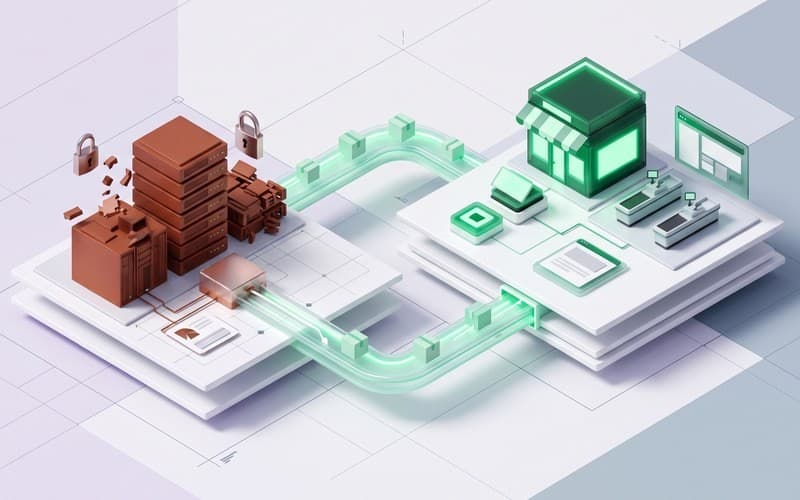
Para eliminar becos sem saída no envio de alertas, a equipe de engenharia projetou uma cascata de failover multicanal automatizada governada por uma máquina de estados de despacho centralizada. O fluxo de trabalho é iniciado no Nível 1: no instante em que a telemetria sinaliza um alarme de alta severidade, o sistema dispara o Twilio Programmable SMS junto com uma transmissão de voz automatizada para as equipes de plantão (on-call). A chamada de voz executa comandos interativos para confirmação imediata via teclado, enquanto o SMS fornece resumos diagnósticos concisos.
Se a confirmação de recebimento ou o reconhecimento do engenheiro não forem registrados em até 60 segundos, o mecanismo de escalonamento de incidentes aciona o Nível 2: uma integração Twilio WhatsApp fallback automatizada. As mensagens do WhatsApp utilizam recursos de formatação avançada para entregar links de runbooks de incidentes e botões interativos, contornando os gargalos padrão de SMS das operadoras. De acordo com a documentação de status de mensagens de saída da Twilio, callbacks assíncronos de status rastreiam as transições entre os estados enviado (sent), entregue (delivered) e lido (read) para verificar a chegada real ao aparelho.
Simultaneamente, o Nível 3 ativa o arquivamento de runbooks para notificações críticas Twilio SendGrid, transmitindo snapshots diagnósticos abrangentes para as listas de distribuição da equipe. Essa arquitetura de alertas Twilio enterprise fecha o ciclo ao ingerir webhooks de confirmação de recebimento em uma trilha de auditoria imutável, garantindo rastreabilidade de ponta a ponta em todos os níveis.
Implementação & Hardening: Como a Canvas Developers Construiu e Protegeu o Mecanismo de Roteamento?
Na execução dessa arquitetura, a Canvas Developers acelerou a entrega ao orientar agentes de programação com IA dentro de uma estrutura estabelecida para gerar esquemas de disparo, endpoints de webhook e suítes de testes unitários. Embora as ferramentas de codificação com IA se destaquem na geração de lógica boilerplate de integração e no parsing padrão de payloads, elas não conseguem prever casos extremos de sistemas distribuídos nem requisitos de segurança corporativa. Engenheiros de software experientes lideraram todo o desenvolvimento, assumiram a responsabilidade pela arquitetura do sistema, conduziram revisões rigorosas de código e tomaram todas as decisões de publicação em produção.
A supervisão da engenharia humana concentrou-se especificamente em concorrência, tokens de idempotência e nos limites da máquina de estados de failover ao longo da cascata multicanal. Para garantir alta disponibilidade de alertas Twilio sob tráfego em rajadas, engenheiros sêniores projetaram uma fila de mensagens que aplica a deduplicação distribuída, prevenindo disparos redundantes de alertas durante novas tentativas de conexão na rede. Além disso, a equipe de engenharia auditou todos os perímetros de segurança, implementando uma verificação rigorosa de assinaturas para webhooks de entrada e aplicando camadas de rate limiting para proteger os serviços upstream contra throttling durante incidentes de nuvem generalizados em escala regional.
Resultados comprovados: o que a arquitetura de roteamento com zero perdas (zero-drop) entregou em produção?
A implementação desse mecanismo de roteamento multicanal demonstra como o failover estruturado mitiga vulnerabilidades de entrega em ambientes heterogêneos de operadoras. Em benchmarks de produção para esse cenário operacional, a arquitetura eliminou incidentes de indisponibilidade não detectados e processou mensalmente mais de 180.000 notificações urgentes de grupos com 99,99% de confirmação de recebimento. Os fluxos de escalonamento de incidentes com failover que historicamente falhavam devido a descartes silenciosos de entrega móvel foram roteados com sucesso para canais alternativos de comunicação, sem intervenção humana.
Para organizações de engenharia que avaliam uma infraestrutura semelhante, este estudo de caso integração Twilio descreve o que as equipes podem esperar de um pipeline de notificações reforçado. Prazos realistas de implementação costumam variar de três a seis semanas para definição do escopo da arquitetura, integração de webhooks e testes da máquina de estados. O sistema resultante estabelece uma trilha de auditoria verificável, mantendo a resiliência operacional durante eventos de rede em grande escala.
Lições de engenharia: como as equipes devem modernizar sua infraestrutura de escalonamento de incidentes?
Construir um mecanismo de escalonamento de incidentes resiliente exige que as equipes de engenharia tratem os canais de comunicação como dependências distribuídas não confiáveis. Os princípios arquiteturais essenciais exigem failover automatizado entre múltiplos provedores no escalonamento de incidentes, aplicação rigorosa de idempotência e confirmação de recebimento proativa, em vez de confiar nos códigos de status iniciais dos gateways. A implementação de alta disponibilidade em alertas Twilio garante que alarmes críticos superem com confiabilidade as barreiras das operadoras para alcançar o responsável correto antes que haja impacto para o cliente.
Como destacado neste estudo de caso de integração Twilio, eliminar interrupções não reconhecidas exige um design de sistemas disciplinado aliado a uma implementação rigorosa. Líderes de engenharia que buscam modernizar seus fluxos de alertas para equipes de plantão (on-call) podem fazer parceria com a Canvas Developers. Para discutir os requisitos da sua plataforma ou solicitar uma avaliação de arquitetura com escopo definido, envie uma solicitação por meio do formulário de contato em https://www.canvasdevelopers.com/contact.