谁会需要可用性测试
你的团队对用户为何在某一步停滞各执一词,每种说法听起来都有道理。测试展示真实用户如何使用产品,让决策建立在你亲眼所见的事实之上。
- 即将发布只有内部人员试用过的改版的团队
- 在分析数据中看到漏斗流失、却找不到原因的产品经理
- 工单中反复描述同一流程里相同困惑的支持负责人
观看真实的人使用你的产品
团队对自己的产品太熟悉,以至于看不到新用户在哪里遇到困难。可用性测试直接把它展示出来:真实的人尝试真实的任务,同时研究员在旁观察。我们用与你的用户相匹配的参与者测试原型、预发布构建和线上产品,将我们所看到的与你允许我们使用的分析数据相结合,并报告哪里出了问题、为什么重要以及如何修复。测试可以作为一次独立的合作,包括针对另一团队构建的产品。
AI 辅助分析,研究员主导的测试
AI 如何协助
- 根据你的目标起草测试脚本、任务和筛选问题,供研究员进一步完善。
- 转录经同意的会话录制,并标记犹豫、出错和放弃任务的时刻。
- 将跨会话的观察归类为各个问题,每个问题都链接到其背后的片段和引述。
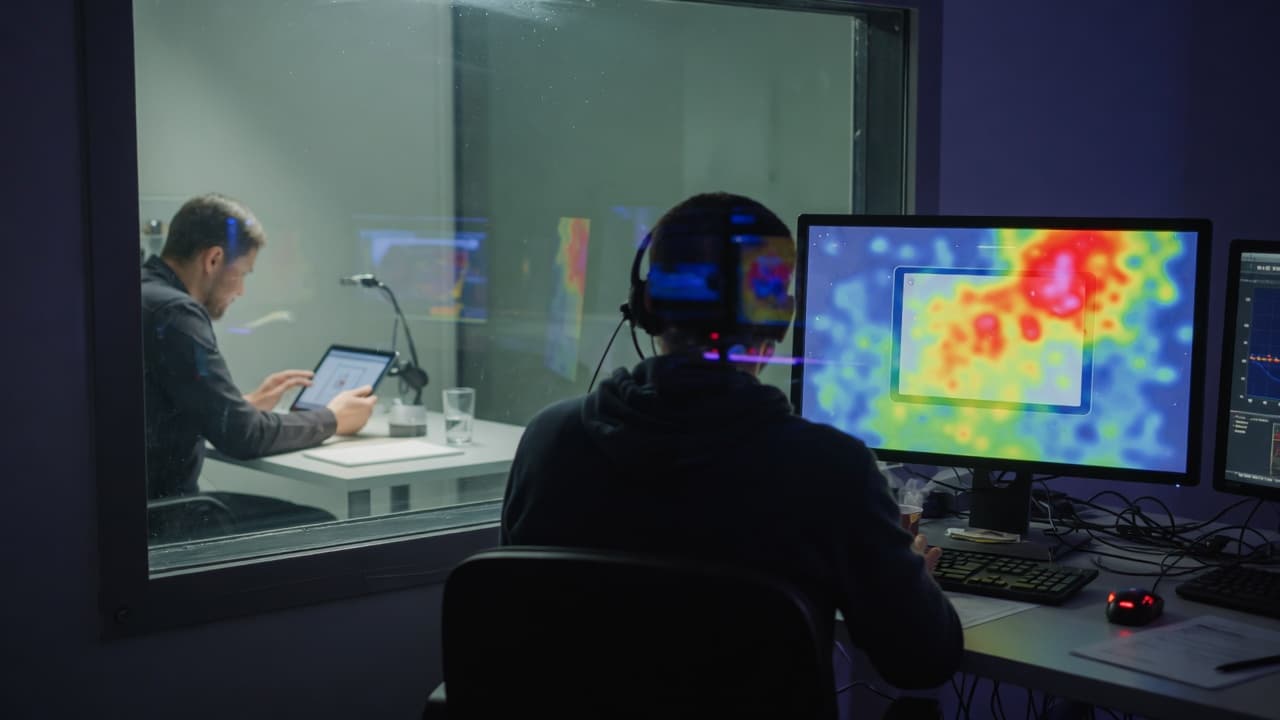
- 汇总你允许我们使用的热力图、漏斗和录制数据,以显示在哪里需要更仔细地查看。
我们的专家负责什么
- 参与者是与你的用户相匹配的真实的人,由研究员招募和主持,绝非 AI 模拟。
- 研究员对照录制核查每一个由 AI 标记的问题,并将观察到的行为与观点区分开来。
- 严重程度评级和建议来自审查过证据的研究员,而非来自模型。
- 使用屏幕阅读器和键盘导航的无障碍测试由人完成,而不仅仅依靠自动化扫描。
有主持人的可用性测试内部流程
典型的有主持人测试与分析;你的任务和严重程度评级量表会在测试计划中商定。
介绍与知情同意
主持人介绍本次测试并征求录制的同意;接受测试的是产品,而非参与者。
检查点: 只有在取得同意后才开始录制
热身
围绕他们的工作和现用工具提出一些简单问题,以便后续行为能放在具体情境中理解。
出声思考任务
参与者尝试完成贴近真实的任务并说出他们的预期;主持人会追问,但绝不暗示答案。
总结访谈
开放式地询问哪些地方感觉困难或出乎意料,以及参与者原本期待却没能找到的任何内容。
严重程度评级
跨所有测试,研究人员在录制中确认每个问题,并评定它对任务的阻碍程度。
检查点: 只有经确认的问题才会纳入调研结果
发现
每个经确认的问题都会连同其片段、它所阻碍的任务和建议的修复方案一并记录。
当出现故障时: 如果参与者卡住了,主持人会记录卡在哪里然后继续进行;一个停滞的任务是一项调研结果,而非一次失败的测试。
可用性研究如何开展
- 01
规划
我们共同确定要测试的内容、任务、成功标准和招募对象,以及知情同意和录制内容的存储与处理方式。
- 02
招募与测试
研究人员招募符合条件的参与者,在你的原型、预发布版本或正式产品上开展有主持人或无主持人的测试。
- 03
分析
AI 协助转录并标记测试过程。研究人员审阅录制内容,确认每个问题并评定其严重程度。
- 04
建议与再测试
结合片段讲解调研结果和建议的改进方案,如果你需要,还可在改动完成后进行一次跟进测试。
您将获得什么
可用性测试交付物
测试计划
目标、任务、成功标准和参与者画像,在招募开始前与你达成一致。
有主持的会话
实时远程会话,由研究员引导参与者完成任务并提出后续问题,以理解他们为何遇到困难。
无主持的测试
参与者独自完成任务,并录制屏幕和语音,以便在更多人中更快地获得解读。
行为分析回顾
你允许我们使用的热力图、漏斗和会话录制,显示用户在哪里流失、犹豫或重复步骤。
无障碍测试
映射到 WCAG 成功标准的键盘、屏幕阅读器、对比度和焦点检查,并附有复现每个问题的步骤。
发现报告
按严重程度排序的问题,附有视频片段、引述和推荐的修复,以及针对最严重问题的重新设计概念。
典型的可用性测试需求
我们所界定范围的典型场景,而非客户案例研究。
用户放弃的某个结账步骤
分析数据显示访客在交付步骤离开,团队对原因各有说法。我们邀请符合你客户特征的用户,在该步骤上开展有主持人的测试,并对照他们的实际行为检验每一种说法。
在预发布环境中已就绪的改版
一个新的引导流程在预发布环境中运行正常,但只有团队用过。我们让首次使用的用户在当前和新流程上完成相同任务,按严重程度评定每个问题,并标出发布前应修复的内容。
不同用户群组,同一款应用
办公室管理员和外勤人员使用同一款应用的方式大相径庭。我们对每个群组开展有主持人的测试,了解任务为何停滞,然后进行一轮无主持人测试,看相同问题的普遍程度如何。
用户测试不涵盖的内容
- 发现需求、动机和未被满足的问题属于 UX 研究;用户测试检验的是人们能否用某个设计或产品完成任务。
- 测试过程中看到的功能性缺陷会被上报,但系统性的功能和回归测试属于软件质量保证与测试。
- 我们不会用 AI 模拟用户替代真实参与者。如果某类专业受众难以招募,我们会与你一起调整计划。
- 无障碍性方面的调研结果会对应到 WCAG 标准以指导改进;它们并非对你产品的完整合规审计。
测试如何反哺设计、QA 和发布
经过设计和重新测试的修复
我们的设计师可以将发现转化为修订后的流程和原型,然后再次测试它们,这样你在修复被构建之前就知道它是否有效。
工程师可以复现的问题
每个问题都附带步骤、屏幕和片段,这样开发者,无论是我们的还是你们的,都可以着手处理,而无需长时间的往返沟通。
QA 循环中的可用性
关键任务和无障碍发现会成为 QA 检查项,这样你修复过的问题在每次发布前都会被再次检查。
测试在上线后仍会继续
在正式产品上进行多轮迭代,再结合分析数据和支持工单,就能看出改动是否奏效,以及下一处摩擦会出现在哪里。
常见问题
常见问题解答
我们应该测试多少名参与者?
这取决于你需要了解什么。要发现可用性问题,通常每个用户群组几名参与者就能揭示反复出现的问题,而且几次小规模的测试比一次大规模测试能带来更多收获。要用数字比较不同版本,则需要更大的样本量,往往采用无主持人形式。我们会在测试计划中根据你的问题和受众推荐合适的规模。
你们能测试其他团队开发的产品吗?
可以。我们能测试你的正式产品、预发布版本、原型,或用于对比的竞品。测试可以单独开展,不包含开发或托管。改进方案可以由我们团队设计,也可以交给你们的设计师和开发人员。
你们做 A/B 测试吗?
做,前提是流量足以得出明确结论。我们定义假设和成功衡量标准,由你们或我们的开发人员实现各个变体,然后与你一起分析结果。在流量较低时,有主持人的测试通常能更快、更清晰地回答问题。
使用 AI 工具时,如何处理测试录制和个人数据?
在录制任何内容之前,参与者都会先知情同意。我们共同确定可以使用哪些录制内容和分析数据,尽可能屏蔽或删除个人信息,并且只使用你同意的 AI 工具。处理遵循我们两种开发套餐之一:私有 / 本地 AI 工程,基于私有托管的模型;或 Claude Code / OpenAI Codex 工程,使用商业供应商,并采用约定的账户和保留设置。